Дайджест за 25 октября 2026
В центре внимания утра – критическая уязвимость PHP, требующая срочного обновления по требованию ФСБ, и историческая история криптографической ошибки Sony, которая открыла PS3 для хакеров. Для разработчиков важны подводные камни BigDecimal при работе с деньгами в Java и архитектурные различия между RAG и Agentic RAG подходами. Также на повестке дня – как Meta инвестирует миллиарды в ИИ, и любопытный взгляд на то, может ли муха с её коннектомом читать Хабр.
Главное
- Как Sony сама подарила PS3 хакерам: история криптографической ошибки
- Подводные камни BigDecimal в Java при работе с деньгами
- НКЦКИ при ФСБ потребовал срочно обновить PHP с критическими уязвимостями
- Реверс-инжиниринг приборной панели автобуса: запуск дисплея KAntrak 2710
- Коннектом дрозофилы против случайного мозга: может ли муха читать Хабр
Подробно
Коннектом дрозофилы против случайного мозга: может ли муха читать Хабр
ИИ и агенты · Habr · 8/10
Статья проверяет, способен ли полностью расшифрованный мозг плодовой мушки (138 639 нейронов, 15 млн связей) на самом деле понимать информацию или сигнал просто красиво распространяется по нейронам. Автор тестирует коннектом на задаче классификации статей Хабра по хабам, кодируя текст через запахи (каждое слово соответствует комбинации обонятельных рецепторов мухи). Ключевой результат неожиданный: настоящий мозг мухи проигрывает как перемешанному (связи случайно переставлены), так и полностью случайному мозгу генератора. В грибовидном теле (центре памяти) перемешанный мозг угадывает хаб на 20 пункта лучше (66% vs 45%), хотя оба видят одно и то же на входе. Причина парадокса найдена: в реальном мозге мухи сигналы от 2 279 рецепторов перемешиваются через 53 узелка сортировки, где теряется информация. Случайный мозг избегает этого узкого места, пуская сигналы напрямую в каждую клетку. Статья содержит расчеты на обычном ноутбуке, графики активности нейронов по слоям и таблицы точности классификации.
Выводы автора:
- Эволюционно оптимизированная архитектура мозга мухи может быть менее эффективна для произвольных задач классификации текста, чем случайно устроенные нейросети
- Сжатие информации через фильтры рецепторных типов теряет подсказки о содержании, даже если входной сигнал идентичен
- Настоящая муха всё же различает тему статей лучше случайного угадывания (53% в нисходящих нейронах vs 17% наугад), что подтверждает обработку информации
Выходит, сотни миллионов лет эволюции проигрывают генератору случайных чисел, и проигрывают как раз там, где нейробиологи изучают память.
Оригиналы:Подключаем коннектом дрозофилы к Хабру. Что может пойти не так
Meta вкладывает миллиарды в ИИ: Muse привлекла 10 млн пользователей за 6 недель
ИИ и агенты · App Economy Insights · 8/10
Meta опубликовала квартальные результаты, показав рост выручки на 26% до рекордных $64,6 млрд, но акции упали на 7% из-за растущих расходов на ИИ и отрицательного свободного денежного потока. Компания запустила Muse — персональный ИИ-агент, который за шесть недель привлёк более 10 млн пользователей в США и Канаде с 25% дневной аудиторией. Ключевая привлекательность Muse — использование в шопинге (более 25% пользователей), где Meta видит возможности в подписках, комиссиях и рекламе.
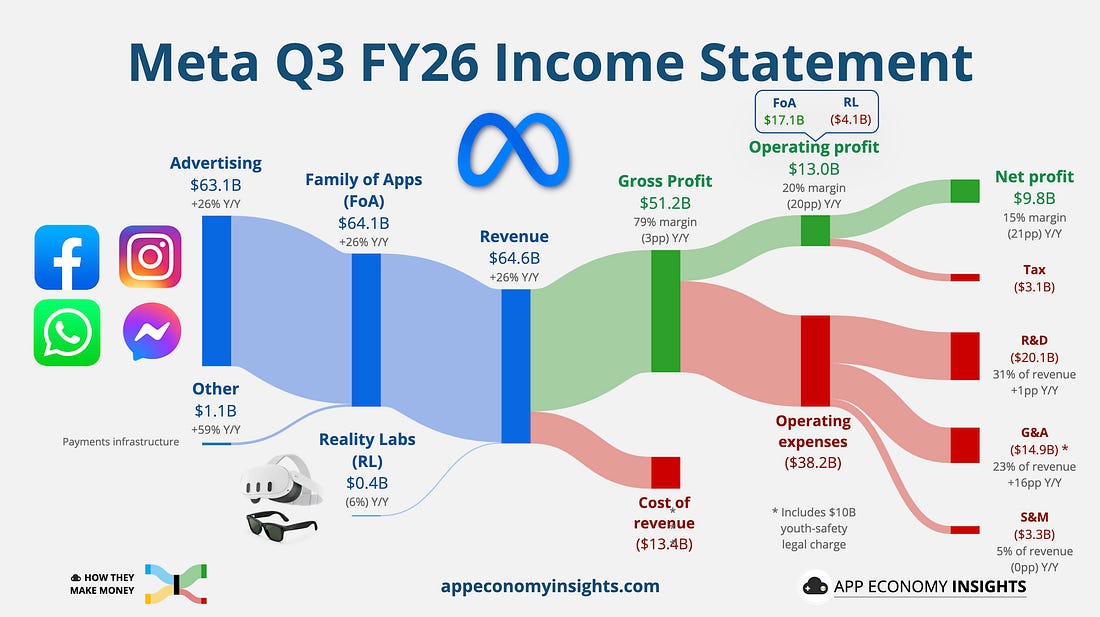
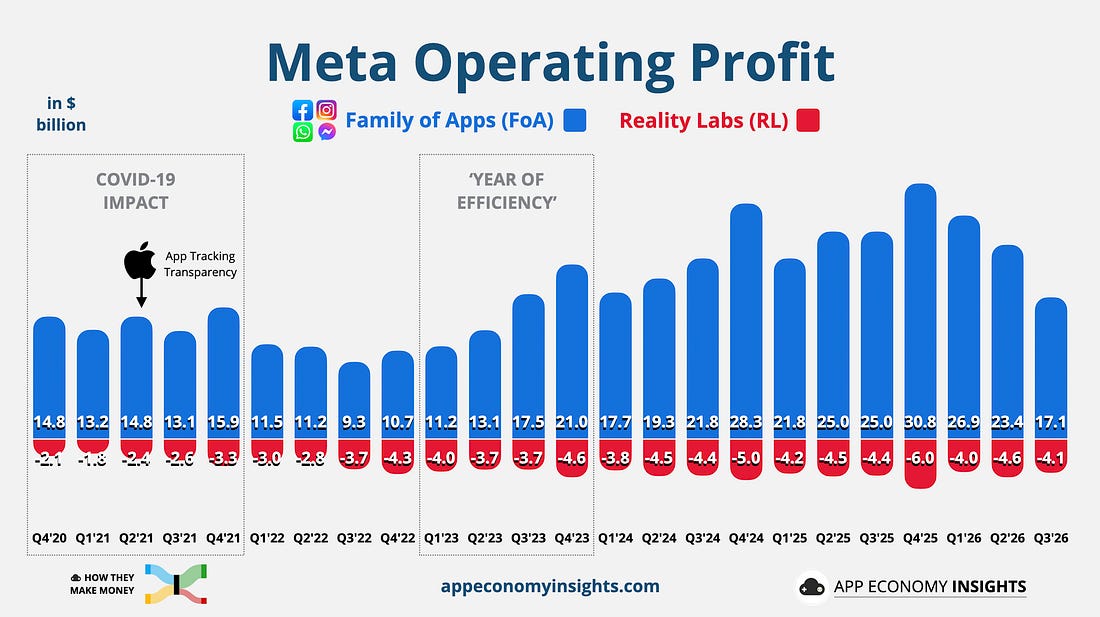
Однако резко выросли капитальные издержки: свободный денежный поток упал в минус (-$2,1 млрд против +$784 млн в Q2), капекс достиг $34,9 млрд. Meta подняла прогноз капекса на 2026 год до $135–145 млрд, операционная маржа снизилась до 35% с 40% годом ранее. Разработка Reality Labs потеряла ещё $4,1 млрд, и компания ожидает годовых убытков сегмента в $18–19 млрд в 2026 году. Мета также объявила о новом классе акций без права голоса для двойного дробления акций в январе 2027 года, что может помочь финансировать приобретения без размывания контроля Цукерберга. Дополнительный риск: суд Нью-Мексико постановил взыскать с компании $25 млрд за предполагаемый обман потребителей.
Выводы автора:
- Muse набирает обороты с 10 млн пользователей и высокой ежедневной аудиторией, но рентабельность ещё не доказана в масштабе
- Расходы на ИИ-инфраструктуру превысили операционный денежный поток, поставив под вопрос устойчивость маржинальности в 2026 году
- Реклама остаётся мощным драйвером с ростом на 26%, но доминирование ИИ-затрат заставило инвесторов пересмотреть динамику роста
Мьюз может со временем служить миллиардам людей и генерировать больше выручки на пользователя, чем существующие платформы Meta. Амбиции огромны, но и препятствия велики.
Оригиналы:Meta: AI Bet Takes Shape
RAG против Agentic RAG: два подхода к retrieval для LLM
ИИ и агенты · ByteByteGo · 8/10
Материал сравнивает две архитектуры для встраивания внешних знаний в большие языковые модели. Традиционный RAG (Retrieval-Augmented Generation) работает просто: приложение однократно извлекает релевантную информацию из базы знаний, добавляет её в промпт и LLM генерирует ответ на основе этого контекста. Качество результатов зависит от точности первоначального поиска.
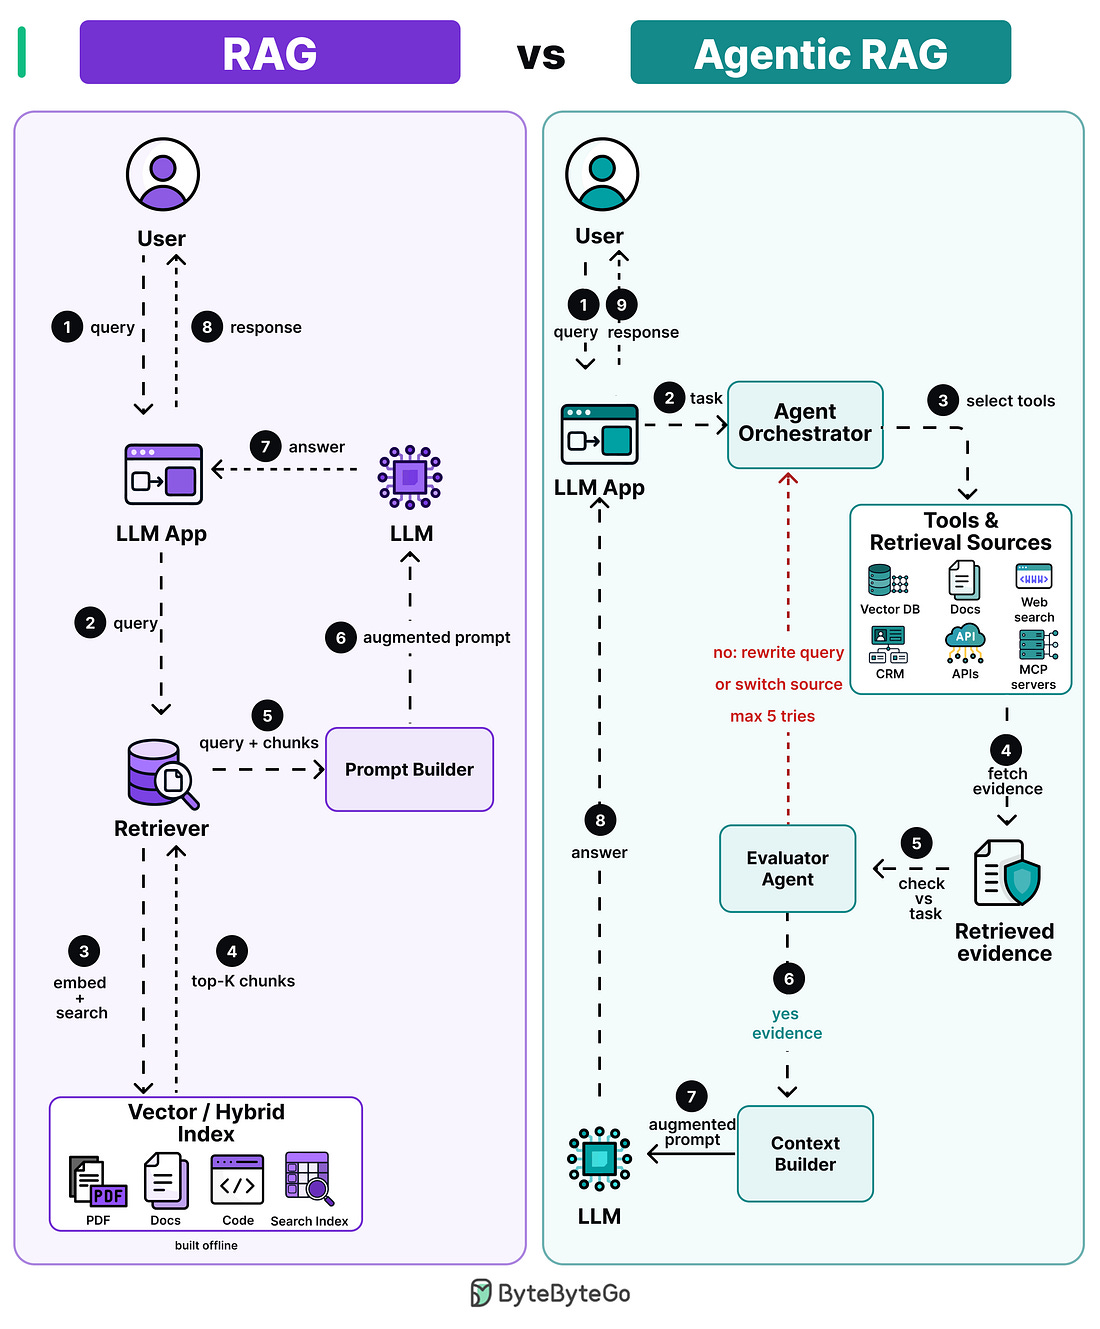
Agentic RAG следует итеративному подходу: агент самостоятельно выбирает нужные инструменты (поиск по документам, API, базам данных, веб), многократно извлекает информацию, оценивает достаточность собранных доказательств и при необходимости корректирует поиск или переходит на другой инструмент. Только когда накоплено достаточное количество доказательств, LLM генерирует финальный ответ. Таким образом, agentic подход обеспечивает большую гибкость и адаптивность при работе со сложными запросами.
Выводы автора:
- RAG использует однократное извлечение информации и зависит от качества начального поиска
- Agentic RAG применяет итеративный поиск с возможностью переоценки и смены стратегии для достижения лучших результатов
- Agentic RAG предоставляет большую гибкость благодаря автономному выбору инструментов и логике оценки достаточности информации
Качество результатов зависит от точности извлеченного контекста в традиционном RAG, тогда как agentis RAG может повторно извлекать и оценивать информацию до получения достаточных доказательств
Оригиналы:EP230: RAG vs Agentic RAG
Разработчик Telegram: 99,9% кода пишет AI, ручную разработку нужно прекратить
ИИ и агенты · Habr · 7/10
Разработчик официального macOS-клиента Telegram Майк заявил, что практически весь клиентский код мессенджера уже создают нейросети, и предложил увольнять тех, кто продолжает писать код вручную. По его оценке, такой подход разделяют 80–90% разработчиков Telegram. Майк привёл примеры: он переписал протокол MTProto 2.0 для iOS и macOS на Rust за пару промптов, новый блокчейн-обозреватель TON был создан за один день, а Claude за ночь адаптировал iOS-клиент под складной iPhone Duo. На вопросы о контроле качества Майк ответил, что код от AI лучше, чем код, написанный людьми вручную, а проблемы безопасности предлагается искать и исправлять тоже с помощью AI. Критиков, называющих результаты работы нейросетей «слопом», разработчик считает застрявшими в 2023 году.
Выводы автора:
- Большинство разработчиков Telegram уже полагаются на AI для генерации кода вместо ручного написания.
- По мнению разработчика, качество кода от нейросетей превосходит ручной код, включая вопросы безопасности.
- Такой подход позволяет решать сложные задачи (переписание протоколов, адаптация под новые платформы) в разы быстрее.
Код от нейросетей лучше того шлака, который пишут люди, а проблемы в безопасности можно искать и исправлять тоже с помощью AI.
Оригиналы:Разработчик Telegram: 99,9% клиентского кода пишет AI
Подводные камни BigDecimal в Java при работе с деньгами
Разработка и архитектура · Habr · 9/10
Статья разбирает парадокс Java-класса BigDecimal: хотя он корректно работает с арифметикой денежных сумм, сравнение чисел создаёт множество скрытых проблем. BigDecimal хранит число как пару (значение и масштаб), поэтому 1.0 и 1.00 считаются разными по методу equals(), но одинаковыми по compareTo(). Это приводит к нелогичному поведению коллекций: HashSet видит четыре разных единицы, а TreeSet видит одну. Проблема множится при получении данных из разных источников — базы данных (numeric столбцы), JSON (Jackson) и арифметических операций, каждый из которых может задать собственный масштаб. Хранение цены в базе как 1.10 и последующее сравнение с входящим 1.1 через equals() приводит к ложным срабатываниям на изменение. Решение — нормализация масштаба на границе доменной модели через record с компактным конструктором, использование compareTo() вместо equals() для сравнений, явное задание масштаба и режима округления при делении, корректная обработка вывода через toPlainString() или флаги Jackson.
Выводы автора:
- Используйте compareTo() вместо equals() для сравнения денежных сумм, так как equals() чувствителен к масштабу, а compareTo() видит только значение
- Нормализуйте масштаб в record-конструкторе на основе валюты, чтобы единственный источник истины был в доменной модели
- При делении денег всегда явно указывайте масштаб и режим округления, иначе результат зависит от масштаба делимого и может привести к ошибкам
HashSet из 990 и 990.00 содержит два разных элемента, а TreeMap находит их одинаково — лишь бы выбрали нужный контейнер с нужной семантикой сравнения.
Оригиналы:Почему BigDecimal считает 1.0 и 1.00 разными числами — и к чему это приводит в Java
Реверс-инжиниринг приборной панели автобуса: запуск дисплея KAntrak 2710
Разработка и архитектура · Habr · 8/10
Статья описывает практический опыт запуска и интеграции цифрового дисплейного модуля Kongsberg Automotive KAntrak 2710 от приборной панели автобуса ЛиАЗ. Автор разобрал устройство, идентифицировал компоненты (микроконтроллер Infineon SAK-C164CI-LM, CAN-трансивер PCA82C251T/YM) и выяснил, что девайс работает по стандарту J1939, используемому в коммерческом транспорте. На легковых автомобилях каждый производитель использует проприетарные протоколы, тогда как в грузовиках и автобусах существует единый отраслевой стандарт J1939 с расширенным 29-битным CAN ID, включающим приоритет, PGN (код типа пакета) и SA (адрес источника). После подключения Arduino с модулем CAN на MCP2515 и определения правильной скорости шины (250 кбит/с) удалось отобразить данные на дисплее. Ключевой момент: адреса источников данных (АДР. ИС. ДАНН.) в конфигурации были изменены — двигатель был переназначен на адрес 17 вместо стандартного 0, что изначально препятствовало отображению параметров. В статье приведён полный Arduino-скетч для имитации данных J1939 с реалистичными значениями оборотов двигателя, температур, давления масла и других показателей.
Выводы автора:
- Коммерческий транспорт использует стандартизированный протокол J1939 на шине CAN со скоростью 250 кбит/с, что позволяет легче интегрировать и реверс-инжинировать устройства по сравнению с легковыми автомобилями с проприетарными протоколами
- Идентификация конфигурационных параметров (адреса источников данных в меню устройства) критична для корректного отображения показаний — неправильный SA приводит к тому, что дисплей получает, но не распознаёт данные
- Дисплейный модуль по сути является полнофункциональным микрокомпьютером с поддержкой пользовательских конфигураций и приложений, что открывает возможности для адаптации под специфические задачи (автосимуляторы, индикация в собственных проектах)
Коммерческий транспорт — грузовики, автобусы и спецтехника — использует единый отраслевой стандарт J1939, тогда как на легковых автомобилях каждый производитель применяет собственные проприетарные протоколы.
HabrExporter: инструмент для сохранения статей Хабра в офлайн
Разработка и архитектура · Habr · 8/10
Представлен HabrExporter — приложение с графическим интерфейсом и CLI для массового сохранения статей, блогов и закладок Хабра в различные форматы: PDF, HTML, DOCX, EPUB, FB2, Markdown и JSON. Автор разработал инструмент, потому что существующие решения не полностью устраивали его требования. Программа написана на Python с использованием PyQt6 и содержит около 10 тысяч строк кода. Особенность реализации — использование внутреннего API Хабра (по адресу /kek/v2/) вместо парсинга HTML, что обеспечивает надёжность при изменениях вёрстки сайта. При разработке автор активно применял Claude Code для ускорения работы, отметив, что проект занял всего 2–3 неполных дня. Программа поддерживает три режима: одиночная загрузка статей, пакетная загрузка по ссылкам или из текстового файла, а также возможность скачивания закладок, всех статей автора и новостей. Во всех форматах сохраняется структура материала (заголовки, списки, таблицы, код), а в PDF оформление максимально приближено к оригиналу на сайте, включая дерево комментариев. Изображения можно встраивать в файл или оставлять ссылками. Использование программы для личного архивирования защищено российским законодательством (статьи 1273 и 1335.1 ГК РФ).
Выводы автора:
- HabrExporter использует внутренний API Хабра вместо парсинга HTML, что делает инструмент более надёжным к изменениям интерфейса сайта.
- Программа поддерживает семь форматов экспорта с разными уровнями поддержки, позволяя сохранять как статьи с комментариями, так и целые блоги авторов.
- Разработка современного ПО может быть значительно ускорена использованием LLM для генерации кода, но требует активного контроля, проверки и тестирования со стороны разработчика.
Парсить вёрстку — занятие неблагодарное: стоит Хабру переставить пару div-ов, и всё ломается.
Оригиналы:HabrExporter на Habr · Open source раздел
RAG против Agentic RAG: архитектурные различия для разработчиков
Разработка и архитектура · ByteByteGo · 8/10
Материал разбирает пять ключевых блоков, которые должен понимать инженер, работающий с ИИ. Основной фокус — различие между традиционным RAG (Retrieval-Augmented Generation) и Agentic RAG. Традиционный RAG следует фиксированному процессу: пользователь задаёт вопрос, система одноразово извлекает релевантную информацию из базы знаний, добавляет её в промпт и LLM генерирует ответ на основе этого контекста. Качество результатов зависит от точности одного поиска. Agentic RAG использует итеративный подход: агент выбирает нужные инструменты (поиск документов, API, базы данных, веб), многократно получает и оценивает информацию, может менять стратегию поиска, пока не накопит достаточно доказательств для ответа. Дополнительно рассмотрены OAuth 2.0 для авторизации, OIDC как слой аутентификации поверх OAuth, и структура директорий Linux. Материал носит обзорный характер и предназначен для инженеров, желающих понимать современный стек ИИ-разработки.
Выводы автора:
- Agentic RAG превосходит традиционный RAG благодаря итеративному поиску и способности адаптировать стратегию, пока не будет собрано достаточно информации для ответа.
- Различие между OAuth (авторизация) и OIDC (аутентификация): первое определяет, что вам разрешено делать, второе — кто вы.
OAuth ответит, что вы можете трогать, а OIDC ответит, кто вы.
Оригиналы:EP230: RAG vs Agentic RAG
Почему Windows 11 всё ещё требует Ctrl+Alt+Del, несмотря на критику Гейтса
Разработка и архитектура · Habr · 7/10
Статья рассказывает об истории одной из самых знаменитых комбинаций клавиш в компьютерных системах — Ctrl+Alt+Del — и почему она остаётся в Windows 11, хотя основатель Microsoft Билл Гейтс неоднократно называл её ошибкой. Комбинация была придумана в 1981 году инженером IBM Дэвидом Брэдли как способ перезагрузить зависший компьютер без его полного выключения, разработка заняла всего несколько минут. Позже Microsoft выбрала Ctrl+Alt+Del для Windows NT 3.1 (1993) в качестве «безопасной последовательности клавиш» (Secure Attention Sequence), которую не могло бы перехватить стороннее приложение — это оказалось единственным сочетанием, которое тогда не использовалось ни в одной программе. Гейтс публично критиковал решение в 2013 и 2017 годах, утверждая, что для этой цели достаточно было бы одной клавиши, но возложил вину на IBM. Однако Microsoft сама добавила клавишу Windows на клавиатуры в 1994 году и так и не реализовала альтернативу. В Windows 11 при нажатии Ctrl+Alt+Del открывается экран безопасности, позволяющий заблокировать компьютер, сменить пользователя или открыть диспетчер задач. На домашних компьютерах комбинация не требуется по умолчанию, но может быть включена через политики безопасности. Необходимость этого сочетания обусловлена архитектурной потребностью обеспечить «доверенный путь» (trusted path) к системе аутентификации, защищённой от перехвата паролей вредоносным ПО. Ирония ситуации в том, что в 2024 году Microsoft добавила отдельную клавишу для Copilot, но так и не реализовала мечту Гейтса о единой клавише безопасности.
Выводы автора:
- Ctrl+Alt+Del остаётся в Windows 11 не из-за технических ограничений, а как часть архитектуры безопасности для защиты от вредоносного ПО, которое может подделать экран входа
- Microsoft имела возможность заменить эту комбинацию с 1994 года (после введения клавиши Windows), но этого не сделала, несмотря на критику основателя компании
Мы могли бы обойтись одной кнопкой, но человек, отвечавший за разработку клавиатуры IBM, не захотел нам её предоставить. Это была ошибка.
Оригиналы:Windows 11 использует сочетание Ctrl+Alt+Del вопреки критике Билла Гейтса
Как Sony сама подарила PS3 хакерам: история криптографической ошибки
Кибербезопасность · Habr · 9/10
Статья рассказывает о крупнейшей ошибке безопасности в истории игровых консолей — о том, как Sony потеряла контроль над PS3 из-за криптографической ошибки, которую можно назвать студенческой лабораторной работой. В 2010 году Sony удалила функцию Other OS (Linux), которую четыре года рекламировала как главную фишку консоли, якобы по соображениям безопасности. Но уже через год группа fail0verflow на Chaos Communication Congress обнаружила, что Sony при подписи кода алгоритмом ECDSA использовала одно и то же случайное число для всех подписей вместо уникального для каждой. Из школьной алгебры за пару строк кода вычисляется приватный ключ платформы. Джордж Хотц (geohot) выложил этот ключ в январе 2011 года, Sony судилась с ним, потребовала IP-адреса всех посетителей его блога, а в апреле консоль была взломана (утечка 77 миллионов аккаунтов, 23 дня без сети, убытки 171 миллион долларов). В 2012 году опубликовали ключи самого нижнего загрузчика, и все PS3 остались открытыми навеки. История повторилась с PS5 в 2026 году, но уже с BootROM-ключами. Владельцы PS3, затеявшие иск за удаление Linux, получили в итоге по 10 долларов 7 центов через 8 лет.
Выводы автора:
- Sony удалила функцию Other OS вместо исправления гипервизора, что привело к интересу хакеров и вычислению приватного ключа благодаря использованию одного и того же nonce в ECDSA
- Криптографическая ошибка (один nonce для всех подписей) позволила вычислить приватный ключ школьной алгеброй за пару строк, оставив 95+ миллионов консолей уязвимыми навечно
- Попытки Sony судом остановить распространение джейлбрейка привели к огромному ущербу: утечке данных, репутационному урону и символическим выплатам пострадавшим в размере 10 долларов вместо обещанного возмещения
Если два раза подписать разные данные с одним и тем же числом, из двух подписей школьной алгеброй вычисляется приватный ключ.
Оригиналы:Sony отобрала у PS3 Linux, а через год потеряла ключи от всей консоли
НКЦКИ при ФСБ потребовал срочно обновить PHP с критическими уязвимостями
Кибербезопасность · Habr · 9/10
НКЦКИ при ФСБ направил операторам критической инфраструктуры (госучреждения, банки, операторы связи, энергетические и медицинские организации) требование срочно устранить две критические уязвимости PHP (CVE-2026-109618 и CVE-2026-109619, получившие название PHP2Shell) с оценкой 9,2 балла по CVSS 4.0, позволяющие выполнять произвольный код без авторизации. Если обновление невозможно, рекомендовано отключить уязвимые серверы. PHP используется на 69,3% всех сайтов в мире и 90,8% русскоязычных ресурсов, что показывает масштаб угрозы. Разработчики выпустили исправления в версиях 8.2.35, 8.3.36, 8.4.27 и 8.5.12, а Ондржей Сура подготовил обновления для 12 веток PHP, включая неподдерживаемые. В ответ многие страны (Нидерланды, Франция, Германия, Финляндия, Япония) приняли превентивные меры по отключению государственных сайтов и сервисов. Cloudflare зафиксировала резкий рост попыток эксплуатации: от нескольких тысяч до миллионов после раскрытия информации. Статья поднимает вопрос о том, как государственное регулирование кибербезопасности переходит в область повседневного администрирования и создаёт для организаций практические проблемы: расходы на обновление коммерческого ПО, тестирование совместимости и окна обслуживания, которые требование не решает.
Выводы автора:
- Две критические уязвимости PHP (PHP2Shell) позволяют выполнять произвольный код на сервере без авторизации и затрагивают большинство установок PHP, что требует срочного обновления или отключения сайтов.
- Государственное регулирование кибербезопасности в России переходит от рекомендаций к прямым требованиям на уровне ФСБ, создавая для системных администраторов и организаций финансовые и технические проблемы, которые государство пока не предлагает решать.
Письмо с требованием срочно обновиться этих задач не решает: между выпуском исправления и его безопасным внедрением нередко лежат тестирование совместимости, резервное копирование и дополнительные расходы.
Защита ЦОДов от кинетических и кибератак: стратегии регуляторов
Кибербезопасность · Habr · 8/10
Статья анализирует эволюцию подходов к защите центров обработки данных, которые теперь рассматриваются как стратегические объекты, требующие многоуровневой защиты от физических и кибератак. ЦОДы стали критической инфраструктурой: авария на ДЦ Яндекса показала, как быстро могут лечь сервисы миллионов пользователей, нанося огромный ущерб компаниям через потери доходов, репутацию и цену акций. Защита строится на трёх основах: отказоустойчивость (стандарты Tier III-IV), контроль доступа (включая антидроновую защиту) и геораспределение с дублированием данных в разных регионах. Кибербезопасность остаётся критична параллельно физической защите: кинетические атаки часто следуют за кибератаками, и необходимы защита от DDoS терабитного масштаба, сегментация сети по принципу Zero Trust и импортозамещение ИБ-стека. США сделали ЦОДы частью критической инфраструктуры и фокусируются на наступательных кибероперациях и автономных системах защиты с ИИ. ЕС запустил европейскую систему оповещения об угрозах в реальном времени и ужесточил стандарты в финсекторе (DORA). Россия планирует снизить долю иностранных ИБ-решений до 4% к 2030 году, разместить ЦОДы на защищённых площадках в энергоизбыточных регионах (Урал, Восточная Сибирь) и ввести двухуровневую ответственность операторов. Таллинское руководство (версия 3.0) классифицирует атаки на физическую инфраструктуру ЦОДов как потенциальный акт агрессии. Практика показала уязвимость: в апреле 2026 Иран объявил инфраструктуру западных IT-компаний законной военной целью и заявил об успешных ударах по облачным центрам Amazon в Бахрейне, а марте атаки на ДЦ AWS в ОАЭ вызвали перебои в банковском секторе.
Выводы автора:
- ЦОДы требуют комплексной защиты: одновременно физической (от дронов, заглубление, ПВО) и кибернетической (DDoS-фильтры, Zero Trust, импортозамещение), так как кинетические и кибератаки часто идут в связке.
- Государства переходят на наступательные киберстратегии и объявляют ЦОДы критической инфраструктурой, что подразумевает государственный контроль и двухуровневую ответственность операторов за инциденты.
- Геораспределение данных в несколько регионов (минимум три-четыре) и размещение новых ЦОДов на специально защищённых, удалённых площадках становится базовым стандартом, а не элементом резервирования.
Рабочий ЦОД — залог выживания бизнеса. Это уже не громкая фраза, а насущная реальность.
Оригиналы:Защита ЦОДов от кинетических и кибератак. Что пока предлагают регуляторы разных стран
Статистический подход к оценке безопасности AI-приложений
Кибербезопасность · Habr · 8/10
Статья описывает методику определения достаточного количества тестовых примеров для проверки безопасности AI-приложений при red-teaming. Авторы продукта HiveTrace Red объясняют проблему: когда приложение проходит все попытки взлома, непонятно, действительно ли оно безопасно или данных просто недостаточно. Для решения используется статистический метод верхней границы Клоппера—Пирсона, который оценивает неопределённость результатов на малых выборках. Например, если на 10 запросах нарушений не найдено, верхняя граница частоты нарушений составляет ~25,89%, но для подтверждения требования 0,3% нужно минимум 998 независимых запросов без нарушений. Метрика ASR (Attack Success Rate) дополняется доверительным интервалом, позволяющим различить «не нашли нарушений» от «данных недостаточно». Авторы также описывают определение критериев нарушения, задание допустимого порога риска и применение различных атакующих техник для комплексной проверки защиты приложения.
Выводы автора:
- Нулевая ASR на малой выборке не гарантирует безопасность приложения; необходимо рассчитать минимальный объём тестов на основе требуемого допустимого порога нарушений
- Верхняя граница Клоппера—Пирсона позволяет отличить статистически значимые результаты от случайного совпадения и определить, достаточно ли данных для принятия решения
- Проверку нужно планировать заранее, задав критерий нарушения, метрику и допустимый порог, чтобы заранее знать требуемый объём выборки и условия прохождения проверки
Ноль нарушений — не нулевая частота. Десяти наблюдений без нарушений недостаточно, чтобы подтвердить низкую частоту нарушений выбранным методом.
Оригиналы:Сколько примеров нужно, чтобы проверить безопасность AI-приложения
О смерти письменной культуры в Amazon
Продукт и карьера · Substack · 7/10
Материал рассказывает о деградации письменной культуры в Amazon на примере встречи, где руководитель уровня L7 просто читал шесть страниц документа вслух, вместо того чтобы предварительно его изучить. Это свидетельствует о более глубокой проблеме — утрате привычки к глубокому анализу и подготовке, которая долгое время была отличительной чертой корпоративной культуры компании. Автор указывает на то, что письменное общение требует большей ясности и дисциплины мышления, чем устные презентации. Деградация этой практики влияет на качество принятия решений и культуру организации в целом. Материал затрагивает более широкую тему упадка строгих профессиональных стандартов в технологической индустрии.
Выводы автора:
- Amazon утратила критически важный элемент своей культуры — дисциплину письменного общения и подготовки к встречам.
- Письменная коммуникация формирует более четкое и ответственное мышление, чем устные презентации, и её потеря влияет на качество работы.
Тридцать минут спустя после начала встречи руководитель уровня L7 начал обсуждать шестистраничный документ, но буквально через две минуты всем в комнате стало ясно, что он просто читает текст впервые.
Оригиналы:О смерти письменной культуры Amazon
Famicom Modem: как Nintendo в 1988 году создала первый домашний интернет
Прочее · Habr · 7/10
Статья рассказывает о малоизвестном проекте Nintendo — модеме для приставки Famicom, который в 1988 году позволял японцам подключаться к сетевым сервисам за 15 лет до массового интернета. Визионер Хироси Ямаути предвидел эпоху информационных технологий и спроектировал двухпроцессорную архитектуру: основной процессор Famicom отображал интерфейс, а независимый микропроцессор 65C02 в модеме управлял модемом, набором номера и проверками. Пользователи вставляли специальные «коммуникационные карты» (tsushin card) вместо картриджей, получая доступ к различным сервисам. Фамикомовский онлайн включал Super Mario Club с лидербордами и обменом читами, простые мультиплеерные игры (шахматы, го, маджонг), управление финансовыми активами, покупку акций и облигаций, а главное — ставки на скачки, где сервис привлекал до 100 тысяч пользователей благодаря популярности лошади Огури Кэп. Однако продажи модема составили лишь 130 тысяч штук вместо планируемого миллиона: консервативные японцы не доверяли игрушечной приставке для серьёзных финансов, процедура подключения была трудоёмка, а главное — в онлайне было делать нечего без полноценного мультиплеера для популярных игр. FCNS закрыли в начале 1990-х, но она остаётся исторической вехой как первая попытка создать домашний интернет, пусть и потерпевшая неудачу из-за преждевременности.
Выводы автора:
- Famicom Modem был революционной попыткой Nintendo создать домашний интернет в 1988 году, за 15 лет до массового распространения технологии, но потерпел неудачу из-за слабого контента и консервативности рынка.
- Главным козырем сервиса были не игры, а финансовые услуги и ставки на скачки, привлекавшие до 100 тысяч пользователей благодаря популярности лошади Огури Кэп.
- Техническая реализация была инновационной — двухпроцессорная архитектура с независимым микропроцессором в модеме и съёмные коммуникационные карты вместо картриджей.
Это лишь дело времени. Когда люди наконец будут готовы, сеть уже будет готовой у нас на руках
Оригиналы:«Денди», которая умела выходить в интернет · Читальный зал
Коротко
Разработка и архитектура
- Топ-5 строительных блоков ИИ, которые должен знать каждый инженер – Материал рассматривает пять ключевых компонентов, необходимых инженерам для работы с искусственным интеллектом и разработки ИИ-систем.
Финтех и финансы
- Правительство РФ обсуждает завершение программы IT-ипотеки в 2026 году – По информации СМИ, российское правительство рассматривает возможность закрыть программу льготной IT-ипотеки уже в 2026 году из-за ограничений бюджета.
Продукт и карьера
- Богатство — вопрос навыков: как стать «бессознательно богатым» – Статья о том, почему большинство людей остаются бедными и как переход в правильную систему зарабатывания может кардинально изменить жизнь.
Прочее
- Музыка на дисководах: история и создание VST-синтезатора Flopster – Статья рассказывает об истории использования звуков работы дисководов как музыкального инструмента, начиная с ранних экспериментов 1940-х годов с компьютерами и заканчивая современ