Дайджест за 18 октября 2026
Диффузионные трансформеры теперь работают на микроконтроллерах — инженеры запустили text-to-image прямо на ESP32, и это серьёзный сдвиг в распределённом ИИ. В России разбирают громкое дело о присвоении софта госкорпорацией на 24,7 млн рублей, а разработчиков направили в РНП — кейс, который изменит представление о защите авторских прав в стартапах. На фоне всего этого AI переоценил зарплаты облачных инженеров до $300K, и появились первые практические стратегии разбиения текста для RAG-агентов, которые уже работают в production-системах.
Главное
- Text-to-image на ESP32: диффузионный трансформер в микроконтроллере
- Как госкорпорация присвоила софт за 24,7 млн рублей и отправила разработчиков в РНП
- Настоящая BBS на калькуляторе Casio VX-4 через Telnet
- Мифы о зумерах-стажерах: что правда, а что предубеждение
- Аппаратная защита в RISC-V: механизмы и затраты
Подробно
Text-to-image на ESP32: диффузионный трансформер в микроконтроллере
ИИ и агенты · Habr · 9/10
Статья разбирает реализацию full-stack генерации изображений по текстовому описанию прямо на микроконтроллере ESP32-S3 с ресурсами в 512 КБ ОЗУ, двумя ядрами 240 МГц и без тензорных ядер. Автор генерирует лица размером 64×64 за 5,4 секунды, используя диффузионный трансформер (DiT) вместо классического U-Net и латентную диффузию для сжатия данных в 12 раз. Ключевые оптимизации: собственный текстовый энкодер на 300 тысяч параметров (вместо CLIP на 250 МБ), квантование весов и активаций в int8, Rectified Flow вместо классического DDPM (достаточно 8 шагов вместо 50–1000), собственный 179-килопараметровый декодер без нормализаций. Для генерации синтетических описаний использован датасет CelebA с автоматической генерацией русскоязычных подписей на основе 40 атрибутов лиц. Автор пишет критичные части на ассемблере, используя PIE (Processor Instruction Extensions) — векторные инструкции ESP32-S3, позволяющие за одну команду выполнить 16 умножений int8. Финальная модель весит 3,1 МБ, лежит во Flash и отображается в памяти через esp_partition_mmap. На двух ядрах достигается 1,5 миллиарда операций умножения-накопления в секунду — в 78 раз быстрее, чем pure-C int8 реализация.
Выводы автора:
- Генерацию изображений на микроконтроллере с 512 КБ памяти можно реализовать, сильно сузив домен (лица), разрешение (64×64) и используя продвинутые методы квантования и оптимизации архитектуры.
- Ассемблерная оптимизация с использованием PIE инструкций и правильной раскладки данных в памяти дала ускорение в 100+ раз относительно float32 на C.
- Rectified Flow позволяет получить хорошие результаты за 8 шагов вместо классических 50–1000 шагов DDPM, критически важно для экономии на вычислениях.
Пишешь «улыбающаяся девушка со светлыми волосами», и через 5,4 секунды ESP32 выдаёт лицо 64×64.
Оригиналы:Text-to-image на ESP32: диффузионный трансформер в микроконтроллере
RFC 9421 и wbauth: криптографическая идентификация вместо антидетектов
ИИ и агенты · Habr · 8/10
Автор предлагает принципиально новый подход к идентификации AI-агентов в сети: вместо маскировки под людей через антидетекты использовать криптографические паспорта на основе стандарта IETF RFC 9421 с подписями Ed25519. Текущая архитектура ферм агентов требует огромных ресурсов: сотни мегабайт памяти на процесс браузера, прокси-серверы, эмуляция человеческого поведения, что превращается в гонку вооружений с системами защиты. Предложенный протокол wbauth обеспечивает радикальное улучшение производительности: холодный старт сокращается с 1744 мс до 5 мс, время запроса с 86,8 мс до 15,8 мс, потребление памяти снижается с 500 МБ до 0,76 МБ. Подход заменяет мимикрию криптографией, что является стандартным решением для идентификации в распределённых системах. Автор проводит честный анализ архитектуры, канонизации, проверки на WAF и приводит методику замеров с указанием ограничений.
Выводы автора:
- Криптографическая идентификация агентов через RFC 9421 эффективнее и дешевле антидетектов
- Текущий подход с маскировкой браузеров — гонка вооружений с нулевой суммой, требующая растущих ресурсов обеим сторонам
- Открытый протокол wbauth позволяет сократить задержки в 5-15 раз и потребление памяти в 650 раз
Антидетект — не инженерное решение, а костыль, который пытается решить задачу идентификации средствами мимикрии. Задача идентификации в распределённых системах давно решена, и решается она криптографией.
Оригиналы:Полная статья на Habr
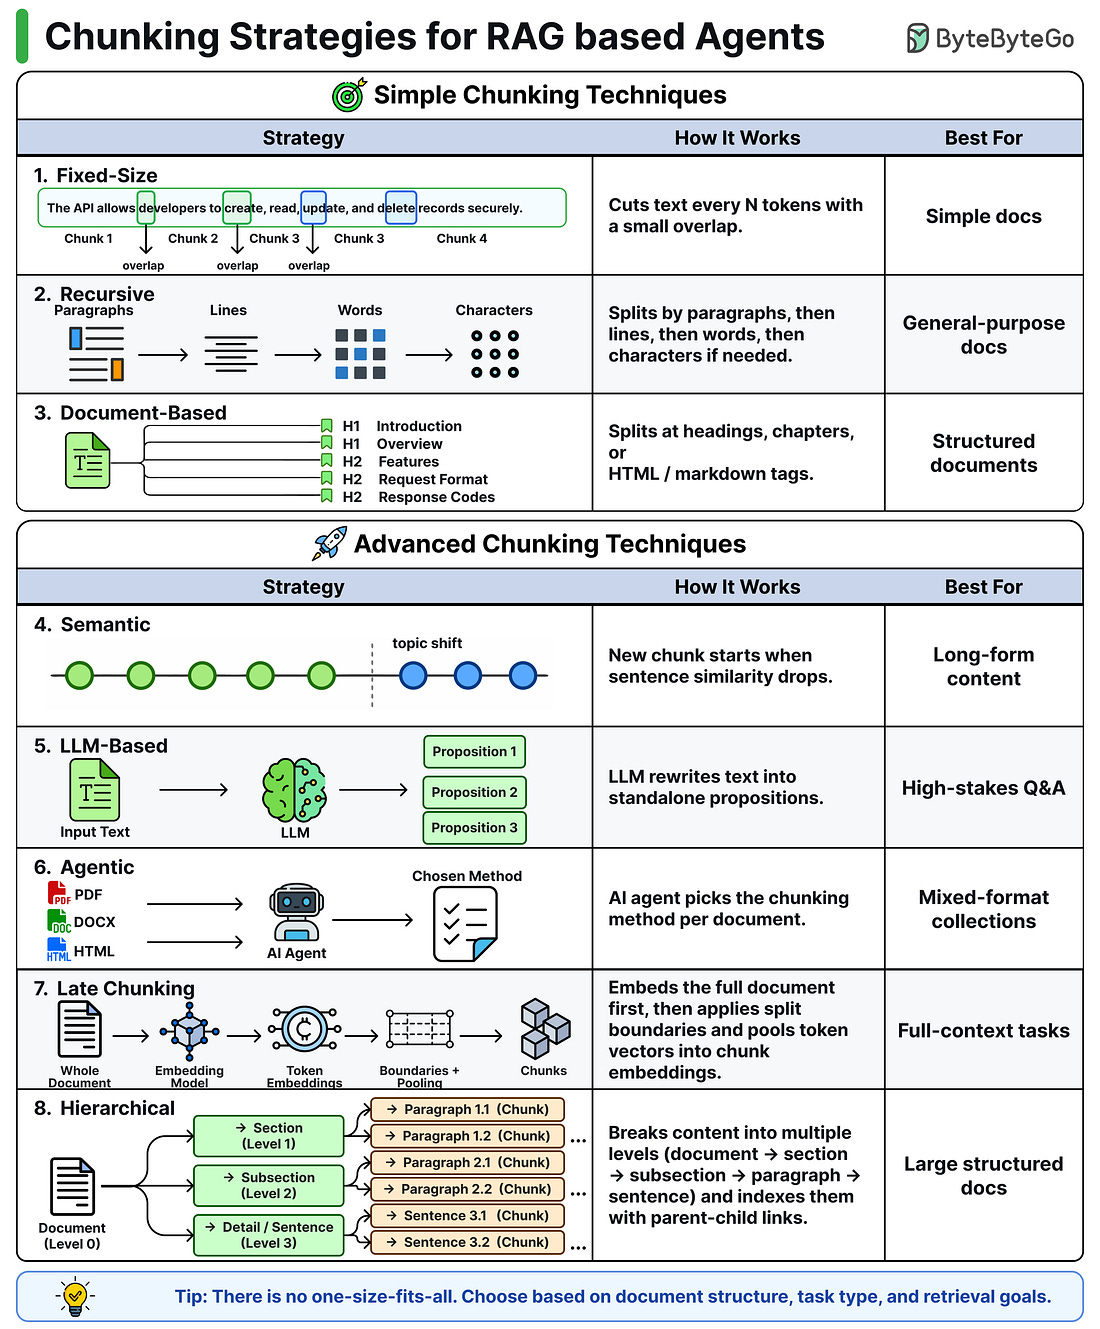
8 стратегий разбиения текста для RAG-агентов
ИИ и агенты · ByteByteGo · 8/10
Материал описывает восемь методов разбиения документов на части (чанки) для систем RAG (Retrieval-Augmented Generation), которые используют ИИ-агенты. Fixed-Size просто режет текст на равные порции с перекрытием. Recursive применяет иерархический подход: сначала по параграфам, затем по строкам и словам. Document-Based ориентируется на естественную структуру файла (заголовки, главы, теги HTML). Semantic использует embedding-модели для определения реальных переходов тем через анализ схожести предложений. LLM-Based просит языковую модель переписать текст в отдельные тезисы, что даёт высокое качество, но дорого на больших объёмах. Agentic позволяет агенту выбирать метод в зависимости от типа документа (код, контракт, таблица). Late Chunking обрабатывает весь документ через embedding-модель целиком, затем разбивает и усредняет эмбеддинги. Hierarchical создаёт многоуровневую структуру от разделов до отдельных предложений.
Выводы автора:
- Выбор стратегии разбиения текста критичен для эффективности RAG-систем и должен зависеть от типа документа и использованной модели.
- Семантические подходы (Semantic, LLM-Based, Agentic) обеспечивают лучшее качество, но требуют больше вычислительных ресурсов, чем простые методы.
- Late Chunking и Hierarchical методы предоставляют гибридные решения, сочетающие эффективность с качеством представления контекста.
Семантический подход находит реальные переходы тем вместо того, чтобы угадывать по длине текста.
Оригиналы:8 стратегий разбиения текста для RAG-агентов на Substack
Однобитная квантизация LLM: как получить Bonsai-модель через дистилляцию
ИИ и агенты · Habr · 7/10
Статья разбирает технику экстремальной квантизации больших языковых моделей до одного бита на вес, позволяющую уместить 27-миллиардную модель с 54 ГБ в ~4 ГБ памяти. Автор анализирует формат Bonsai от PrismML, где веса хранятся одним битом со скалярной шкалой на группу из 128 весов, и показывает, что простое округление весов приводит к полной потере функциональности модели. После экспериментов с послойной квантизацией и сравнения весов Bonsai и Qwen3-1.7B автор обнаружил, что оптимальный способ получения однобитной модели – это дистилляция, и самостоятельно обучил работающую однобитную модель. Методика открывает путь к запуску крупных LLM на маломощном оборудовании с видеокартами объёмом памяти в несколько гигабайт.
Выводы автора:
- Однобитная квантизация с групповой шкалой масштабирования позволяет сжать модели примерно в 13 раз без использования простого округления весов
- Дистилляция – более эффективный подход к получению однобитных моделей, чем послойная квантизация
- Такой формат квантизации имеет реализации в llama.cpp и MLX и может снизить барьер входа для запуска больших моделей
Если хранить каждый вес одним битом и один общий масштаб на группу из 128 весов, те же параметры уместятся примерно в 4 ГБ
Оригиналы:Однобитная Bonsai по весам: что видно при сравнении с Qwen и как получить такую модель дистилляцией
GLM 5.3 Flash и DeepSeek V4.1 Flash стали бесплатными в OpenCode
ИИ и агенты · Habr · 7/10
В платформе OpenCode открыли бесплатный доступ к двум моделям: GLM 5.3 Flash и DeepSeek V4.1 Flash. Обе модели уже добавлены в каталог и доступны через IDE OpenIDE Pro. Бесплатный доступ временный (дата окончания не указана), при этом провайдеры не сохраняют запросы и не используют их для обучения. Плагин AI for OpenIDE позволяет использовать эти модели прямо в редакторе: поставить задачу агенту, увидеть изменения в коде, запустить приложение и проверить результат. Если требуется более мощная модель, можно переключиться на Claude Code или Codex без необходимости переходить в другую среду. OpenIDE Pro поддерживает Java, Kotlin, Go, Python, PHP, JavaScript, TypeScript и интегрирует отладчик, Git, базы данных, Docker и HTTP-клиент. Первые два месяца OpenIDE Pro можно использовать бесплатно без регистрации.
Выводы автора:
- OpenCode предоставил бесплатный временный доступ к GLM 5.3 Flash и DeepSeek V4.1 Flash с нулевой стоимостью токенов
- Разработчики могут использовать эти модели прямо в IDE OpenIDE Pro через плагин AI for OpenIDE без необходимости переходить между инструментами
- Внутри одной среды разработки можно гибко переключаться между разными агентами и моделями в зависимости от сложности задачи
Агент вносит изменения, а вы можете сразу изучить дифф, поправить код руками, проверить данные в базе или поднять окружение через Docker Compose.
Оригиналы:GLM 5.3 Flash и DeepSeek V4.1 Flash стали бесплатными в OpenCode
Как устроена нейронная машинный перевод в Google Translate
ИИ и агенты · ByteByteGo · 7/10
Материал объясняет архитектуру и основные компоненты нейронного перевода, который использует Google Translate. Процесс начинается с классификации исходного языка, затем текст разбивается на подсловные токены с помощью BPE-токенизатора, что позволяет модели работать с любыми словами любых языков. Специальный токен-указатель (например, <2es> для испанского) добавляется в начало последовательности, чтобы направить вывод на целевой язык.
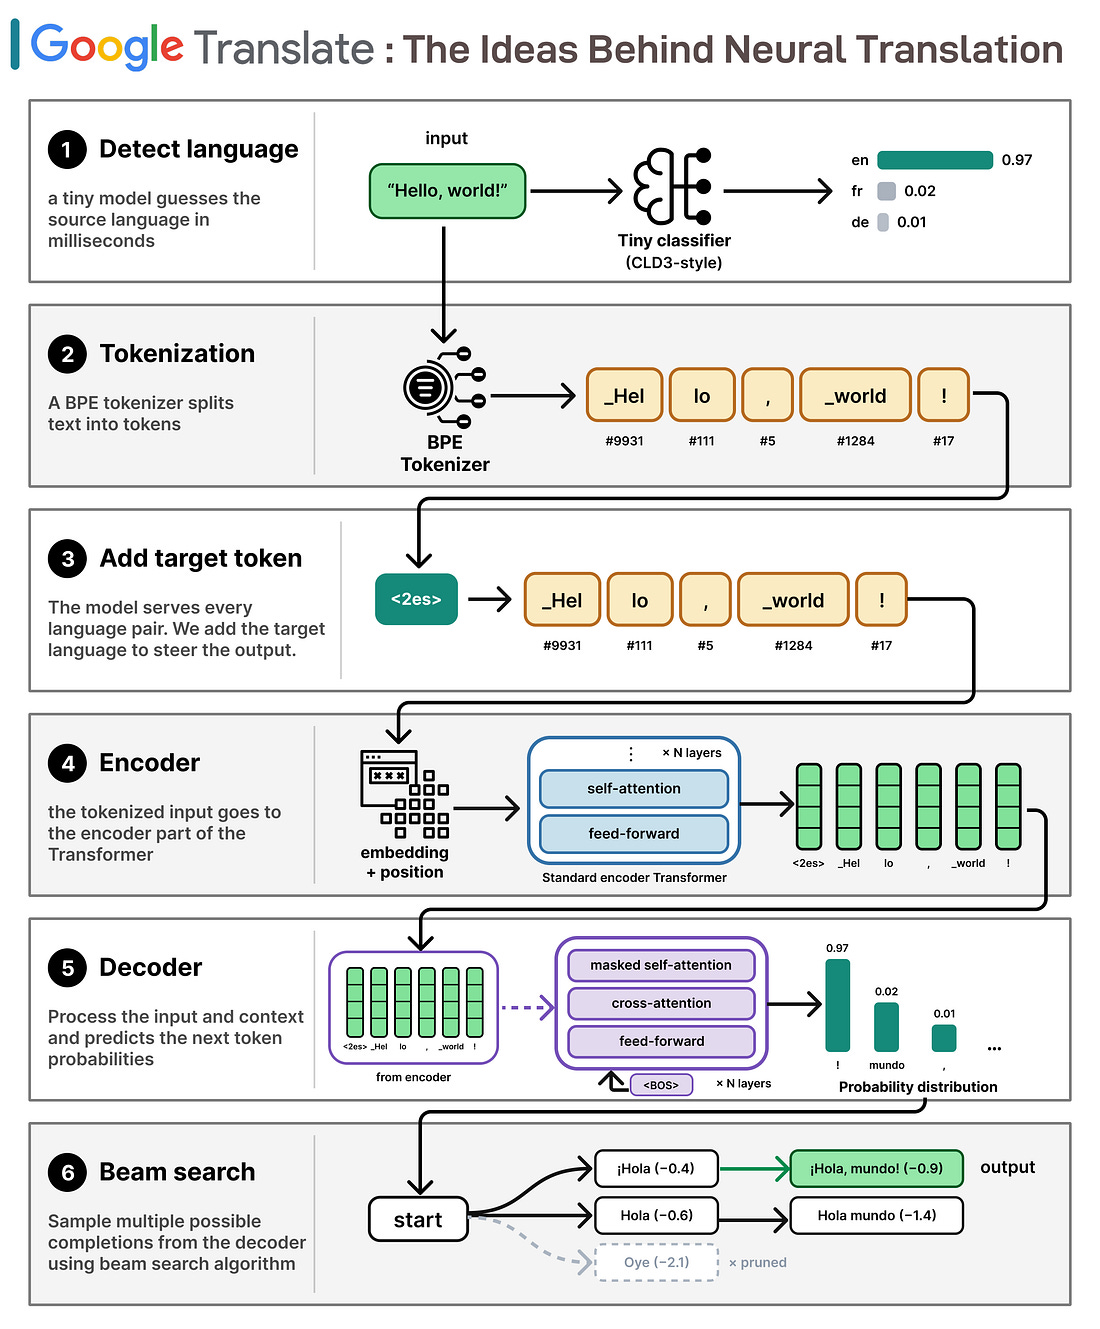
Токены проходят через слои Transformer в энкодере, генерируя векторное представление для каждого входного токена. Декодер затем предсказывает распределение вероятностей для следующего токена на основе закодированных векторов. Вместо жадного выбора одного токена на каждом шаге используется алгоритм beam search, который поддерживает несколько кандидатов перевода и выбирает финальный вариант с наибольшей вероятностью. Автор предлагает читателям обсудить, смогут ли фронтирные AI-модели вытеснить специализированные сервисы, подобные Google Translate.
Вместо жадного выбора одного токена за раз beam search использует декодер для поддержания нескольких кандидатных переводов во время генерации.
Agent Skills: как держать контекст агентов компактным и эффективным
ИИ и агенты · ByteByteGo · 7/10
Материал объясняет паттерн Agent Skills – подход к архитектуре ИИ-агентов, который решает проблему деградации производительности при использовании очень длинных промптов. Вместо одного монолитного промпта с инструкциями агент хранит каталог компактных, переиспользуемых скиллов (playbooks), которые загружаются в контекст только при необходимости.
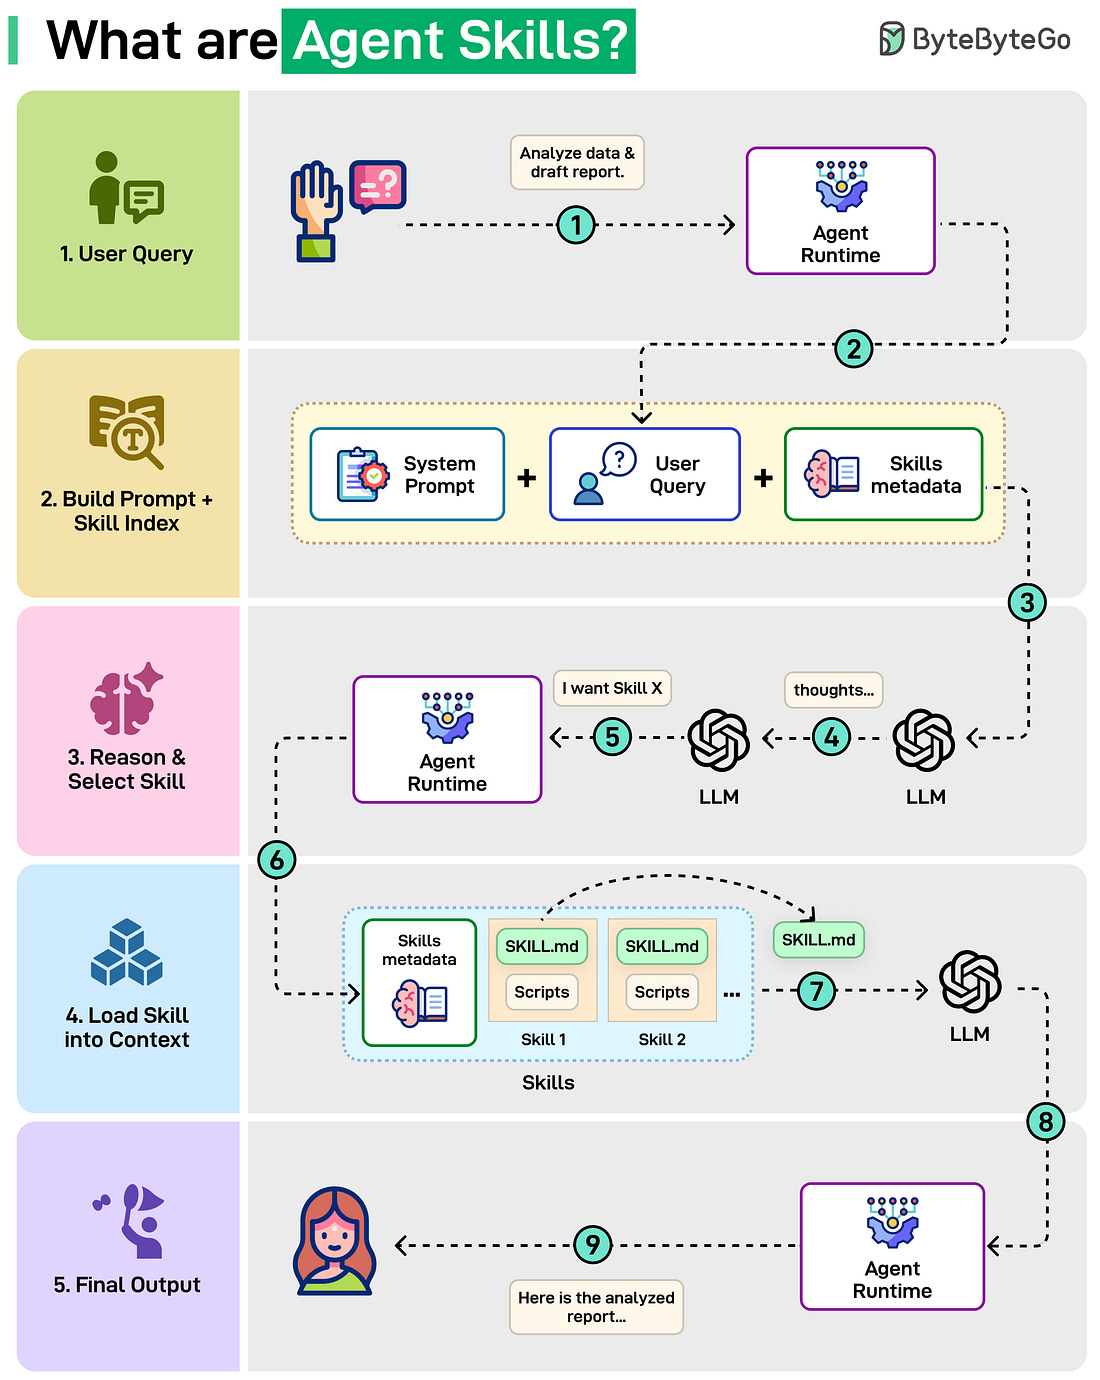
Процесс работает так: пользователь отправляет запрос (например, «Проанализируй данные и подготовь отчёт»), агент получает индекс доступных скиллов с их краткими описаниями, LLM анализирует задачу и выбирает нужный скилл, затем система загружает конкретный скилл в контекст модели, и та исполняет инструкции этого скилла, обращаясь к скриптам и генерируя результат. Такой динамический подход к загрузке компонентов позволяет держать контекст компактным и сохранять стабильное поведение модели.
Выводы автора:
- Длинные промпты снижают качество работы агентов; решение – хранить инструкции в виде модульных, динамически загружаемых скиллов.
- Индекс скиллов с метаданными позволяет LLM принять осознанное решение о том, какой инструмент использовать, вместо обработки всей информации сразу.
Вместо одного огромного промпта агенты хранят небольшой каталог скиллов – переиспользуемые playbooks с чёткими инструкциями, загружаемыми только по мере необходимости.
Настоящая BBS на калькуляторе Casio VX-4 через Telnet
Разработка и архитектура · Habr · 8/10
Автор воплотил амбициозный проект — создал работающую электронную доску объявлений (BBS) на калькуляторе Casio VX-4 с подключением к Интернету через Telnet. Всё началось с увлечения программируемыми карманными компьютерами Casio, написания программ на BASIC для любительского радио и идеи использовать возможности RS232-порта. Главные технические вызовы: работа с ограничением в 8 КБ ОЗУ базовой модели (хотя доступны модули на 32 КБ), обеспечение сетевого подключения и безопасности. Решение: Raspberry Pi Zero W используется исключительно для моста к Интернету и архивирования сообщений (в txt-файлах), а сам калькулятор полностью хостит BBS. BBS написана на BASIC, переключает COM-порт в режим прослушивания, требует ввода позывного радиолюбителя, предоставляет меню из четырёх функций (чтение, написание сообщений с лимитом 60 символов, информация, отключение). Подключение работает через стандартные Telnet-утилиты (Minicom, Termux, TERMinator). Ограничена одним одновременным соединением из-за вычислительных возможностей калькулятора и скорости последовательного ввода-вывода (4800 бод). Безопасность обеспечена через Tailscale и туннелирование.
Выводы автора:
- Возможно создать полнофункциональную Telnet BBS на калькуляторе 1980-х годов с 8 КБ ОЗУ благодаря минималистичному дизайну и ограничениям по функциональности.
- Использование Raspberry Pi Zero W в роли сетевого моста позволило подключить устаревшее оборудование к Интернету без изменения его базовой архитектуры и полной ответственности за хостинг.
Как насчёт BBS, которая хостится в калькуляторе с 8 КБ ОЗУ? Настоящая telnet BBS на калькуляторе. Прекрасно. Это и будет моим новым проектом.
Оригиналы:Настоящая BBS на калькуляторе Casio
Как российские крякеры взломали DRM принтеров и создали свой
Разработка и архитектура · Habr · 7/10
Материал рассказывает историю реверс-инжиниринга систем защиты в лазерных принтерах, которые искусственно ограничивают работу картриджей. Основная проблема: производители встраивают в картриджи фирменные чипы, считающие количество напечатанных страниц и блокирующие печать, даже если тонер ещё остался. Российско-украинские крякеры сначала взломали эту DRM для личного пользования, а затем коммерциализировали решение, создав собственную систему защиты прошивок. Это парадоксальный случай, когда сцена взлома изобрела собственный DRM — чтобы предотвратить бесконтрольную установку взломанных версий прошивок на принтеры бесконтрольно. Материал основан на архивных источниках и форумах, поэтому может содержать неточности. История интересна как редкий пример документирования кибербезопасностной активности в малоизвестном сегменте (кряки принтеров слабо освещены в англоязычной прессе).
Выводы автора:
- Производители используют встроенные чипы в картриджах для искусственного ограничения ресурса и принуждения к покупке оригинальных расходников
- Российско-украинские крякеры не только взломали DRM, но и создали собственную систему защиты, чтобы монетизировать решение
Сцена взлома принтеров изобрела собственный DRM
CloudMus: открытый кроссплатформенный плеер для Яндекс Музыки и YouTube Music
Разработка и архитектура · Habr · 7/10
Представлен открытый проект CloudMus — музыкальный плеер для Linux и Windows, объединяющий в одном интерфейсе Яндекс Музыку, YouTube Music и локальную музыкальную библиотеку с единой очередью и историей прослушивания. Приложение написано на C++20/Qt 6 под лицензией MIT и отличается современным визуалом с эффектом стеклянного интерфейса (размытие на KDE Plasma, Wayland и Windows 11), плавными анимациями и полной поддержкой русского языка. Архитектура построена на модульном принципе: каждый музыкальный сервис подключается через отдельный бэкенд на Python, работающий в отдельном процессе и взаимодействующий с интерфейсом через JSON-RPC. Среди ключевых возможностей — глобальные хоткеи, синхронизация лайков с аккаунтом, предзагрузка треков, скачивание плейлистов с сохранением тегов, поддержка прокси (особенно полезна в России для разных сервисов), MPRIS/SMTC-интеграция и встроенная система автообновления. Разработчики планируют перевести бэкенды на JavaScript с использованием песочницы QuickJS для повышения безопасности, добавить поддержку Spotify, Apple Music и других сервисов, реализовать полноценный офлайн-режим, а также выпустить версии для macOS и Android.
Выводы автора:
- CloudMus демонстрирует, как открытые проекты могут предоставить более удобное и интегрированное решение для потребления контента из разных источников, чем официальные приложения сервисов.
- Модульная архитектура с отдельными бэкендами позволяет легко добавлять поддержку новых музыкальных сервисов, а планируемый переход на JavaScript с песочницей улучшит безопасность пользователей.
- Проект показывает актуальность запроса на кроссплатформенное решение с поддержкой локальной музыки и интеграцией нескольких облачных сервисов в одном интерфейсе.
Каждый музыкальный сервис подключается через бэкенд, работающий в отдельном процессе и общающийся с интерфейсом по JSON-RPC через stdin/stdout.
Оригиналы:Представлен открытый плеер CloudMus для Яндекс Музыки и YouTube Music
PostgreSQL vs MySQL: архитектурные различия
Разработка и архитектура · ByteByteGo · 7/10
Материал сравнивает архитектурные подходы двух ведущих открытых СУБД – PostgreSQL и MySQL. PostgreSQL, написанный на C, использует процессный подход: главный процесс (Postmaster) координирует работу специализированных процессов, каждое подключение получает собственный процесс и доступ к общему пулу памяти, фоновые рабочие независимо обрабатывают задачи записи, очистки и логирования.
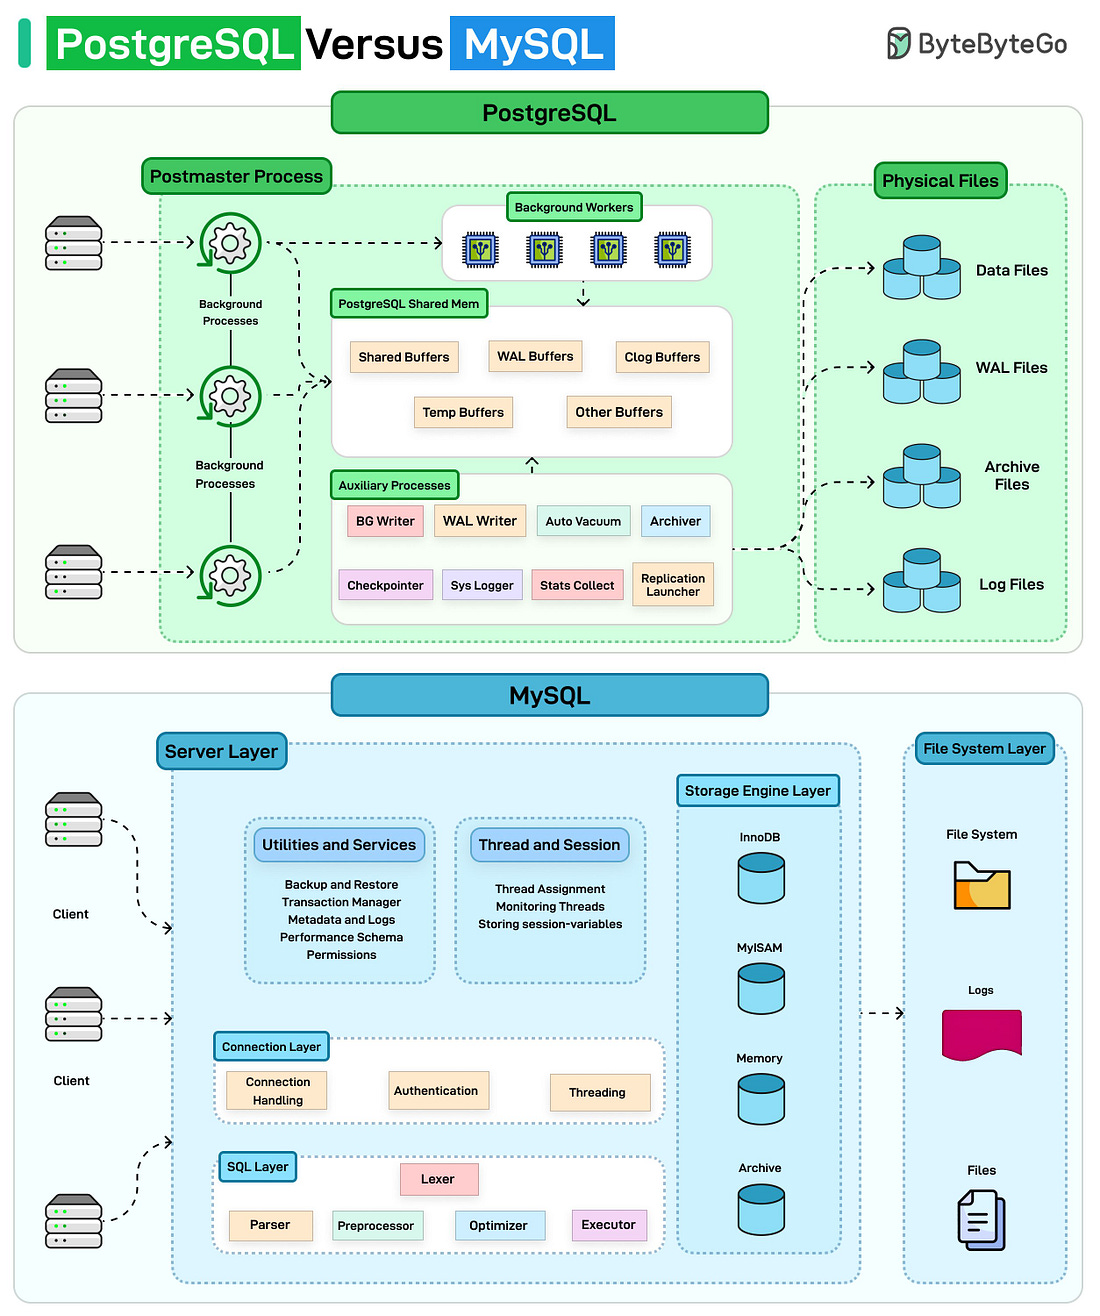
MySQL применяет многопоточный подход – один сервер обрабатывает множество соединений через потоки, подобно мультизадачному мозгу. Ключевая особенность MySQL – использование подключаемых хранилищ данных (InnoDB, MyISAM), которые можно менять в зависимости от потребностей. Автор приглашает читателей поделиться предпочтениями.
Выводы автора:
- PostgreSQL использует процессную архитектуру с выделенным процессом на каждое подключение, MySQL – многопоточный подход с единым сервером
- MySQL предлагает гибкость выбора хранилища данных через подключаемые модули
PostgreSQL работает как фабрика с менеджером, координирующим специализированных рабочих, а MySQL – как единый многозадачный мозг
Аппаратная защита в RISC-V: механизмы и затраты
Кибербезопасность · Habr · 8/10
Статья разбирает механизмы аппаратной защиты информации, уже реализованные или находящиеся в разработке в архитектуре RISC-V. RISC-V появилась в 2010 году как университетский проект в UC Berkeley и получила первую спецификацию в 2014 году. Главная фишка архитектуры — принцип «ядро плюс модули», который идеально подходит для микроконтроллеров: базовый набор команд (I) расширяется опциональными модулями (M для умножения, F/D для вычислений с плавающей точкой, V для векторизации и т.д.). RISC-V уже широко используется в IoT, промышленной электронике, медицинских устройствах и системах безопасности. Основной барьер развития — молодость архитектуры: цикл жизни микроконтроллера ~10 лет, а история RISC-V ненамного дольше. По безопасности угрозы стандартные: уязвимости ПО, атаки по побочным каналам, проблемы протоколов. Ключевые механизмы защиты включают: PMP (Physical Memory Protection) — задание доступа к регионам памяти, защищённый от обхода; IOPMP — расширение PMP для защиты от DMA-атак со стороны устройств; MMU — виртуальная память с режимами SV39/SV48/SV57; Landing pads и Shadow Stack — защита целостности потока управления против ROP/JOP-атак; Memory tagging — проверка валидности указателей через теги в верхних битах адреса (пока обсуждается); Zisb (Speculation barriers) — контроль спекулятивных вычислений против side-channel-атак. Каждый механизм требует компромиссов: площади кристалла, производительности (особенно IOPMP в полной модели), пересборки софта и поддержки компилятора.
Выводы автора:
- PMP — критически важный механизм защиты физической памяти в RISC-V микроконтроллерах, который нельзя обойти и конфигурируется один раз при запуске системы.
- Молодость архитектуры (12 лет) остаётся основным барьером для принятия в промышленности несмотря на адекватный уровень безопасности, сравнимый с конкурентами.
- Механизмы защиты целостности потока управления (Landing pads, Shadow Stack) требуют поддержки компилятора и пересборки библиотек для эффективной работы.
Один раз сконфигурировали, и сделать с этим ничего нельзя. Поэтому конфигурировать надо правильно.
Оригиналы:Аппаратная защита в RISC-V: что уже есть для микроконтроллеров и чего это стоит
Лицензионная чистота при использовании чужого кода: риски и обязанности
Кибербезопасность · Habr · 7/10
Статья разбирает юридические риски, которые возникают при использовании открытого кода в коммерческих продуктах, особенно когда речь идёт о копилефт-лицензиях. Ключевая проблема: вендоры часто помнят только о разрешительной части лицензии (возможность использовать и менять код), забывая об обязательствах. Копилефт-лицензии налагают на разработчика, распространяющего модифицированный код, обязанность раскрыть условия распространения собственных модулей и принять ответственность перед заказчиком за весь продукт — даже если исходный проект от гарантий отказывается. Проблема обостряется, когда исходный проект меняет лицензию, и тогда вопрос об ответственности становится критичным. Статья сопровождается примером и набором правил для самопроверки лицензионной чистоты, чтобы помочь компаниям контролировать юридические и безопасностные риски в цепочке поставок ПО.
Выводы автора:
- Вендоры, использующие копилефт-код, принимают на себя полную ответственность перед заказчиком за весь продукт, несмотря на отказ исходного проекта от гарантий.
- Необходимо внимательно изучать не только разрешительную часть лицензии, но и обязательства, которые она налагает на распространителя.
- Изменение лицензии исходного проекта может создать серьёзные юридические риски и требует переоценки компиляции кода.
Копилефт-лицензии определяют, что вендор обязан раскрыть, на каких условиях он распространяет собственные модули и кто отвечает перед заказчиком за продукт.
Оригиналы:Законодательство в IT: лицензионная чистота и ответственность вендора
Как госкорпорация присвоила софт за 24,7 млн рублей и отправила разработчиков в РНП
Продукт и карьера · Habr · 8/10
Основатель йошкар-олинской IT-компании «Омега Софт» описывает судебный конфликт с ООО «Транснефть-Технологии» по разработке системы цифровой диспетчеризации нефтепровода, критически важной для 13% ВВП страны. Компания разработала пилотное решение для автоматизации управления транспортировкой нефти (вместо ручного обмена таблицами Excel) и сдала его ровно в срок — 15 января 2025 года на USB-носителе с полными исходными кодами, документацией и инструкциями. Однако заказчик получил результаты работ, но отказался платить 24,7 млн рублей, ссылаясь на технические замечания. Корень проблемы: инфраструктурные службы «Транснефти» 7 месяцев не могли подготовить испытательный стенд, доступ предоставлен только 30 января (после срока). Когда сервера наконец заработали, система успешно запустилась, к самому коду замечаний не было — претензии касались оформления документации (из 459 замечаний заказчик сам вычеркнул 341, оставив 118). Арбитражные суды отказались назначать независимую ИТ-экспертизу, несмотря на очевидную техническую природу спора, и вынесли решение в пользу заказчика. Как итог: компания потеряла 24,7 млн рублей зарплаты для сотрудников, с неё взыскали гарантию 3,2 млн рублей и внесли в Реестр недобросовестных поставщиков. Автор называет происшедшее опасным прецедентом, который убивает стимулы независимых разработчиков участвовать в проектах технологического суверенитета.
Выводы автора:
- Суды отказались провести техническую экспертизу в спорах о качестве кода, вынося решения без понимания сути и создавая прецедент для присвоения интеллектуальной собственности крупными корпорациями.
- Задержка в предоставлении инфраструктуры со стороны заказчика рассчитана на то, чтобы после получения готового продукта можно было отказать в оплате, ссылаясь на нарушение сроков, которые заказчик сам сорвал.
- Отсутствие справедливого судебного механизма для разрешения технических споров наносит ущерб независимой IT-индустрии и государственным проектам по технологическому суверенитету.
Получается правовая модель расторжения контрактов: заказать софт, затянуть стенд, получить материалы на флешке, отказаться от оплаты. Если это засилить, ни один независимый разработчик не рискнет связаться с проектами суверенитета.
Оригиналы:Полная история на Habr
Мифы о зумерах-стажерах: что правда, а что предубеждение
Продукт и карьера · Habr · 8/10
Журналист из «Лаборатории Касперского» Кирилл разбирает популярные стереотипы о молодых стажерах поколения Z через интервью с тремя парами наставников и их подопечных. Автор обосновывает, почему такие стереотипы живучи: психологический эффект «дети в наши дни» (kids these days) заставляет людей судить молодежь строже, перенося на них свои собственные качества. Исследование 2019 года показало, что авторитарные люди обвиняют молодых в неуважении, читающие — в нелюбви к книгам, умные — в глупости.
Через блиц-опрос наставников выяснилось, что один и тот же штамп получает оценки от 0 до 9 баллов в зависимости от конкретного стажера. Например, страх звонков Кирилл оценил у Димы в 0 (за полгода звонил дважды), а Максим дал семерку. По нейросетям единственный пункт, где ни один бадди не поставил ноль: все стажеры их используют, но по-разному. Выяснилось, что часть оценок наставников — это не наблюдения, а опасения, под которыми нет фактических примеров. Вывод: не существует универсального зумера; каждый стажер — индивидуальность, и штампы разбиваются о живые примеры.
Выводы автора:
- Стереотипы о молодом поколении переживают века благодаря искажению памяти и когнитивным искажениям, а не объективным различиям между поколениями
- Один и тот же штамп может быть справедливым для одного стажера (оценка 7-9) и полностью неправда для другого (оценка 0), что показывает индивидуальные различия важнее возраста
- Наставники часто опасаются проблем, которые еще не произошли, что подтверждает, что предубеждения живут даже без фактической поддержки
Строже всего мы судим молодежь по тем качествам, которые у нас самих прокачаны сильнее всего.
Оригиналы:От них одни проблемы: кто боится стажеров-зумеров и стоит ли
Как AI переоценил зарплаты облачных инженеров: новый потолок $300K
Продукт и карьера · Tech Scoop Newsletter · 8/10
Компании переценивают роли облачных инженеров в эпоху искусственного интеллекта, сдвигая основной спрос и компенсацию в область специалистов, способных трансформировать инфраструктуру в измеримые AI-результаты. OpenAI объявила позиции Forward Deployed Engineer с окладом от $185K до $300K (исключая акции), заметно выше, чем традиционные роли AWS Solutions Architect ($131K–$207K в зависимости от уровня). Это отражает не просто циклическую инфляцию технических зарплат, а фундаментальный сдвиг в том, за что компании платят инженерам: если раньше ценилось умение масштабировать облачную инфраструктуру, то теперь премия идёт инженерам, которые работают с потребителями, решая бизнес-задачи через развёртывание frontier AI-моделей.
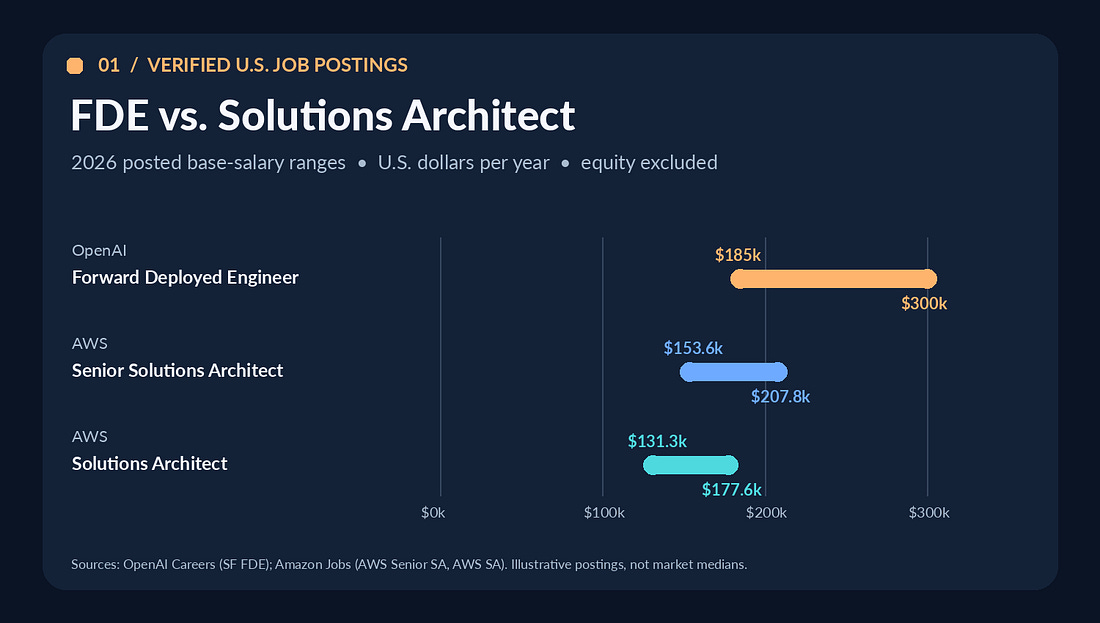
Хотя FDE-позиции у Palantir занижены ($135K–$200K), тренд показывает: элитные AI-компании готовы платить премиум за комбинацию глубоких технических навыков и клиентского взаимодействия. AI/ML-инженеры теперь явно получают значительный премиум над традиционными DevOps-специалистами, и спрос на инженеров, способных управлять production AI-системами, переформатирует, какие инфраструктурные умения работодатели ценят больше всего.
Выводы автора:
- Компании смещают фокус компенсации с традиционных облачных архитекторов на инженеров, способных развёртывать AI-решения и превращать их в бизнес-результаты.
- Elite AI-компании готовы предлагать необычно высокие оклады (до $300K) для инженеров, сочетающих глубокие технические навыки с клиент-фейсинг-компетенциями.
Инженеры, которые могут превратить эту инфраструктуру в измеримые AI-результаты, получают новую форму переговорной силы.
Оригиналы:Инженер за $300K: Как ИИ переписывает зарплаты облачных специалистов
Маргарет Гамильтон: математик, спасший лунную миссию
Продукт и карьера · Habr · 7/10
Статья рассказывает о жизни и достижениях Маргарет Гамильтон, выдающегося программиста и инженера, которая создала программное обеспечение для лунной миссии Apollo-11. За несколько минут до посадки на Луну 20 июля 1969 года бортовой компьютер начал выдавать критические сигналы ошибок 1201 и 1202 — компьютер был перегружен из-за избыточного потока данных от радара сближения. Однако программное обеспечение, спроектированное Гамильтон, автоматически перезагрузилось с контрольной точки, очистило очередь процессов и сохранило только критически важные задачи, позволив миссии успешно продолжиться. Гамильтон была одной из первых, кто развивал систему проектирования, способную справляться с ошибками, которые считались невозможными. Её вклад выходит далеко за пределы лунной программы — она посвятила жизнь развитию программного обеспечения как полноценной инженерной дисциплины. Маргарет Гамильтон скончалась в возрасте 90 лет, оставив значительное наследие в истории компьютерной науки.
Выводы автора:
- Маргарет Гамильтон предусмотрела необходимость обработки ошибок, которые считались невозможными, и создала систему, которая спасла миссию Apollo-11 от катастрофы.
- Её работа над обеспечением надёжности программного обеспечения была революционной и способствовала развитию软件工程 как полноценной инженерной дисциплины.
Маргарет действительно спасла космическую программу своего времени, после чего вошла в число серьёзных мыслителей, которые рассматривали программное обеспечение как полноценную инженерную дисциплину
Оригиналы:Статья на Habr: От медной шахты до Луны — путь Маргарет Гамильтон
Коротко
Разработка и архитектура
- Собственный переключатель раскладки на Delphi с низкоуровневыми хуками – Статья описывает разработку собственной утилиты для автоматического переключения раскладки клавиатуры на Windows, написанной на Delphi.
Кибербезопасность
- Check Point прокомментировала слухи о возможном уходе из России – Израильская компания Check Point опубликовала официальный комментарий по поводу информации о её возможном уходе с российского рынка.
Продукт и карьера
- Почему уведомления вредят продуктивности, даже если их игнорировать – Статья разбирает парадокс: автор когда-то сознательно отключил уведомления на основе рекомендаций из книг о продуктивности ("Джедайские техники" Максима Дорофеева), но спустя годы
Прочее
- Как устроен ограничитель скорости в лифте: механизм и электроника – Статья – подробный разбор устройства, обеспечивающего безопасность лифтов от падения.
- Многообразия Калаби-Яу: геометрия скрытых измерений в теории струн – Статья рассказывает о многообразиях Калаби-Яу — математических объектах, которые описывают шестимерные пространства и могут объяснить, как дополнительные измерения укладываются в ч
- Почему невозможно собрать Пятнашки, поменяв местами 14 и 15 – Статья объясняет, почему в головоломке Пятнашки (15 костяшек на доске 4×4) невозможно собрать элементы в правильном порядке, если поменять местами последние две костяшки (14 и 15).
- «Аэлита» Толстого: как марсианский роман стал первым советским фантастическим фильмом – Статья рассказывает об истории создания романа «Аэлита» Алексея Толстого (1921) и его экранизации режиссёром Яковом Протазановым.
- История романа «Аэлита»: от книги Толстого к первому советскому фантастическому фильму – Материал рассказывает об истории создания романа «Аэлита» Алексея Толстого, написанного в Берлине в 1921 году.