Дайджест за 16 октября 2026
GitHub превратил AI-рецензию кода в программируемый компонент CI/CD — это уже не просто помощник, а встроенный агент разработки. Параллельно Anthropic создала Scion, новую систему контроля версий для масштабирования AI-агентов, потому что обычный Git для них уже не справляется. Оказывается, качество ИИ-решений держится на согласованности словарей и данных, а Airbnb уже мучается с неожиданными счётами за AI-токены — но это их не останавливает.
Главное
- Принцип наследования качества: почему ИИ зависит от согласованного словаря
- GitHub сделал Copilot Code Review программируемым компонентом CI/CD
- GitHub сделал AI-рецензию кода программируемым компонентом CI/CD
- Как сцена взлома принтеров создала собственный DRM
- Как изменился рынок ЦОДов и облачной инфраструктуры после событий в Яндексе
Подробно
GitHub сделал AI-рецензию кода программируемым компонентом CI/CD
ИИ и агенты · Tech Scoop Newsletter · 9/10
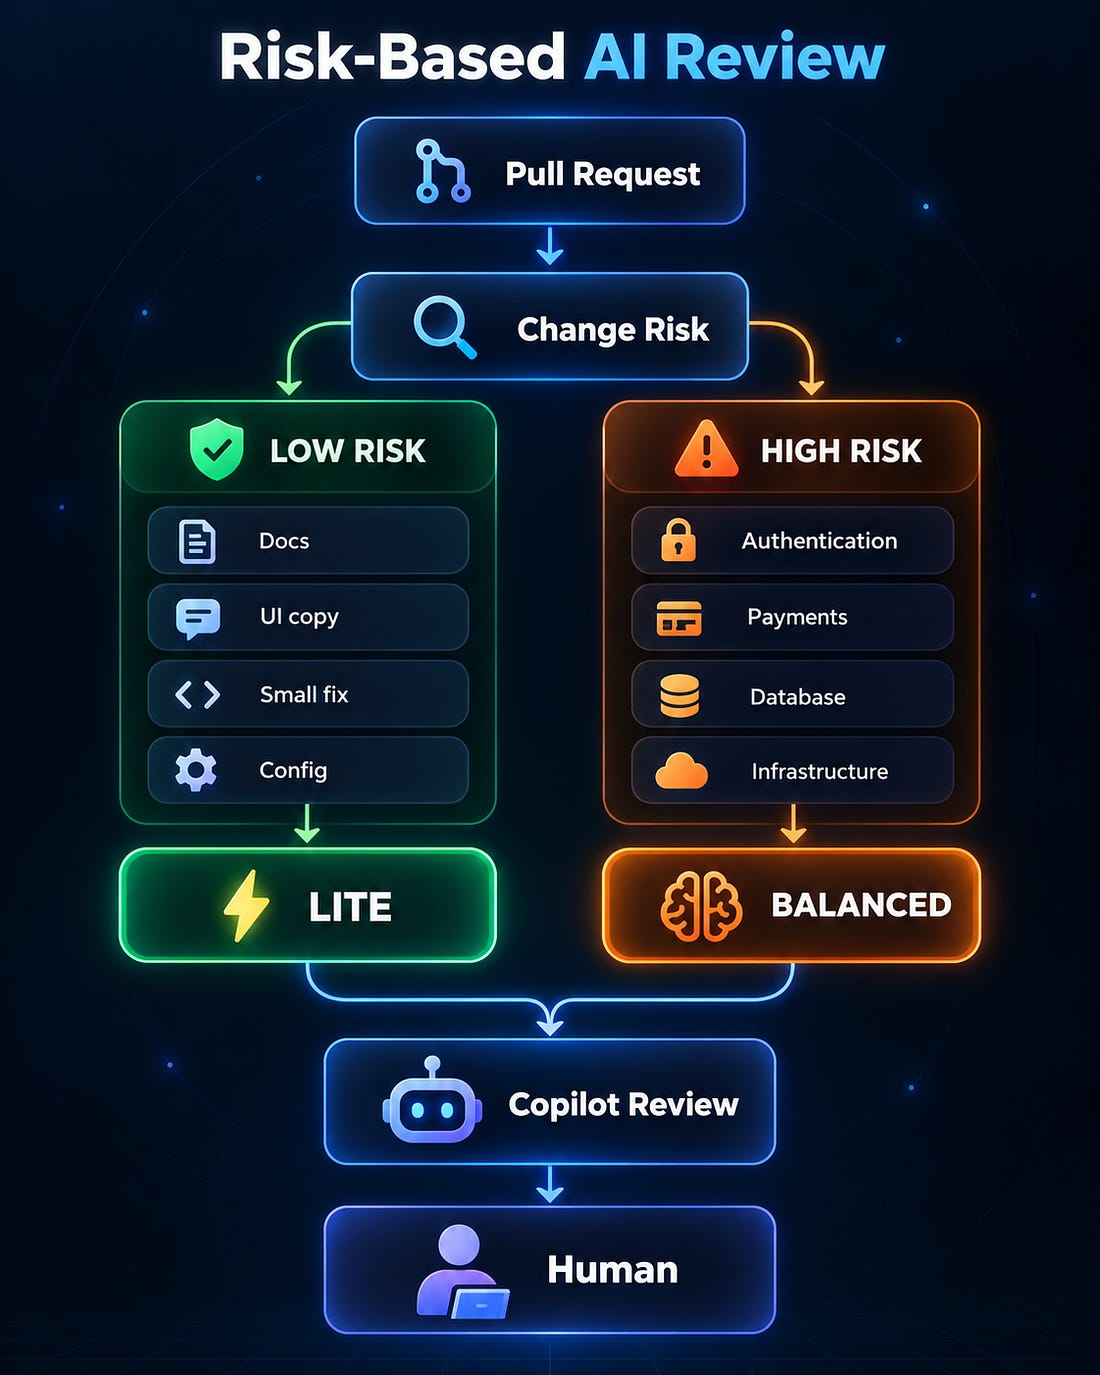
GitHub открыл REST и GraphQL API для Copilot Code Review, позволяя автоматизировать проверку pull request как часть конвейера разработки, а не ручной операции. Ключевое изменение — возможность программно указывать уровень анализа (Lite или Balanced), что создаёт архитектуру рецензирования на основе риска: документация может получить быструю проверку, а изменения в аутентификации или платежах — углублённый анализ. GitHub также изменил дефолт с Lite на Balanced (с соответствующим ростом затрат на AI-кредиты: $0.05–$1 vs $0.25–$5), что создаёт необходимость гибкой стратегии. Это особенно важно в эру AI-агентов, которые будут генерировать множество PR: вместо того чтобы человек вручную запрашивал рецензию, система может автоматически маршрутизировать её в зависимости от затронутых файлов, размера PR, наличия инфраструктурных изменений или того, создан ли PR агентом. Команды безопасности могут триггерить углублённую проверку для чувствительных директорий, а платформенные команды — предоставлять рецензию как сервис через внутренние портали разработчиков. Архитектура разделяет генерацию кода и верификацию, позволяя разным моделям и инструментам работать вместе в слоистом стеке проверок (тесты, статанализ, сканирование уязвимостей, AI-рецензия, человеческое суждение).
Выводы автора:
- API-управляемая рецензия кода превращает верификацию из бутылочного горлышка AI-разработки в масштабируемый компонент инфраструктуры, критичный для автономных кодирующих агентов.
- Риск-ориентированное маршрутизирование рецензии (лёгкие проверки для документации, углублённые для auth/payments/terraform) позволяет экономить вычислительные ресурсы, не ущемляя безопасность.
- Иерархическая система конфигурации (запрос → предыдущий PR → предпочтение юзера → репозиторий → организация → дефолт) превращает рецензию в policy engine, похожий на системы управления безопасностью и деплойментом.
Инженерный вызов смещается с 'Может ли ИИ писать код?' на 'Может ли наша инфраструктура верификации идти в ногу со скоростью генерации кода ИИ?'
Почему тексты, написанные ИИ, нечитаемы и как его использовать правильно
ИИ и агенты · Habr · 8/10
Эссе критикует бездумное использование больших языковых моделей для создания деловых текстов, дизайн-документов, описаний pull-request'ов и личных сообщений. Автор отмечает, что такие тексты теряют голос автора, контекст и личную позицию, становясь безжизненными и утомительными для чтения. Опрос Синтии Данлоп показал, что 78% разработчиков прекращают чтение, если подозревают ИИ-происхождение, а 98% предпочитают несовершенные, но аутентичные человеческие тексты. Однако ИИ может быть крайне полезен как инструмент поддержки: автор использовал его для проверки фактов, корректуры, форматирования цитат и создания технических диаграмм при написании научной статьи, не давая ИИ писать сами абзацы. LLM-модели выходят на плато в качестве писателей, так как письмо требует живого опыта и ментальной модели читателя. Для решения проблемы предлагаются инструменты вроде ASD-STE100 для технической документации и Pangram для детектирования ИИ-текстов, которые помогут восстановить доверие между автором и читателем.
Выводы автора:
- ИИ теряет ценность при полной генерации текстов, так как у читателя отсутствует контекст, имевшийся у автора при формулировке промпта
- ИИ наиболее полезен как помощник: корректор, проверка фактов, форматирование, упрощение сложных предложений, а не как основной автор
- Человеческое письмо со своим голосом и несовершенством ценнее для установления связи с читателями, чем безликие, сгенерированные машиной тексты
Обнаружив LLM, наш мозг посередине предложения нажимает на рукоять катапультирования в попытку спасти себя.
Оригиналы:Я не хочу читать то, чего вы не писали
Airbnb тратит больше на ИИ-токены, чем планировала, но это работает
ИИ и агенты · Substack · 8/10
Глава Airbnb Брайан Чески раскрыл, что компания значительно превысила бюджет на ИИ-токены в 2024 году, но рассматривает это как положительный сигнал благодаря высокой окупаемости инвестиций. После найма бывшего главы отдела генеративного ИИ в Meta на должность CTO в январе Airbnb переходит на ИИ-нативную архитектуру вместо простого внедрения ИИ в существующие процессы. Результаты впечатляют: время разработки продукта сократилось на 60%, количество выпущенных функций выросло на 80% год к году, численность сотрудников осталась примерно на том же уровне, а ИИ-агент разрешает около 45% проблем гостей без участия человека. Чески назвал ИИ «лучшим, что когда-либо случалось с Airbnb», подчеркнув, что повышенные расходы на инференс оправданы благодаря доходам от бронирований и ускорению процессов. Материал демонстрирует контрастный подход: если большинство CEO оправдывают перерасходы на ИИ, Чески видит в них подтверждение правильности стратегии.
Выводы автора:
- Переходить на ИИ-нативную архитектуру эффективнее, чем просто интегрировать ИИ в существующие процессы, если расходы на инференс окупаются через увеличение доходов и скорость
- Правильная инвестиция в ИИ позволяет одновременно сокращать время разработки (на 60%), увеличивать выпуск функций (на 80%) и держать численность команды стабильной
- ИИ-агенты способны решать значительную долю операционных задач (45% проблем гостей) без человеческого участия, что становится ключевым показателем успеха внедрения
Мы потратим намного больше на ИИ-токены, чем предполагали, но это отлично, потому что есть окупаемость инвестиций, и поэтому наша выручка намного выше.
Оригиналы:Airbnb тратит больше на ИИ-токены, чем планировала
Автоматический AI-review как новый примитив CI/CD в эпоху агентов
ИИ и агенты · Tech Scoop Newsletter · 8/10
Материал рассматривает эволюцию CI/CD-пайплайнов в контексте расширения роли AI-агентов в разработке. Когда кодирующие агенты берут на себя всё большую часть изменений в коде, традиционный workflow теряет эффективность: человек вынужден вручную запускать проверки и интерпретировать результаты, что нивелирует выигрыш от автоматизации. Автор предлагает API-triggered AI review как ключевой примитив, который отделяет генерацию кода от его верификации. Вместо единой системы, ответственной и за написание, и за проверку, появляется чёткое разделение: агент генерирует код, отдельная система (другой AI) проводит автоматическую проверку, агент исправляет находки, и только затем — человеческий ревью перед мержем.
Это создаёт асинхронный workflow, где верификация не становится узким местом. Основной инженерный вызов смещается: от вопроса «Может ли AI писать код?» к вопросу «Может ли инфраструктура верификации поспевать за скоростью, с которой пишет AI?».
Выводы автора:
- Автоматический AI-review станет критическим компонентом CI/CD в эру автономных кодирующих агентов, так как человеческое узкое место в проверке PR нивелирует всю пользу от автоматизации генерации.
- Архитектурно важна разделение генерации и верификации — разные системы должны отвечать за написание и проверку кода, чтобы избежать bias и обеспечить объективную оценку.
- Масштабируемость верификационной инфраструктуры, а не способность AI генерировать код, становится главным узким местом в современной разработке.
Инженерный вызов смещается: от вопроса «Может ли AI писать код?» к вопросу «Может ли инфраструктура верификации поспевать за скоростью AI?»
Оригиналы:Следующий примитив CI/CD может быть AI Code Review
На взломанной PS5 запустили Qwen с 27 млрд параметров через GPU
ИИ и агенты · Habr · 7/10
Разработчик abhi245y создал приложение PS5LM Plus, которое позволяет запускать языковые модели на графическом процессоре взломанной PlayStation 5. Проект развивает более ранний порт llama.cpp, но переписан с нуля для использования GPU вместо CPU, что дало доступ к 12 ГБ видеопамяти вместо 6 ГБ. Квантованная версия Qwen с 27 млрд параметров (UD-IQ2_XXS) занимает 6,8 ГБ и генерирует примерно 20,7 токена в секунду при контекстном окне в 64 тыс. токенов — это значительный прирост по сравнению с одним токеном в минуту на CPU. Приложение поддерживает модели в формате GGUF, может загружать их с локальных накопителей или Hugging Face, выводит на телевизор метрики (скорость, загрузку CPU, энергопотребление, температуру) и предоставляет OpenAI-совместимый API для подключения внешних клиентов. Для работы требуется взломанная PS5 с установленными etaHEN, kstuff и ShadowMountPlus. Код опубликован под лицензией GPL-3.0.
Выводы автора:
- Графический ускоритель PS5 позволяет запускать LLM с 27 млрд параметров в 20+ раз быстрее, чем на CPU консоли
- PlayStation 5 становится доступной платформой для локального запуска языковых моделей благодаря методам квантования и порту Vulkan
- PS5LM Plus поддерживает удалённое взаимодействие через OpenAI-совместимый API, превращая консоль в сетевой LLM-сервер
Все вычисления консоль выполняет локально, а отправлять запросы к модели можно с помощью веб-интерфейса и смартфона или компьютера в одной сети с PS5
Оригиналы:На взломанной PlayStation 5 запустили Qwen с 27 млрд параметров и 2-битным квантованием
Starling Bank тренирует банковскую ИИ модель на UK облаке, но зависит от Google и NVIDIA
ИИ и агенты · Linas from Linas's Newsletter · 7/10
Британский финтех Starling Bank объявил о создании первой банковской ИИ модели, обученной на британском суверенном облаке. Однако заявление содержит три существенных уточнения: модель ещё не обучена на реальных данных клиентов, при этом её архитектура всё равно полагается на технологии Google и NVIDIA, которые разработали эти модели первыми с гораздо большим объёмом данных. Кроме того, даже в «суверенной» схеме данные клиентов сначала проходят через Google Cloud перед тем, как попасть на Civo — британского провайдера. Модель должна запуститься для обнаружения мошенничества с начала 2027 года и позже для ИИ-ассистента. Уже минимум три другие кредитные организации используют похожие транзакционные модели, включая одну на неамериканском облаке. Важно отследить, как новая модель повлияет на Engine — программное подразделение Starling, которое меняет математику его IPO.
Выводы автора:
- Starling Bank внедряет ИИ для обнаружения мошенничества с 2027 года, но модель остаётся зависима от инфраструктуры Google и NVIDIA несмотря на использование британского облака
- Концепция «суверенности» облака имеет ограничения, так как данные клиентов всё равно проходят через Google Cloud на пути к Civo
Starling Bank говорит, что теперь строит первую банковскую ИИ модель, обученную на UK суверенном облаке — но заявление верно только с тремя уточнениями.
Оригиналы:Финансовые результаты Starling Bank на 2026 год · a16z State of Markets 2026: ИИ плейбук для основателей и инвесторов
AI-ревью кода как новый слой в CI/CD: возможности и границы
ИИ и агенты · Tech Scoop Newsletter · 7/10
Статья рассматривает использование AI-ревью (например, GitHub Copilot) как дополнительного примитива в CI/CD-конвейере, особенно для команд безопасности. Ключевое преимущество — способность выделять чувствительные части кода независимо от границ репозитория: директории с аутентификацией, авторизацией, криптографией, обработкой секретов, инфраструктурой и платёжной обработкой (/auth/, /iam/, /payments/, /secrets/, /terraform/, /kubernetes/). Система может автоматически запрашивать углублённую проверку при изменениях в этих директориях. Однако автор чётко подчёркивает: AI-ревью не должно заменять human-ревью, статический анализ, тестирование или угрозы моделирование. Вместо этого оно становится дополнительным слоем в стеке проверок: тесты → статический анализ → сканирование безопасности → AI-ревью → экспертное суждение. Этот многоуровневый подход здоровее, чем рассматривать AI как оракула, объявляющего код безопасным.
Выводы автора:
- AI-ревью кода эффективно для выявления изменений в чувствительных границах доверия, которые не всегда совпадают с границами репозиториев.
- AI-ревью должно дополнять, а не заменять существующие методы проверки безопасности (тесты, статический анализ, сканирование, ревью человеком).
- Здоровая модель безопасности предполагает многослойную проверку, где AI выступает одним из инспекционных слоёв наравне с другими инструментами.
Система может эффективно сказать: это изменение затронуло чувствительную границу доверия. Увеличьте глубину ревью.
GitHub сделал Copilot Code Review программируемым компонентом CI/CD
Разработка и архитектура · Tech Scoop Newsletter · 9/10
GitHub превратила ручную кнопку проверки кода Copilot в API, который можно вызывать из CI-пайплайнов, агентов ИИ и систем безопасности. Это стало критически важным в эпоху автоматизированной генерации кода, когда узким местом становится верификация, а не разработка.
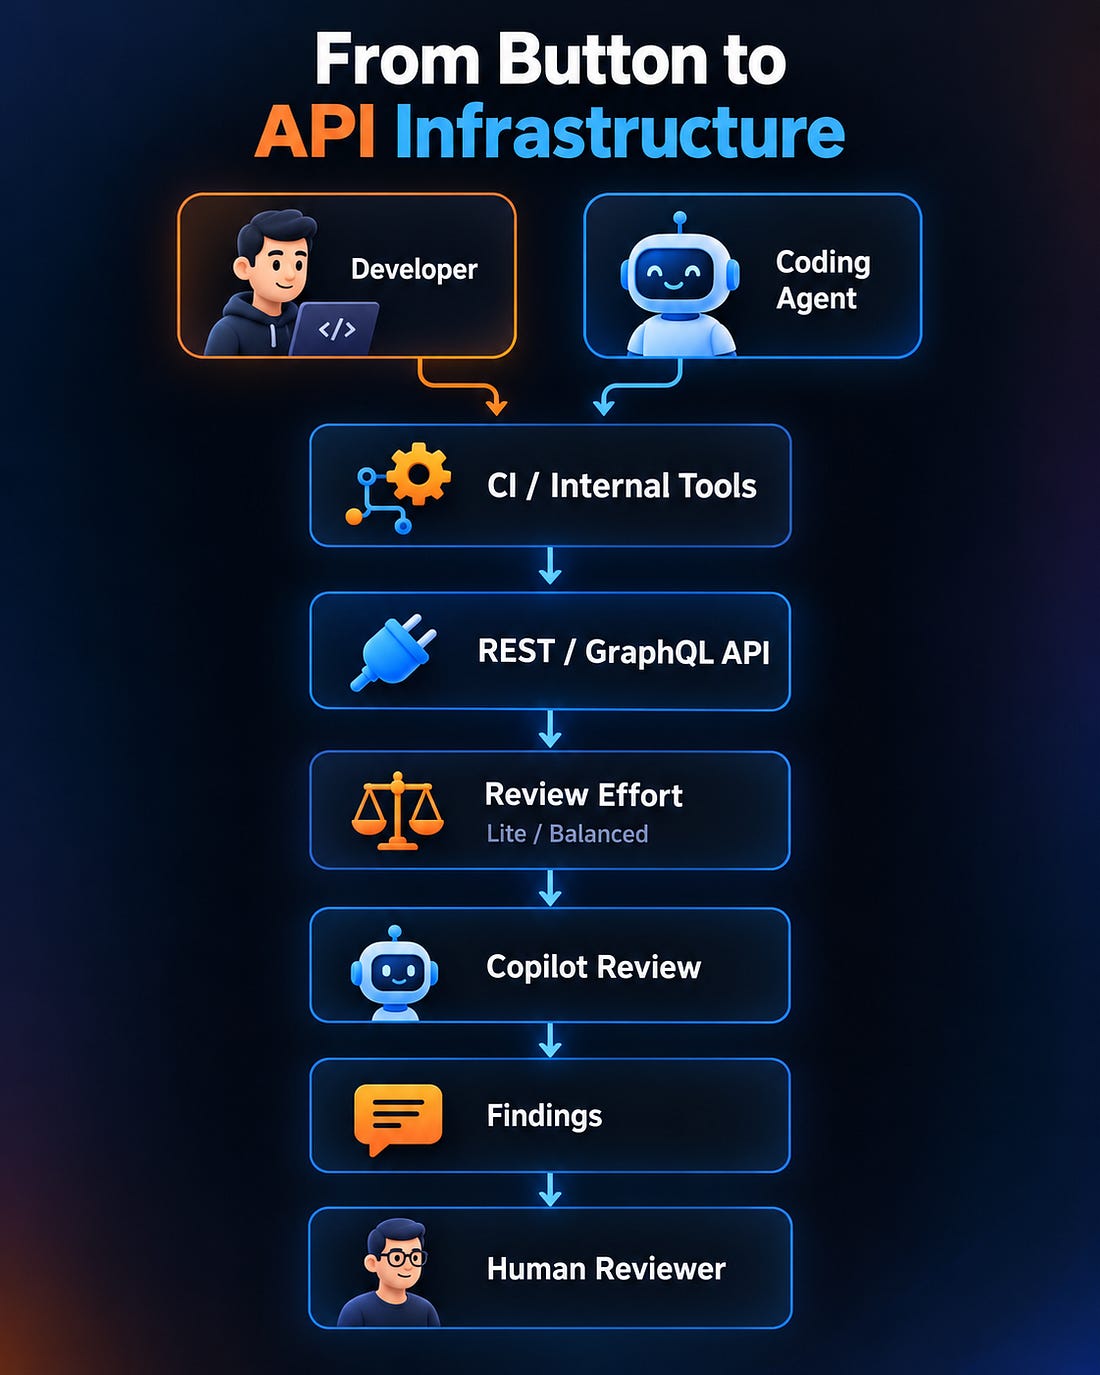
Главные нововведения: REST и GraphQL API для запроса проверок, программируемое управление глубиной анализа (Lite для рутинных изменений ~$0.05–$1, Balanced для критичного кода ~$0.25–$5), и смена дефолта с Lite на Balanced. Это позволяет командам реализовать risk-based review policies — направлять глубокий анализ в критичные части кода (auth, payments, terraform), а быструю проверку в routine changes (документация, UI). Архитектурно это создаёт policy engine с иерархией приоритетов (requested effort → previous PR effort → user preference → repository setting → organization setting → GitHub default). Для security-команд API открывает триггеры на чувствительные директории; для platform-инженеров — возможность упаковать review как сервис во внутренний девелопер-портал. В эпохе agentic coding возникает полезное разделение: один агент генерирует код, независимый Copilot его проверяет, детерминированные тесты валидируют, человек принимает финальное решение.
Выводы автора:
- Code review становится программируемым инфраструктурным компонентом, а не ручной фичей, что критично для автоматизированной разработки на агентах.
- Risk-based policies позволяют оптимизировать затраты на верификацию, направляя глубокий анализ только на критичный код (auth, payments, infrastructure) вместо всего подряд.
- Архитектура создаёт здоровое разделение ответственности между генерацией кода (агент), верификацией (Copilot), тестированием и финальным человеческим решением.
Инженерный вызов смещается с вопроса «может ли ИИ писать код?» на «может ли наша инфраструктура верификации поспевать за скоростью, с которой ИИ пишет код?»
Оригиналы:GitHub Copilot Code Review теперь доступна через REST и GraphQL API
Как изменился рынок ЦОДов и облачной инфраструктуры после событий в Яндексе
Разработка и архитектура · Habr · 8/10
Статья разбирает трансформацию российского рынка дата-центров и облачных сервисов после поражения ЦОДов Яндекса БПЛА в мае 2024 года. Компания h3llo.cloud делится наблюдениями о кризисе: многие конкуренты резко подняли цены, но сама компания их не повышает; из IXcellerate вывезено почти всё оборудование на собственные площадки. Клиентский профиль изменился кардинально — теперь приходят крупные корпорации со специфическими требованиями (managed Kubernetes, обработка персональных данных на территории РФ) вместо малых пользователей. Архитектура новых ЦОДов переосмыслена: площадки внутри Москвы не выглядят как ЦОДы, инфраструктура распределена по большой площади без единых точек отказа, вместо плотных машзалов. Концепция Disaster Recovery полностью пересмотрена — теперь проектируют на случай целенаправленного удара в критичные узлы, а не просто сбоя оборудования. На рынке возрождаются микроЦОДы — компании намеренно разносят серверы на десяток разных площадок. Вопрос гибридной инфраструктуры (on-premise + распределённые облака) стал критически острым.
Выводы автора:
- Концепция Disaster Recovery изменилась навсегда: теперь нужно проектировать на случай целенаправленного удара в самые критичные узлы и целые регионы, а не просто техсбоев
- Архитектура современных ЦОДов трансформируется от плотных машзалов к распределённой инфраструктуре на большой площади с множеством независимых точек присутствия
- Рынок смещается от малых виртуализированных ресурсов к крупным корпоративным клиентам с требованиями по отказоустойчивости и обработке персональных данных на территории РФ
Концепция отказа целого региона или отвала крупного провайдера перестала быть чем-то из области мифических единорогов, которых никто никогда не встретит.
Оригиналы:Что сейчас происходит с ЦОДами, рынком и беженцами из Яндекса
Anthropic создала Scion — замену Git для масштаба ИИ-агентов
Разработка и архитектура · Habr · 8/10
Anthropic разработала собственную систему контроля версий Scion, заменив Git для своего монорепозитория, так как объём кода, генерируемого ИИ-агентами, превысил возможности традиционного Git. С мая по сентябрь 2026 года число мерджей в основную ветку выросло с 2500 до более чем 30000 в день, история ветки весит 100 ГБ, рабочая копия — 25 ГБ, а общий трафик достигал бы 600 ПБ в сутки. Git проектировался для распределённой работы с локальными копиями, но у Anthropic почти все клиенты — это онлайн-агенты, начинающие с чистого листа каждый раз.
Scion — централизованная система на основе changesets с уровневым кэшированием (региональные кэши, авторитетные серверы) и долей попаданий выше 99% на каждом уровне. Результаты впечатляют: инфраструктура потребляет в 200 раз меньше CPU и памяти, чекауты ускорились с минут до секунд, CI получил 25% свободной мощности. Семь инженеров создали Scion и инструмент ревью Antique за пять месяцев, а миграция данных, переписанная Claude, использует в 20 раз меньше памяти и работает в 4 раза быстрее. Компания отмечает, что escribать код стало дёшево, а проверка, слияние и CI — дорого, поэтому перешла на тестирование после мерджа. Scion не будет открытым; Anthropic считает его непригодным для общего использования и рекомендует GitHub платформам улучшить серверные RPC и режимы sparse/shallow.
Выводы автора:
- ИИ-агенты генерируют код с такой скоростью, что классические распределённые системы контроля версий (Git) становятся узким местом и требуют переосмысления архитектуры разработки
- Централизованный дизайн Scion с многоуровневым кэшированием решает проблему масштаба, но требует пересмотра подходов к CI/CD и ревью кода для работы с агентами
- В системах, где агенты пишут основной объём кода, роль человека смещается с генерации к валидации и ограничению, требуя нового баланса между автоматизацией и контролем
Написать код теперь дёшево, а принять, проверить, слить и прогнать через CI — дорого.
Оригиналы:Почему Anthropic написала собственную замену Git и чему это учит остальных
Тренд создания внутренних AI-платформ для non-engineers в крупных tech-компаниях
Разработка и архитектура · The Pragmatic Engineer · 8/10
Статья о растущем тренде в крупных tech-компаниях самостоятельно разрабатывать внутренние AI-платформы для кодирования ("internal Lovables") вместо использования готовых внешних решений. Ramp разработала Glass – платформу на основе AI vibe-coding для non-engineers, позволяющую создавать сложные приложения с подключением к внутренним системам как источникам данных; это решение стало настолько популярным, что вошло в программу onboarding для новых сотрудников. Stripe построила похожий инструмент Harbor, разработанный одним инженером за 6 недель. Основные причины, по которым компании предпочитают собственные решения: минимальные инвестиции (несколько инженеров на несколько недель), безопасность работы с внутренними данными, соответствие внутренним дизайн-гайдлайнам, высокий уровень внедрения среди non-engineers, отсутствие зависимости от вендоров и возможность обучения инженеров на практике. Автор ожидает, что многие крупные tech-компании, уже имеющие собственные системы для запуска AI-агентов в облаке, будут следовать этому тренду.
Выводы автора:
- Для компаний с сотнями инженеров создание собственного internal vibe-coding инструмента – минимальная инвестиция, дающая гораздо более высокое внедрение среди non-engineers, чем готовые решения вроде Lovable
- Внутренние платформы решают проблемы безопасности данных и соответствия внутренним стандартам проектирования, которые внешние вендоры не могут гарантировать
- Разработка собственных AI-инструментов служит образовательной целью и помогает компаниям подготовить инженеров в области AI-инфраструктуры в период дефицита специалистов на рынке
Это не особенно сложно, дает гораздо более высокое внедрение, чем готовые продукты вендоров, и помогает нарастить внутреннюю экспертизу в области AI-инфраструктуры.
Оригиналы:The Pulse: новый тренд создания внутренних приложений вибе-кодирования в tech-компаниях · Gergely Orosz – The Pragmatic Engineer
Copilot Code Review как программируемый примитив CI/CD
Разработка и архитектура · Tech Scoop Newsletter · 8/10
GitHub превращает AI code review из ручной функции в автоматизированный компонент конвейера разработки через REST и GraphQL APIs. Начиная с октября 2026 года разработчики могут программно запросить проверку кода с указанием уровня глубины анализа (Lite, Balanced, Thorough). Одновременно GitHub изменил дефолтный уровень проверки с Lite на Balanced (с 28 сентября 2026 года), стимулируя более глубокий анализ кода. Это решает критическую проблему: по мере автоматизации написания кода через AI-агентов, проверка кода рисковала стать узким местом конвейера CI/CD. Программируемый API позволяет встроить проверку Copilot прямо в процесс непрерывной доставки, синхронизируя скорость генерации и верификации кода. Такой подход сигнализирует о качественном сдвиге в архитектуре разработки — от инструментов помощи разработчику к элементам полностью автоматизированного конвейера.
Выводы автора:
- GitHub интегрирует AI code review в конвейер CI/CD через REST и GraphQL API, позволяя автоматизировать проверку кода наравне с его генерацией.
- Смена дефолтного уровня проверки на Balanced стимулирует более глубокий анализ и решает проблему узкого места в автоматизированном workflow.
GitHub is turning AI code review from a feature developers manually invoke into a programmable component of the software delivery pipeline — Если генерация кода становится автономной, а проверка остаётся ручной, верификация становится узким местом.
GitHub Copilot Code Review: от бинарности к программируемой интенсивности проверок
Разработка и архитектура · Tech Scoop Newsletter · 8/10
GitHub объявила о способности настраивать интенсивность AI-ревью кода — ключевое развитие в интеграции искусственного интеллекта в CI/CD-процессы. Компания предоставляет два уровня ревью: Lite для быстрых, целевых проверок рутинных изменений (баги, уязвимости, стиль) и Balanced, использующий более мощные модели для анализа сложной логики, кода с проблемами безопасности и кроссервисных изменений. Главное в том, что команды теперь не выбирают между включением и отключением AI-ревью, а принимают решение об адекватном уровне проверки для каждого изменения. Это позволяет перейти от бинарного подхода к риск-ориентированным политикам ревью, где интенсивность проверки зависит от важности и сложности кода.
Выводы автора:
- AI-ревью кода переходит от бинарного выбора (вкл/выкл) к программируемой модели, где уровень проверки настраивается в зависимости от риска изменения
- Differentiated review levels (Lite и Balanced) позволяют оптимизировать скорость разработки, направляя ресурсы на действительно критичные части кода
Команды больше не думают об AI-ревью как о простом выборе "включить или выключить", а начинают задавать вопрос: "Сколько проверок заслуживает это изменение?"
AI-ревью кода как сервис: новая примитива CI/CD
Разработка и архитектура · Tech Scoop Newsletter · 8/10
Материал разбирает, как AI-powered code review (например, GitHub Copilot) интегрируется в internal developer platforms и становится стандартным сервисом для разработчиков. Большие организации всё чаще предоставляют инженерные возможности через внутренние портали разработчиков, где рядом с кнопками развёртывания, создания preview-окружения и запуска тестов теперь появляются варианты автоматического ревью кода — как быстрое, так и глубокое, включая проверки безопасности и анализ изменений от AI-агентов. Разработчик при этом не должен знать о REST или GraphQL запросах под капотом. Автор формулирует общий паттерн эволюции продуктовой функциональности в инфраструктуру: сначала появляется кнопка, затем API, затем workflows используют этот API, и в итоге базовая возможность скрывается за высокоуровневыми политиками платформы.
Выводы автора:
- AI code review эволюционирует из отдельного инструмента в примитиву внутренней платформы разработчика, подобно deploy и тестированию.
- Platform engineering teams могут предоставлять разные варианты review как единый сервис через портал, избавляя разработчиков от знания технических деталей интеграции.
Когда продуктовая функциональность созревает в инфраструктуру: сначала есть кнопка, потом API, потом workflows её вызывают, и в итоге базовая возможность исчезает за высокоуровневыми политиками.
AI-код ревью как новый примитив CI/CD: агентная верификация вместо прямой отправки
Разработка и архитектура · Tech Scoop Newsletter · 8/10
Материал разбирает перспективное применение AI-агентов в автоматизации разработки — использование независимого AI-ревьюера (Copilot) для проверки pull requests, созданных другим кодовым агентом. Вместо прямой передачи кода от агента к человеку в workflow встраивается промежуточная верификация AI, создавая разделение ответственности: один агент генерирует код, другой его оценивает, детерминированные тесты проверяют функциональность, человек принимает финальное решение. Автор считает, что такая архитектура станет стандартом по мере развития agentic разработки. Важное замечание: по умолчанию Copilot Code Review оставляет только комментарий, а не автоматическое одобрение — команды не должны слепо доверять AI-ревью и всегда требовать человеческого подтверждения.
Выводы автора:
- Самые ценные инженерные системы в будущем — это не те, что генерируют больше всего кода, а те, что обладают сильнейшими циклами верификации сгенерированного кода
- Аgentic верификация (когда один AI проверяет работу другого) создаёт полезное разделение ответственности между генерацией, оценкой, тестированием и человеческим решением
- Автоматическое AI-одобрение PR по умолчанию опасно — системы должны оставить за людьми финальный контроль над слиянием кода
Самые ценные инженерные системы могут быть не теми, что способны генерировать самый больше код, а теми, что имеют сильнейшие циклы верификации вокруг сгенерированного кода
Оригиналы:Полный текст: The Next CI/CD Primitive Might Be AI Code Review
Самохостинг 10 ТБ на ноутбуке и тренд возврата на собственные серверы
Разработка и архитектура · Habr · 7/10
Статья рассказывает о растущем тренде перехода компаний и энтузиастов с облачных сервисов на собственные серверы. В качестве примера приведена история американского разработчика Джеймса О'Клэра, который создал аналог Amazon S3 на ноутбуке Framework, подключив пять внешних дисков по 8 ТБ через USB-стойку с помощью открытого проекта Garage. За пять месяцев система накопила 10 ТБ данных и работала без вмешательства и проблем. Почтовый провайдер Fastmail привёл финансовые расчёты: хранение 1 ПБ данных в год стоит $11 880–$252 000 в облаке (в зависимости от типа сервиса), тогда как собственный сервер 2U с 220 ТБ обходится примерно в $6000 в год. Движение IndieWeb агитирует за создание персональных независимых веб-сайтов и полный самохостинг контента, напоминая подход интернета 1990-х годов. В июне 2026 года запущена кампания по созданию новой доменной зоны .self специально для самохостинга. Главный минус самохостинга — необходимость нанимать опытного локального администратора с широким набором навыков.
Выводы автора:
- Самохостинг на собственном оборудовании экономически оправдан при больших объёмах данных и может быть на 90% дешевле облачных сервисов
- Даже простой ноутбук с внешними дисками способен стабильно работать в качестве объектного хранилища, если правильно настроить энергопитание и файловую систему
- Растёт философское и практическое движение за независимость контента и возврат к самохостингу веб-сайтов и приложений
Если контент не на твоём HDD, то ты не полностью контролируешь его — таков принцип хардкорного IndieWeb.
Оригиналы:Самохостинг 10 ТБ на ноутбуке, свой сервер вместо облака · Компьютерное железо
Универсальный дизассемблер в одном HTML-файле для ARM64, x86, WASM, .NET и Java
Разработка и архитектура · Habr · 7/10
Представлен компактный дизассемблер, который работает в одном HTML-файле размером 1,22 МБ и не требует установки или интернета. Инструмент поддерживает дизассемблирование бинарников для ARM64, 32-битного ARM, x86-64, i386, WebAssembly, .NET (CIL) и Java байт-кода из форматов Mach-O, ELF, PE, APK и IPA для macOS, iOS, Linux, Android и Windows. Основной функционал включает просмотр машинного кода с возможностью отключения, описание мнемоник на русском языке, фильтр функций, деманглинг, импорт и экспорт данных. Инструмент содержит подробную статистику как общую, так и по мнемоникам, позволяет просматривать строки и информацию контейнеров. Бонусная возможность — редактирование инструкций для macOS ARM с переподписью и запуском программы. Автор позиционирует его как удобный инструмент для быстрых проверок, обучения и анализа архитектуры библиотек, не претендующий на замену полнофункциональным дизассемблерам вроде Ghidra или IDA Pro.
Выводы автора:
- Компактный кроссплатформенный дизассемблер размером 1,22 МБ удобен для быстрых проверок и обучения благодаря отсутствию необходимости установки и работе без интернета.
- Инструмент предоставляет полезную функцию статистики по инструкциям, аналогов которой автор не находил в других дизассемблерах.
- Это специализированный инструмент для своей ниши, а не замена взрослым дизассемблерам, но удобен своей простотой и универсальностью поддерживаемых архитектур и форматов.
Главное, что это удобно — открыл, и всё работает, не тратишь время на установку, добавление плагинов.
Оригиналы:Дизассемблер для arm64, x86-64, i386, WebAssembly, .NET и Java — в одном HTML-файле · Системное программирование
Эффективная реализация модулятора CPFSK на STM32 с использованием векторного поворота
Разработка и архитектура · Habr · 7/10
Статья описывает оптимизированный метод синтеза сигналов с модуляцией CPFSK (Continuous-Phase Frequency-Shift Keying) на микроконтроллерах STM32 на базе ядра Cortex M3. Автор — опытный инженер телекома — предлагает решение на основе векторного поворота на комплексной плоскости вместо прямого вычисления синуса и косинуса, что значительно снижает нагрузку на процессор. Ключевая идея: сигналы представляются как проекции единичного вектора (I = cos(α), Q = sin(α)), который поворачивается на фиксированный угол при помощи матрицы поворота. Реализация включает периодическую коррекцию вектора для компенсации ошибок округления, функции экспоненциального затухания и разгона амплитуды на границах символов, а также возможность суммирования отсчётов для поддержки сложных модуляций типа OFDM. Весь критический код написан на ассемблере Cortex M3 с применением специальных трюков масштабирования коэффициентов для повышения точности вычислений в 32-битной арифметике.
Выводы автора:
- Векторное вращение на комплексной плоскости с периодической коррекцией обеспечивает эффективный синтез непрерывной фазовой модуляции на микроконтроллере при минимальной нагрузке на процессор.
- Использование экспоненциального затухания и разгона сигнала решает проблему гладкого сшивания символов, сохраняя непрерывность фазы.
- Архитектура позволяет реализовать не только простую CPFSK, но и сложные модуляции через суммирование отсчётов в буфере.
Сигналы sin(x) и cos(x) рассматриваются как проекция вектора на комплексную плоскость; поворачивая этот вектор с нужным шагом угла, можно получить требуемую частоту отсчётов.
Оригиналы:Модуляция CPFSK и не только в квадратурах на микропроцессорах STM32
Как проектировать системы, устойчивые к сбоям
Разработка и архитектура · ByteByteGo · 7/10
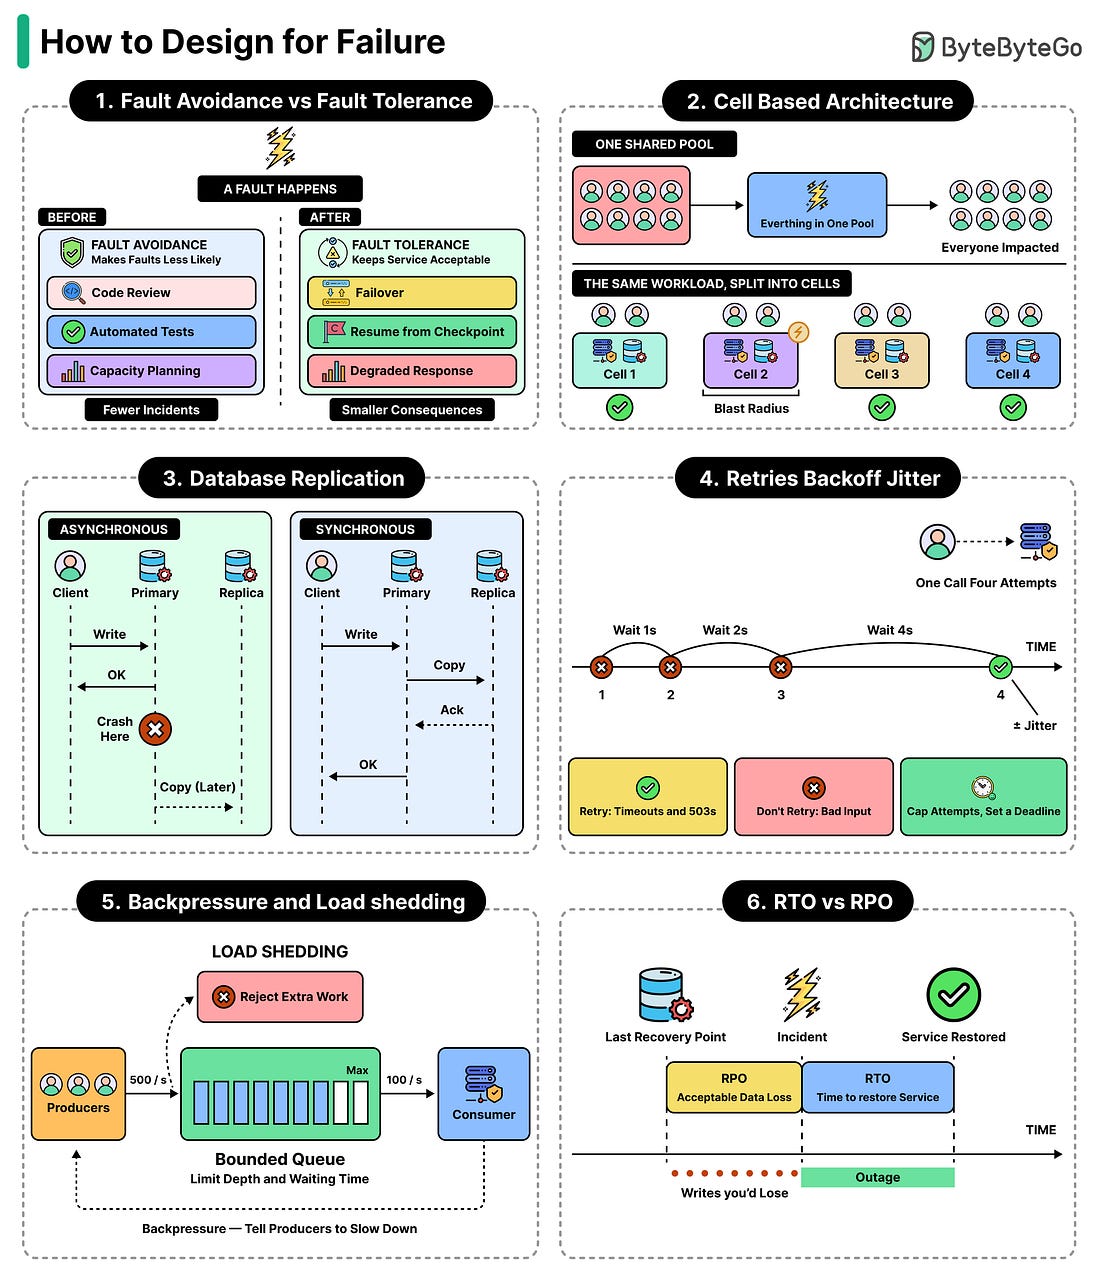
Статья от ByteByteGo посвящена стратегиям проектирования отказоустойчивых систем, поскольку невозможно построить абсолютно надёжное ПО. Автор объясняет, что даже идеально написанный код зависит от физического оборудования, электроснабжения и хранилища — факторов, которые могут привести к сбою независимо от качества кода. Материал охватывает ключевые подходы: принцип «всё может сломаться», различие между избеганием и toleration сбоев, определение области сбоя, снижение его влияния, правильную обработку сбоев в работающей системе и измерение восстановления. Статья призывает разработчиков заранее принимать решения о поведении системы при отказе компонентов, а не полагаться на идеальный код.
Выводы автора:
- Невозможно гарантировать отсутствие сбоев — нужно проектировать системы с расчётом на отказы компонентов
- Проектирование отказоустойчивости включает избежание сбоев, их переносимость, ограничение области воздействия и правильное восстановление
Даже идеально написанное ПО зависит от физического компьютера, питания и работоспособности хранилища — если машина потеряет питание, ПО сломается, независимо от качества кода.
Оригиналы:How to Design for Failures
GitHub изменил дефолт Copilot Code Review с Lite на Balanced
Разработка и архитектура · Tech Scoop Newsletter · 7/10
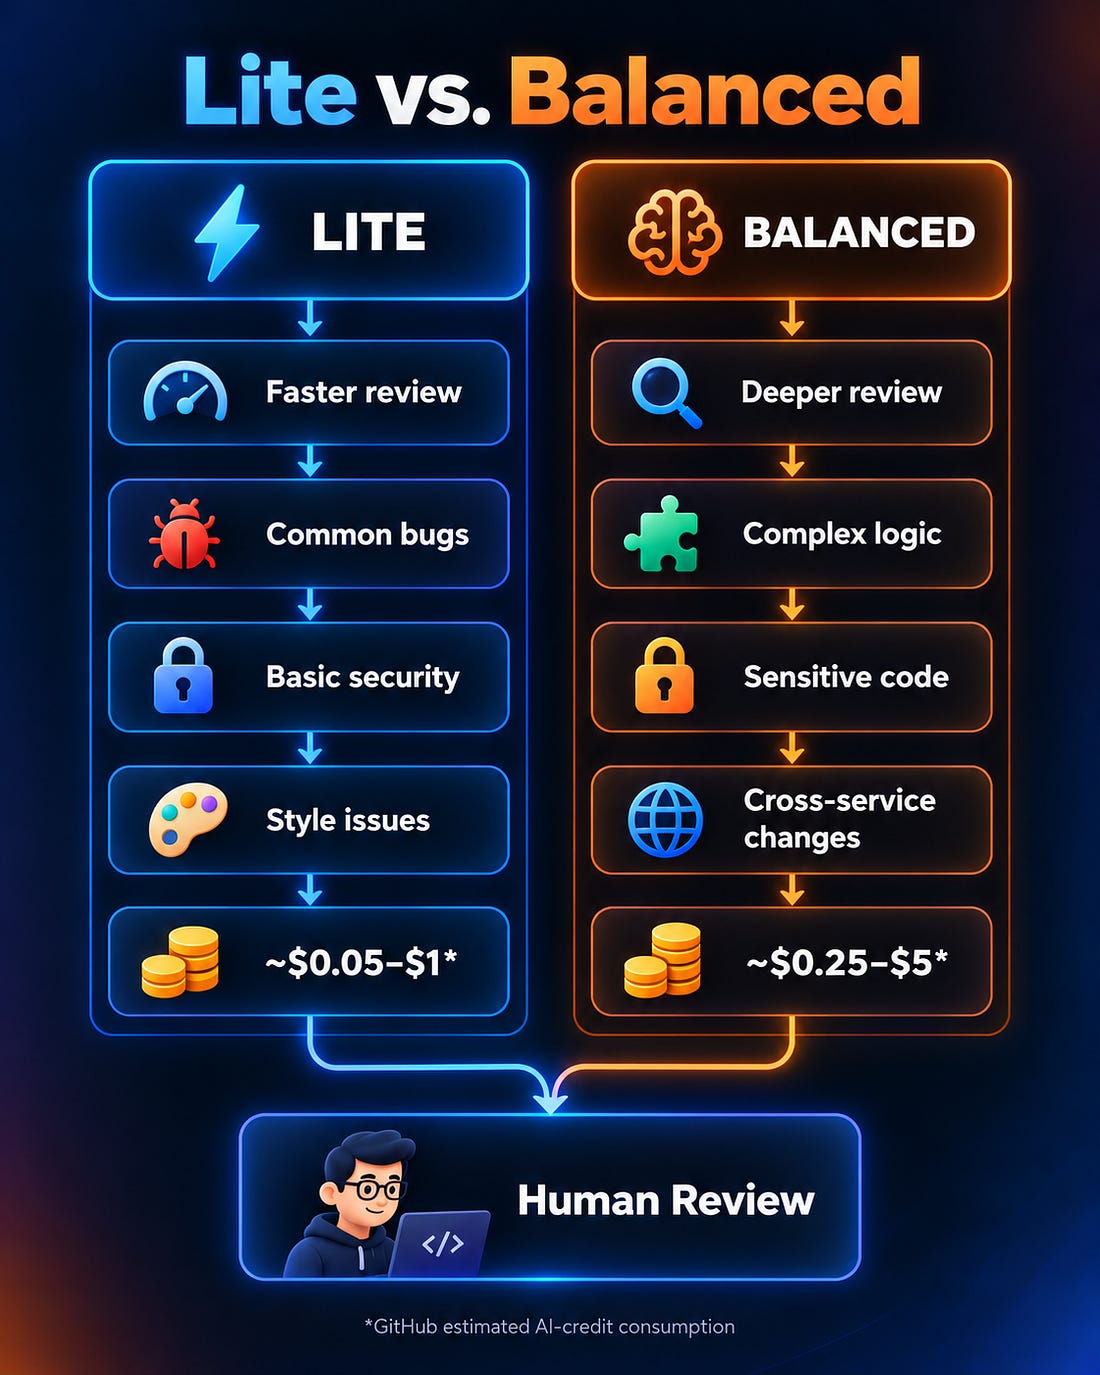
GitHub изменил стандартное поведение Copilot Code Review, установив режим Balanced вместо Lite для всех новых и существующих репозиториев и организаций, использующих настройки по умолчанию. Режим Balanced выполняет более глубокий анализ с использованием моделей с более высоким уровнем рассуждений, но потребляет значительно больше ресурсов. По оценке GitHub, типовая Lite-проверка потребляет примерно $0,05-$1 в кредитах ИИ, тогда как Balanced требует примерно $0,25-$5, при этом фактическое потребление варьируется в зависимости от размера pull-request и инструкций репозитория. Изменение создаёт реальный инженерный компромисс: для организаций, рецензирующих тысячи pull-запросов, различие в стоимости становится операционально важным. Оптимальная стратегия заключается в дифференцированном подходе — тратить вычислительные ресурсы проверки в соответствии с риском软件, что подчеркивает важность выбора уровня усилий на уровне API.
Выводы автора:
- Balanced режим использует более мощные модели и обеспечивает более глубокий анализ, но потребляет в 5-25 раз больше кредитов, чем Lite
- Для масштабных организаций имеет смысл дифференцированный подход к выбору уровня проверки в зависимости от риска изменений, а не универсальное применение самого дорогого режима
Запускать самую глубокую проверку на каждое изменение может быть неэкономично, а поверхностные проверки везде могут не обеспечить достаточную верификацию.
GitHub Review Effort: от конфигурации к системе политик
Разработка и архитектура · Tech Scoop Newsletter · 7/10
GitHub развивает систему настройки интенсивности code review, которая начинает напоминать полноценный policy engine для управления разработкой. Платформа позволяет устанавливать уровень проверки на разных уровнях: организация, репозиторий, отдельный разработчик и конкретный pull request, с чётко определённым приоритетом разрешения конфликтов. Это архитектурно близко к тому, как зрелые организации уже управляют контролями безопасности, CI-политиками, правами деплоя и governance инфраструктуры. Например, репозиторий платёжных систем может требовать углублённой проверки (Balanced), а репозиторий документации — облегчённой (Lite), или конкретный чувствительный PR может явно запросить более глубокий анализ независимо от стандартов репозитория. Такой подход позволяет platform teams устанавливать общеорганизационные стандарты, одновременно давая репозиториям с высокорисковым ПО гибкость адаптации.
Выводы автора:
- Система настройки code review в GitHub эволюционирует в полноценный policy engine с иерархией приоритетов и контекстной гибкостью.
- Policy-driven подход позволяет организациям балансировать между едиными стандартами и гибкостью для высокорисковых компонентов.
Это намного ближе к тому, как зрелые организации уже управляют контролями безопасности, CI-политиками и governance инфраструктуры.
Принцип наследования качества: почему ИИ зависит от согласованного словаря
Данные и аналитика · Modern Data 101 | Expert's Desk · 9/10
Материал анализирует, почему 95% ИИ-пилотов не дают измеримых результатов, и выявляет корневую причину: не в моделях, а в несогласованном определении категорий данных. На примере платформы i2b2 для клинических исследований автор показывает, как унифицированный словарь и общие концептуальные иерархии сокращают время получения ответов с недель до минут. Ключевой вывод — принцип наследования качества: всё, что строится на неупорядоченном словаре, наследует его недостатки. ИИ-модели усугубляют проблему, так как обрабатывают неоднозначные данные уверенно и авторитетно, не сигнализируя об ошибках. Автор вводит понятие онтологии как упорядоченного организационного словаря с разрешёнными разногласиями. Перед разработкой ИИ-системы нужно оценить пять критериев: соответствие ценности, готовность данных, объяснимость, соответствие workflow и устойчивость. Готовность данных требует трёх проверок: согласованности определений, сохранения различий между категориями и правильного уровня зернистости. Успех означает, что задачи, раньше требовавшие недель и споров, теперь решаются в минуты с единственным принятым ответом.
Выводы автора:
- Качество ИИ-систем определяется согласованностью и полнотой словаря организации, а не сложностью модели
- Платформы вроде i2b2 ускоряют работу в 1000+ раз благодаря унифицированным концептуальным иерархиям, а не благодаря интерфейсу
- Перед разработкой ИИ необходимо оценить пять критериев готовности, особенно готовность данных как свойство их соответствия конкретному решению, а не просто их чистоту
ИИ убирает трение, которое раньше обнажало неопределённость. Всякая рекомендация строится на категориях, и оспариваемые категории производят оспариваемые рекомендации.
Оригиналы:The Quality Inheritance Principle: Why AI Is Only as Good as Your Vocabulary · 95% of pilots produce no measurable impact · AI Governance Benchmark 2026 — полный отчёт
Российский рынок ЦОДов: инвестиции, вызовы и будущее
Данные и аналитика · Б.О: Технологии · 8/10
Материал посвящён российскому рынку центров обработки данных (ЦОДов) как объекту инвестирования и развития инфраструктуры. За пять лет рынок удвоился до 1,8 ГВт мощности, 75% сосредоточено в Московском регионе; лидеры по стойко-местам — РТК-ЦОД (27 тыс.), IXcellerate (10 тыс.) и структуры «Росатома» (6,5 тыс.). Объём текущих инвестпроектов достиг 54 млрд рублей, при неудовлетворённом спросе в 200–300 МВт только в Москве. Финансовый сектор, включая ВТБ, активно инвестирует в ЦОДы как актив, который не ветшает и приносит стабильный доход; срок окупаемости 7–10 лет. Ключевые вызовы: дефицит чипов и видеокарт для ИИ (ожидается, что в 2026 году ЦОДы заберут 70% мирового выпуска памяти), земельные ограничения (для объекта на 50+ МВт нужно 12–14 га), а также геополитические риски — атаки БПЛА на ЦОДы «Яндекса» и Сбера подтвердили необходимость защиты инфраструктуры. Минцифры и Минобороны разрабатывают концепцию защищённых ЦОДов, включая заглубленные варианты, но существуют опасения по затоплению объектов. Исследуются альтернативы: орбитальные ЦОДы (2030–2035 годы) с независимостью от земных сетей и плавучие дата-центры в океане, хотя оба варианта сталкиваются с техническими и экономическими ограничениями.
Выводы автора:
- Российский рынок ЦОДов быстро растёт и привлекает инвестиции финансовых институтов, но сталкивается с инфраструктурными ограничениями, дефицитом электроники и геополитическими рисками.
- Ключевые риски развития: дефицит чипов памяти и ускорителей для ИИ, необходимость защиты инфраструктуры от военных атак и существенные земельные требования рядом с мегаполисами.
- Государство рассматривает нестандартные решения — от заглубленных защищённых центров до орбитальных и плавучих ЦОДов, однако каждое из них сопряжено с техническими и регуляторными сложностями.
ЦОД, в отличие от прочей недвижимости, с годами не ветшает и потому не дешевеет, так как все стойки реновируются и замена оборудования заложена в финансовую модель.
Оригиналы:ЦОДы закопать или отправить в космос?
Почему DataOps отличается от DevOps: три фундаментальные реальности
Данные и аналитика · Substack · 7/10
DataOps – это не просто переименованный DevOps, потому что данные принципиально отличаются от кода. Автор выделяет три ключевые реальности, которые делают управление данными сложнее. Во-первых, данные непрерывно изменяются независимо от воли разработчиков – источники данных меняют форматы полей, и это ломает все нижестоящие дашборды. Во-вторых, данные неконтролируемы: они приходят из внешних систем, поставщиков, партнёров и клиентов, которыми организация не владеет. Это объясняет, почему многие AI POC-и терпят неудачу. В-третьих, данные теряют актуальность – они становятся устаревшими, неполными или меняют смысл со временем. Именно поэтому бизнес часто не доверяет данным. Правильная организация DataOps помогает разблокировать эти культурные вызовы и боль-ные точки в работе с данными.

Выводы автора:
- DataOps требует отдельного подхода к управлению, поскольку данные изменяются независимо от разработчиков и не могут быть полностью контролируемы
- Недостаток доверия к данным в организациях связан с их деградацией, неполнотой и изменением определений со временем
Данные меняются, нравится вам это или нет, код же изменяется только когда разработчик это делает
Оригиналы:DataOps как отдельная дисциплина
Как сцена взлома принтеров создала собственный DRM
Кибербезопасность · Habr · 8/10
Статья рассказывает о истории взлома защиты лазерных принтеров и параллельном развитии DRM-механизмов в сообществе российско-украинских крякеров. Производители принтеров встроили электронные счётчики (CRUM) в картриджи, чтобы блокировать использование неоригинальных расходников и сторонних заправок, что позволяло получать прибыль на картриджах. Первые защиты на базе простых EEPROM-чипов (Atmel AT24C04) легко взламывались перепрограммированием. Вторая попытка с криптографическими чипами (Atmel AT88SC0204C) использовала статические ключи, которые также были взломаны через реверс-инжиниринг. Третий уровень защиты — собственные криптографические микроконтроллеры (Samsung S3CC921) с памятью OTP, предотвращавшие повторное использование чипов. В 2009 году донецкий исследователь Андрей Лутов успешно модифицировал прошивку Samsung SCX-4300, отключив проверку чипа через доступ по UART и отладочным интерфейсам. Взломанная прошивка «MA» была выложена в открытый доступ и получила положительные отзывы сервисных мастеров. Вскоре разработчики начали коммерциализировать крякированные прошивки, внедряя защиту на базе серийных номеров принтеров, создав таким образом собственный DRM-механизм для противодействия бесконтрольному распространению.
Выводы автора:
- Производители принтеров использовали DRM-защиту в картриджах не для борьбы с пиратством, а для монополизации продажи расходников, что стимулировало разработку кракёров.
- Каждый уровень защиты (простые EEPROM, криптографические чипы, собственные микроконтроллеры) был последовательно взломан благодаря открытым отладочным интерфейсам и отсутствию цифровой подписи прошивки.
- Сообщество взломщиков развило собственную систему защиты модифицированных прошивок (привязка к серийному номеру), эффективно создав конкурирующий DRM для борьбы с бесконтрольным распространением своих кракёв.
Чтобы противостоять распространению неоригинальных картриджей и удержать прибыль, производители принтеров начали оснащать картриджи электронными чипами-счётчиками.
Оригиналы:Как сцена взлома принтеров изобрела собственный DRM · Реверс-инжиниринг
ЦОД «Сбера» в Саратовской области подвергся атаке БПЛА
Кибербезопасность · Habr · 7/10
В ночь на 14 октября 2026 года беспилотники атаковали ЦОД «Сбера» в Балаково Саратовской области. Банк подтвердил факт атаки, однако заявил, что все системы и сервисы продолжают работать в штатном режиме, и никто из сотрудников не пострадал. По данным СМИ, атакованный объект — это строящийся дата-центр, совместный проект «Сбера» и «Россетей» стоимостью 30 млрд руб., строительство которого началось в 2021 г. и должно завершиться в 2027 г. Подробности о масштабах повреждений оборудования и дальнейшей судьбе проекта не сообщаются. Ранее пользователи сообщили о сбоях в работе сервисов Mail.Ru, Ozon, «Самоката» и «Сбера», включая ИИ-сервис GigaChat, но спустя 3 часа работа была восстановлена.
Выводы автора:
- ЦОД «Сбера» в Саратовской области подвергся атаке беспилотников, но все системы продолжают работать в штатном режиме.
- Атакованный объект — строящийся дата-центр стоимостью 30 млрд руб., совместный проект «Сбера» и «Россетей», завершение которого запланировано на 2027 г.
Мы подтверждаем факт атаки на центр обработки данных. При этом все системы и все сервисы Сбербанка работают штатно.
Оригиналы:ЦОД «Сбера» в Саратовской области подвергся атаке БПЛА
Яндекс восстановился после атак на ЦОДы благодаря распределённой инфраструктуре
Кибербезопасность · Habr · 7/10
Минцифры подтвердила, что «Яндекс» оперативно перевёл ключевые системы на заранее подготовленные резервные площадки после беспрецедентной атаки на дата-центры. Территориальное распределение инфраструктуры позволило компании сохранить доступность сервисов несмотря на серьёзные повреждения. Директор по стратегическому маркетинству Андрей Себрант заявил, что инцидент оказался серьёзнее, чем сценарии потери одного ЦОДа, которые компания регулярно отрабатывала. Оставшиеся системы переносят на сторонние площадки при помощи других компаний отрасли. В качестве компенсации «Яндекс» сделал бесплатными Yandex Cloud и «Яндекс 360» с 8 по 31 октября 2026 года для всех российских клиентов. Большинство функций восстановлены: умный дом с «Алисой» работает, хотя некоторые возможности «Яндекс 360» намеренно ограничены для снижения нагрузки на инфраструктуру.
Выводы автора:
- Предварительная подготовка резервных площадок и распределённая архитектура позволили компании быстро восстановить критичные сервисы после атаки на ЦОДы.
- Масштаб инцидента оказался серьёзнее, чем тестовые сценарии, которые компания регулярно проводила.
Территориальное распределение позволяет снизить зависимость от отдельных крупных объектов и сохранить доступность сервисов даже при серьезных повреждениях.
Оригиналы:Минцифры о восстановлении Яндекса после атак на ЦОДы
Атаки дронов на ЦОДы: риски для банков и рекомендации клиентам
Финтех и финансы · Б.О: Финграмотность · 8/10
Материал разбирает угрозу атак беспилотников на дата-центры финансовых организаций и последствия для клиентов. 14 октября БПЛА атаковали ЦОД Сбербанка в Балаково, хотя системы банка продолжили работу. Ранее в октябре атаки на ЦОДы «Яндекса» в Сасово, Калуге и Владимире привели к массовым сбоям услуг, включая полный отказ финсервиса «Яндекс.Пэй». Банк России и Сбербанк получили полномочия защищать объекты средствами ПВО (с 9 октября для Сбера); ЦБ также применил понижающие коэффициенты (30–50%) для кредитов на защиту инфраструктуры до конца 2026 года. Предложено создать резервные системы наличного денежного обращения в регионах. Для потребителей рекомендуется держать наличные резерв на 3–7 дней (1–2 тыс. рублей ежедневно), печатать выписки счетов, распределять сбережения между несколькими банками и иметь физические карты, а не только цифровые. Самозанятым и бизнесу советуют локально хранить копии документов и вести журналы инцидентов для налоговой отчётности.
Выводы автора:
- Атаки на ЦОДы создают операционные риски для банков и их клиентов, но регуляторы и финучреждения развивают системы защиты и резервирования.
- Потребителям необходимо самостоятельно обеспечивать финансовую устойчивость при форс-мажорных ситуациях через наличные резервы, распределение средств между банками и сохранение офлайн-доступа к информации о счётах.
Наличные деньги пока остаются единственным средством платежа, которому не страшны перебои с электричеством и отключения интернета.
Оригиналы:Атаки беспилотников на ЦОДы банков и операционные риски для клиентов
Нобелевская премия по экономике 2026: микрооснования макроэкономической политики
Экономика · РЭШ · 8/10
Нобелевская премия по экономике 2026 присуждена Роберту Холлу и Майклу Вудфорду за разработку микроэкономических оснований макроэкономической стабилизации. Холл и Вудфорд – учёные, малоизвестные широкой публике, но чьи работы лежат в основе инструментария, используемого центральными банками и министерствами финансов для разработки и оценки макроэкономической политики. Холл применил подход оптимизирующего поведения агентов к теории потребления, создав модель потребления как случайного блуждания, которая показывает, что потребление зависит только от неожиданных изменений дохода и учитывает различие между временными и постоянными доходами. Вудфорд построил целостную теорию денежно-кредитной политики, выведя из оптимизационного поведения домохозяйств и фирм механизмы действия центрального банка через установление процентных ставок. Оба подхода заменили статистические связи в кейнсианских моделях на «глубокие» микроэкономические параметры, не зависящие от проводимой политики, что позволило избежать критики Лукаса о непригодности моделей при изменении режима.
Выводы автора:
- Микрооснования макроэкономики позволяют строить модели, остающиеся корректными при смене политического режима, и оценивать политику не только по её влиянию на инфляцию и выпуск, но и на общественное благосостояние
- Модель потребления Холла показывает, что эффективность бюджетного стимула зависит от доли домохозяйств с высокой склонностью к потреблению и точности адресации помощи, а не от размера разовых выплат
- Теория Вудфорда позволяет вывести функцию потерь центрального банка непосредственно из полезности домохозяйств и показывает, что инфляция вредна прежде всего потому, что искажает относительные цены и приводит к неэффективному распределению ресурсов
Условие оптимальности поведения домашних хозяйств – уравнение Эйлера, параметры которого (терпеливость и готовность переносить потребление во времени) от макроэкономической политики не зависят.
Оригиналы:Нобелевская премия 2026: микрооснования макроэкономической стабилизации
Как английские термины стали ключом к японскому экономическому чуду
Экономика · РЭШ · 8/10
Статья профессора Константина Егорова объясняет, почему Япония смогла за 13 лет превратиться из аграрной страны в индустриальную и разгромить Россию в войне 1905 года. Оказалось, что критическим недостающим звеном была не политика или институты, а банальная проблема языка: в Японии катастрофически не хватало технических терминов и переводов западной литературы. До 1883 года технические руководства были доступны только на английском, французском, немецком и итальянском языках. С 1870 по 1885 год японское правительство целенаправленно привлекало переводчиков для создания словарей и перевода технической литературы — эта работа стала одной из главных задач так называемого Института изучения варварских книг. Результат был поразительным: если к 1860 году на японский язык было переведено всего 8 книг западной технической литературы, то к 1900 году уже 608. Исследователи обнаружили, что после накопления достаточного запаса переведённой литературы в Японии резко выросли именно те промышленные секторы (текстиль, машиностроение, обувь), которые были наиболее полно задокументированы в англоязычных руководствах. Появление единого, централизованного набора технических терминов на родном языке позволило инженерам и рабочим быстро освоить новые технологии. Удивительно, что простого присутствия иностранных специалистов оказалось недостаточно — знания на родном языке сыграли решающую роль.

Выводы автора:
- Государственная политика целенаправленного перевода и стандартизации технических терминов на японском языке стала ключевым фактором промышленного рывка, даже более важным, чем реформы конституции или введение парламента.
- Быстрый рост специфических отраслей в Японии коррелировал с объёмом переведённой на японский англоязычной технической литературы, при этом в других развивающихся странах без массовых переводов такой корреляции не наблюдалась.
- Знание технологических основ иностранными специалистами не компенсировало отсутствие доступа к переведённой литературе на родном языке — массовое понимание новых методов производства требовало распространения знаний через литературу на национальном языке.
Чем меньше существует объектов, которые надо описывать, тем меньше соответствующих слов. Но чем меньше слов, тем сложнее начать производить такие объекты самим.
Оригиналы:Оригинальная статья на РЭШ
Теория принятия решений: почему нерешительность рациональна
Экономика · РЭШ · 7/10
Интервью с профессором РЭШ Озгуром Эвреном о теории принятия решений и её отличиях от поведенческой экономики. Материал разбирает, как нерешительность может быть рациональным поведением: человек, который говорит «я не знаю, что выбрать», проявляет мудрость, собирая информацию перед выбором. Ослабление аксиомы полноты (предположения, что человек может сравнить любые два варианта) позволяет строить более точные прогнозы поведения. Персонаж Гамлета, вопреки стереотипу, вёл себя экономически рационально, тщательно собирая информацию перед решением о мести. Эврен объясняет, что рациональный выбор часто требует затрат умственной энергии, поэтому люди «рационально игнорируют» часть информации. Нерешительность особенно важна при решениях с высокими ставками — например, выборе инвестиционной стратегии или определении наказания за преступление. В заключение учёный отмечает, что теория принятия решений становится более ориентирована на эмпирические данные и больших объёмы данных, а цикл публикаций в научных журналах сократился до 2-3 месяцев.

Выводы автора:
- Нерешительность в выборе может быть рациональной моделью поведения, особенно когда человек собирает информацию перед важным решением
- Ослабление требования полноты предпочтений позволяет точнее прогнозировать выбор людей, так как они избегают противоречий в разных ситуациях
- Затраты умственной энергии делают рациональным для людей быстро принимать решения и игнорировать часть информации, но это может привести к ошибкам в высокостаковых сценариях
Нет ничего иррационального во фразе: «Я не знаю, что выбрать». Мудро ли сказать, что ты не знаешь, что выбрать? Я думаю, да.
Оригиналы:Уроки Гамлета: как нерешительность помогает сделать оптимальный выбор
Совет по поиску работы в ИИ обновляется каждые шесть месяцев
Продукт и карьера · Nikhyl Singhal (The Skip) · 8/10
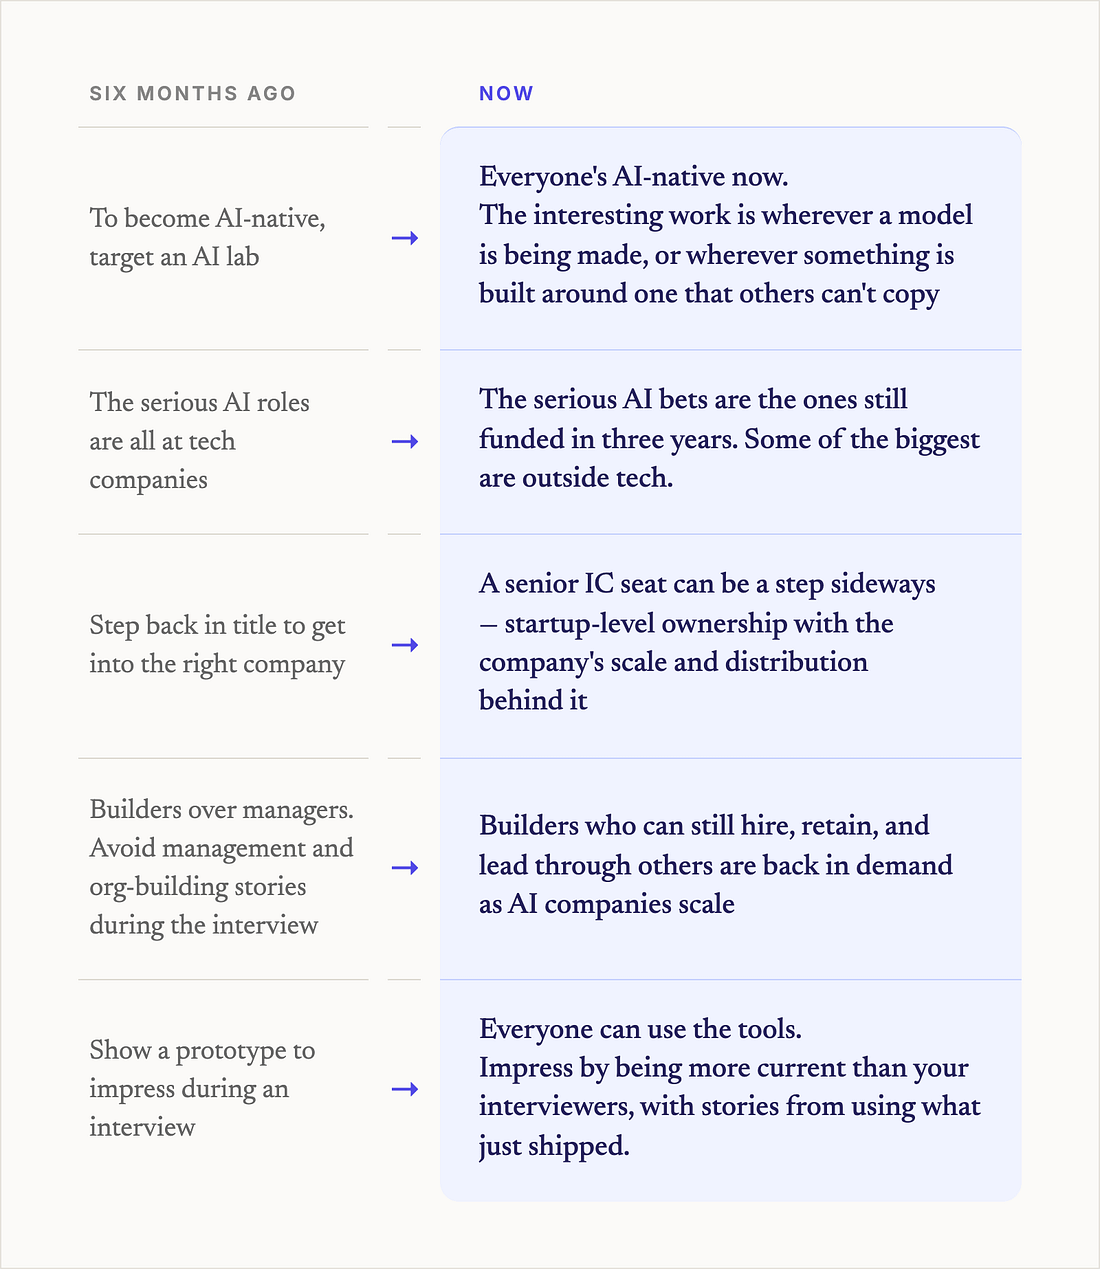
Материал о том, как изменился рынок труда для специалистов по ИИ за первые полгода 2024 года на основе интервью с тремя руководителями, устроившимися в Runway, Eli Lilly и Google Search. Старый совет — работать в лабораториях (OpenAI, Anthropic) и избегать крупных корпораций — устарел. Anthony Maggio выбрал Runway (200 сотрудников), где работа идёт в обратном направлении: исследователи делают прорыв, а PM должны найти применение новой возможности. Gadi Ben-Zvi пошёл в фармацевтику Eli Lilly, потому что там 150 лет данных для моделей поиска кандидатов на лекарства, долгосрочные инвестиции и отсутствие опыта в product management, что позволило ему добавить немедленную ценность. Chandra Raghavan обнаружил, что стартап-или-большая-компания — это ложная дихотомия: AI-проекты в крупных техкомпаниях теперь движутся со скоростью стартапов. Ключевые сдвиги: лидеры должны быть одновременно строителями и менеджерами, актуальность и постоянная практика с новыми моделями важнее диплома, и побочный проект остаёт критичным для руководителя в корпоративной роли, где быстрые эксперименты затруднены.
Выводы автора:
- Работа на передовом фронтире ИИ теперь доступна за пределами специализированных лабораторий — в стартапах правильного размера и даже в традиционных корпорациях с хорошей стратегией и данными
- Ключ к привлекательной возможности — долгосрочная ставка на ИИ: компания должна быть готова вкладывать годы в развитие, а не гоняться за заголовками
- Актуальность знаний и практический опыт с новыми моделями теперь важнее формального образования, и руководителям нужны собственные side-проекты, чтобы оставаться в курсе и практиковаться, когда основная роль этого не позволяет
Способность нанимать, удерживать лучших специалистов по-прежнему очень важна, но в сочетании со строительством и поиском product-market fit — больше не хватает только управления через слои и кросс-функциональной координации
Feature Factory десять лет спустя: размышления о балансе результатов и выпуска
Продукт и карьера · John Cutler from The Beautiful Mess · 8/10
Джон Катлер переосмысляет свой знаменитый пост о Feature Factory спустя десять лет – материал, который изменил его карьеру и стал вирусным на Hacker News. Он признаёт, что его исходные бинарные схемы (результаты vs. выпуск, проекты vs. продукты) упрощали реальность и нередко приводили к перегулу компаний, избыточному найму PM и потере фокуса на первопринципы. В современном контексте Катлер предлагает более гибкий подход: думать в терминах многоквартальных ставок с реальным бизнес-кейсом вместо представления, что каждая команда будет существовать вечно. Он показывает, что Feature Factory – это спектр, а не бинарное состояние: даже при ориентации на результаты команды часто вынуждены опираться на условные показатели из-за низкого доверия, зависимостей и необходимости координации. Важнейший вывод касается человеческого фактора: люди ищут смысл в работе, уважение к своему мастерству и честность в коммуникации, а не просто подсчёт выполненных фич. Катлер также критикует «театр ориентированности на результаты» – когда компании выполняют все ритуалы (OKR, фреймворки, исследования), но доставляют неудобный продукт, заменяя одну форму театра на другую. Наконец, он отмечает, что в ряде случаев (особенно в AI-эпоху, при переосмыслении давно решённых задач) буквальный список фич может быть правильным ответом, как показал опыт AppFolio, который смешивал feature-factory подход с смелыми ставками на сегментацию.
Выводы автора:
- Feature Factory – это спектр, а не состояние 0/1; даже high-performing команды балансируют между выпуском фич, проектной дисциплиной и поиском результатов в зависимости от контекста, доверия и зависимостей.
- Человеческая мотивация – о чувстве влияния, эпистемической честности и уважении к мастерству – важнее, чем формальная философия ориентированности на выпуск или результаты.
- Современный риск – это «театр результатов»: когда команды механически выполняют фреймворки (OKR, исследования, AI-сгенерированные обоснования), но не делают настоящей работы по формированию и доставке пригодного продукта.
Это не становится проще; ты просто начинаешь фокусироваться на более высоком уровне абстракции.
Оригиналы:Пост на Medium о Feature Factories · The Beautiful Mess – рассылка Джона Катлера
Конец привычного айти: куда идти разработчикам в эру ИИ
Продукт и карьера · Habr · 7/10
Статья – личный опыт программиста, который осознал, что его основной навык обесценивается из-за развития ИИ и языковых моделей. Автор прошёл классический путь: галера, стажировка в Mail.ru, позиция мидла в Сбере в 2018 году с 30%-ным ежегодным ростом дохода. Но к 2026 году картина изменилась: сначала уволили техписов (ИИ генерирует тексты в промышленных масштабах), потом дизайнеров, QA, даже аджайл-коучей. На плаву остаются те, кто внедряет ИИ или доводит идеи до реализации; узкие направления вроде фронтенда – на низком старте. Автор, имея 10 лет опыта программирования, осознал: профессия превращается в мясной прокси (просто клик-клик на кнопку согласия нейросети). Он выделяет три пути для бывших разработчиков: остаться инженером (путь для гениев, которых автор не считает собой), стать предпринимателем (сложно, но живо долго) или стать блогером/инфлюенсером (долгоживущая ставка, ведь люди всегда будут следить за реальными людьми, а не ИИ-аватарами). Вывод: нужно делать ставки на будущее, хоть это и мучительно.
Выводы автора:
- Навык чистого программирования уже практически обесценился из-за промышленного развёртывания ИИ, и будущее принадлежит либо гениям-инженерам, либо тем, кто умеет создавать ценность и управлять продуктом.
- Для бывших корпоративных разработчиков есть три реальных направления: углубление в технологии (для избранных), запуск своего дела или построение личного бренда через контент.
- Человеческое внимание останется самым дефицитным и ценным ресурсом: люди всегда будут предпочитать реальных авторов AI-генерируемому контенту.
Мне всего лишь 32. На пенсию мне рано. Я готов менять себя и свою жизнь. Но куда идти, что делать?
Как работает счётная линейка: математика логарифмов в железе
Прочее · Habr · 7/10
Статья рассказывает об устройстве и принципах работы логарифмической линейки — аналогового счётного прибора, который использовался для инженерных расчётов более 300 лет до эры электронных калькуляторов. Автор объясняет, что логарифм — это операция, обратная возведению в степень, а его главное свойство заключается в том, что он заменяет умножение сложением.
На логарифмической шкале числа расположены не в арифметической прогрессии (1, 2, 3...), а в геометрической (0,01, 0,1, 1, 10, 100...), что позволяет сдвигать две линейки относительно друг друга и получать результаты умножения и деления по совпадающим рискам.
Точность стандартной линейки длиной 25 см составляет три-четыре знака из-за физических ограничений человеческого глаза и технологии производства. Автор описывает собственную коллекцию линеек советского и зарубежного производства, отмечая различия в качестве изготовления и материалах. Важный момент: линейка слепа к порядкам чисел (позициям запятой), поэтому оператор должен сам определить правильный порядок результата.
Выводы автора:
- Логарифмическая линейка работает благодаря свойству логарифмов заменять умножение сложением, что позволяет физически перемещать шкалы для вычисления результатов.
- Стандартная линейка обеспечивает точность в 3-4 знака, но требует от оператора умения оценивать промежуточные значения и правильно определять порядок результата.
- Логарифмические шкалы строятся на принципе геометрической прогрессии, где совпадающие риски на сдвинутых шкалах всегда дают одно и то же соотношение между числами.
Все значения на смежных шкалах линейки дают одно и то же соотношение — в этом и волшебство!
Оригиналы:Делим и умножаем на счётной линейке
Коротко
Разработка и архитектура
- Администрирование Minecraft-сервера: аудит мира и подготовка к обновлениям – Статья описывает практический опыт администратора сервера Selectel в Minecraft, столкнувшегося с необходимостью подготовки игрового мира к обновлениям версий 26.2 и 26.3, которые д
Кибербезопасность
- Массовый сбой сервисов Mail.Ru, Ozon, Сбера и GigaChat – 14 октября 2026 года произошёл инцидент, повлиявший на множество популярных российских сервисов.
Прочее
- Спецэффекты кино до компьютерной графики: Dykstraflex и оптические маски – Статья рассказывает о технологиях создания спецэффектов в кино эпохи до цифровой графики, особенно на примере «Звездных войн» и других фильмов.