Дайджест за 14 октября 2026
OpenAI научила ИИ решать сложные математические задачи, а Yandex Cloud едва пережил массированную кибератаку, парализовав несколько дата-центров. На фоне технологических потрясений выяснилось, что российским IT-специалистам платят по-прежнему без тайн — анализ 155 тысяч вакансий раскрыл все карты. А ещё выясняется, что даже десктопный ИИ отстаёт в банальной автокоррекции, потому что фундамент здесь совсем другой.
Главное
- OpenAI решила 370+ математических задач, Anthropic запретила травить Claude, Meta шпионит через Muse
- Анализ 155 000 IT-вакансий России: что влияет на зарплату и как читать между строк
- Архитектура платформы для self-hosted LLM на 1 триллион параметров в Битрикс24
- Исключения в C++ бесплатны до первого throw: реальная стоимость и оптимизация
- Yandex Cloud в аварийном режиме после атак на три дата-центра
Подробно
OpenAI решила 370+ математических задач, Anthropic запретила травить Claude, Meta шпионит через Muse
ИИ и агенты · Habr · 9/10
Дайджест недельных новостей о прорывах ИИ в математике, изменениях в регулировании и финансах IT-компаний. OpenAI выложила 700+ рукописей с решениями нерешённых математических проблем, которые нейронка обработала за три часа каждую — результаты настолько поразили математическое сообщество, что известный математик Теренс Тао призывает переосмыслить ценность решений не по количеству «ачивок», а по объёму нового понимания, которое они приносят. OpenAI отозвала три рукописи из-за ошибок и исправила ещё 14, но только 42% решений формализированы на языке Lean для автоматической проверки. Anthropic пошла другим путём — отдала результаты двум математикам для упрощения и проверки перед публикацией. На фоне математического хаоса ИИ-компании готовят сценарии первой крупной катастрофы по вине ИИ, ожидая кибератаку на банки или инфраструктуру в течение 6–12 месяцев. Anthropic официально запретила пользователям систематически травить Claude, позволяя модели заканчивать токсичные разговоры. Meta запустила Muse, который ежечасно обновляет профили пользователей и упоминаемых людей, включая тех, кто сервисом не пользуется. В финансах SpaceX ищет $40 млрд на датацентры под будто чиркалку-презентацию, Microsoft и Meta сокращают использование Claude в пользу собственных моделей, а Anthropic позиционирует Haiku 5.5 как существенно более экономный вариант.
Выводы автора:
- ИИ способен решать известные математические проблемы быстро, но математическое сообщество переживает парадигмальный сдвиг в определении ценности решений и роли человека в науке
- ИИ-компании активно готовятся к первому крупному инциденту с потенциальным ущербом на сотни миллиардов долларов и пытаются повлиять на регулирование
- Разные подходы к решению задач (сырые результаты OpenAI vs проверенные статьи Anthropic) отражают спор о том, как должна развиваться взаимодействие людей и ИИ в науке
Математика на этом не закончилась — нам всем просто теперь предстоит понять, какие новые правила игры, и какая там роль людей
Оригиналы:AI за день изменил всю математику, а также чумной вопрос в России: главное за неделю
Архитектура платформы для self-hosted LLM на 1 триллион параметров в Битрикс24
ИИ и агенты · Habr · 9/10
Сергей Нотевский, AI Platform Lead в Битрикс24, разбирает архитектурные решения при развёртывании собственной LLM вместо использования внешних API. Компания пришла к self-hosted решению из соображений безопасности данных, гибкости в выборе моделей и экономики на стабильной нагрузке. Исходная схема «продукт → endpoint → модель» расширилась многократно по мере роста требований. Основная задача — справедливое распределение общих вычислительных ресурсов между разными сценариями. Чат требует минимальной задержки первого токена (TTFT), длинные документы съедают память KV-cache, агентские цепочки непредсказуемы по времени. Вместо добавления реплик компания разделила нагрузку на пулы по профилям: быстрый интерактив, длинный контекст, многошаговые задачи.
Перед пулами установлены: Gateway (доступы, квоты, учёт по командам и сценариям), семантический роутер (выбор способа решения до исполнения), планировщик (решение, когда выполнять, откладывать или ставить в очередь). Отложенные задачи используют мощности в спокойные периоды, но их объём ограничивают, чтобы не мешать интерактивным запросам. Добавлен кэш-роутер, который учитывает переиспользование префиксов в KV-cache между репликами одной модели.
Выводы автора:
- Self-hosted LLM требует не просто развертывания модели, но построения целой платформы: шлюза доступов и квот, планировщика, семантического роутера и системы пулов для справедливого распределения ресурсов
- Разделение нагрузки на пулы по профилям (интерактив, длинный контекст, агенты) позволяет оптимизировать под разные требования: для чата нужен резерв для TTFT, для документов — память, для агентов — гибкость по времени
- Экономия на вычислениях не сводится к цене токена; важны учёт КВ-кэша, маршрутизация запросов через реплики, отложенные задачи и метрики в хвосте распределения задержек, а не только средняя утилизация
При переходе на self-hosted эти задачи (распределение запросов, очереди, кэширование, обработка пиков) становятся нашими и тоже входят в себестоимость. Сам по себе переезд ещё не означает, что токен стал дешевле.
Оригиналы:«Давайте просто развернём свою LLM на 1Т параметров»: что пришлось построить вокруг неё в Битрикс24
Почему десктоп отстаёт от телефона в автокоррекции и где роль LLM
ИИ и агенты · Habr · 8/10
Статья разбирает, почему на компьютере до сих пор нет нормальной автокоррекции вроде той, что есть на смартфонах, несмотря на развитие LLM. Автор показывает на примере Hunspell, что традиционные словарные проверки неэффективны: они ругаются на профессиональный жаргон (задеплоил, смержил) и пропускают реальные опечатки из-за отсутствия контекста. Проблема кроется в архитектуре: на телефонах клавиатура — отдельная система, видящая весь ввод и исправляющая слова на лету; на десктопе проверка зависит от каждого приложения, а орфографический движок — просто таблица раскладки. macOS перевела автокоррекцию на трансформерные модели, но только для английского, французского и испанского. Windows 10 добавил подсказки, но они настолько неудобны (требуют навигации стрелками), что никто их не использует. Linux вообще не имеет системного решения. Дополнительно осложняет жизнь смешивание кириллицы и латиницы: переключатели вроде Punto Switcher работают в пределах одного слова и не понимают контекст фразы. В 2026 году появились решения на основе LLM: LanguageTool и Grammarly (облачные), Apple Intelligence (на устройстве, но без русского), Google Gemini Nano (требует 22 ГБ места), и инди-решение Cotypist (использует локальные Gemma/Qwen, работает в Obsidian). Фундаментальная проблема — десктопный подход к проверке орфографии сложился 30 лет назад и практически не менялся, тогда как телефоны с самого начала шли по пути интеллектуального исправления на лету.
Выводы автора:
- Архитектура десктопных систем ввода препятствует нормальной автокоррекции: проверка орфографии встроена в каждое приложение, а не реализована на уровне системы как на телефонах.
- Традиционные словарные проверки неработают для контекстных ошибок и профессионального жаргона; нужны LLM, понимающие соседние слова и фразу целиком.
- Несмотря на наличие LLM в 2026 году, большинство решений либо облачные (требуют отправки текста на серверы), либо недоступны на русском, либо требуют непрактичных ресурсов.
Если нейросеть считается прокачанным T9, то где прокачанный T9 у меня на компьютере?
Оригиналы:Почему на десктопе до сих пор нет нормального T9 и при чем тут LLM
Как математика теплопроводности 19 века помогает LLM понимать порядок слов
ИИ и агенты · ByteByteGo · 8/10
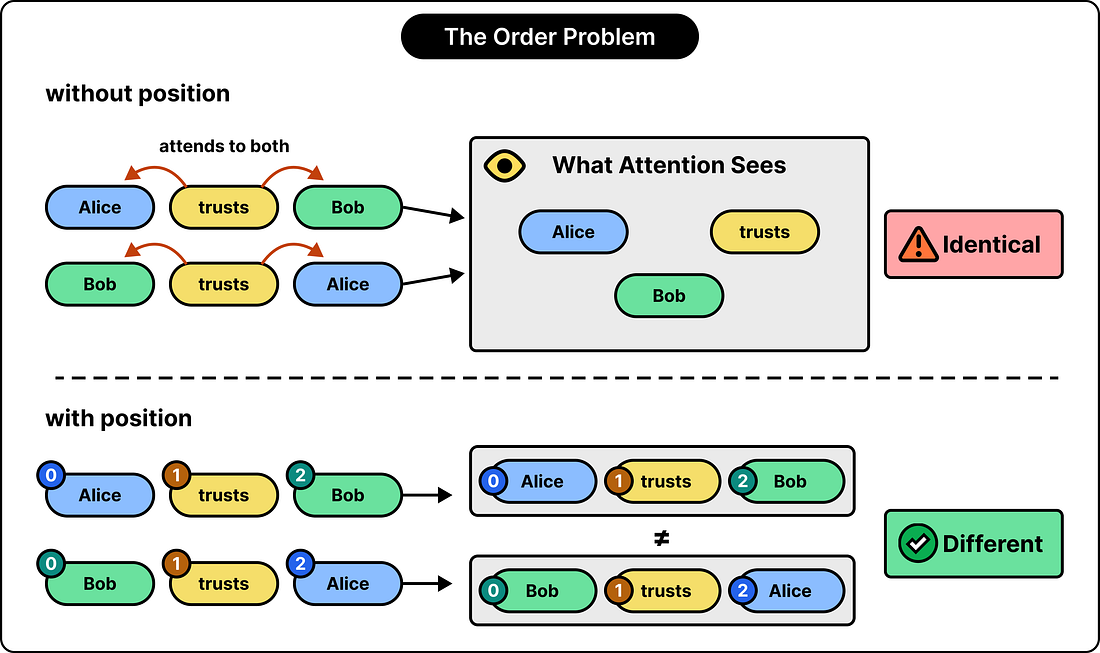
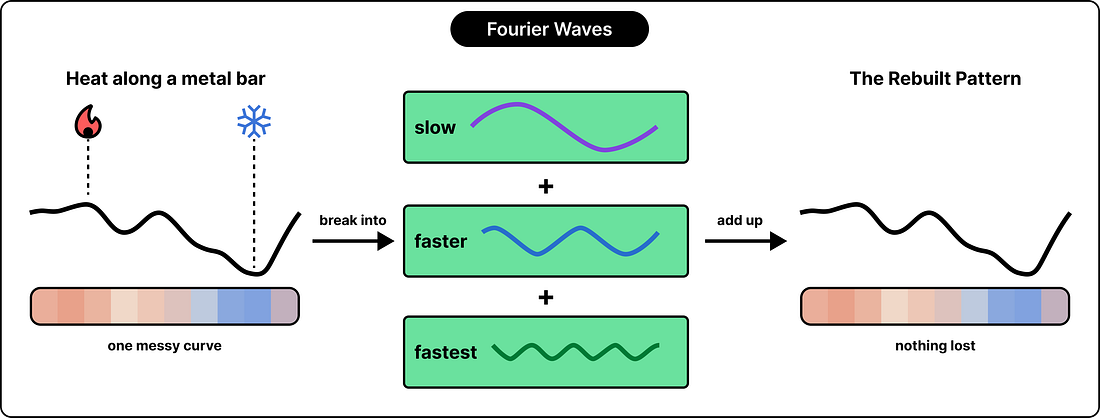
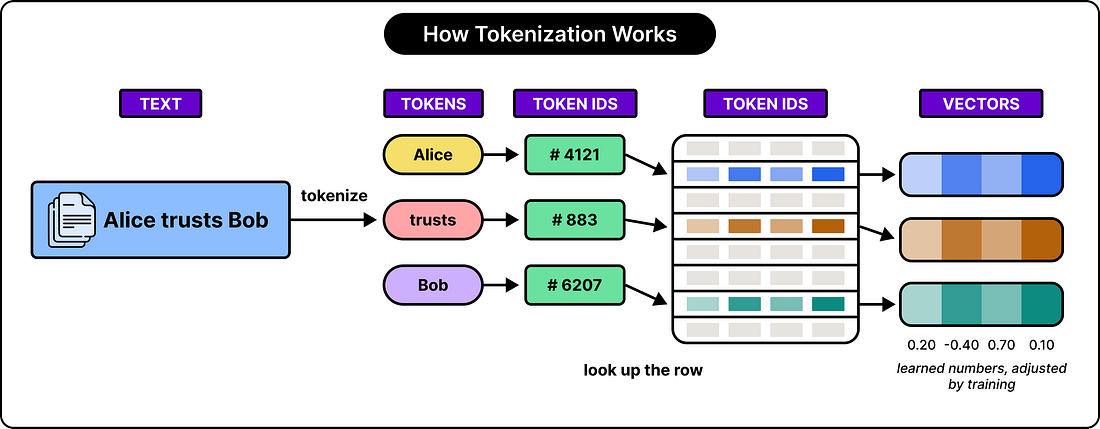
Статья объясняет неочевидную связь между работой Жозефа Фурье об распространении тепла (1822) и архитектурой трансформеров в современных языковых моделях. Обе области используют синусы и косинусы для преобразования сложных паттернов в структурированные числовые представления. В LLM позиционное кодирование (positional encoding) решает критическую проблему: базовый механизм внимания (attention) не различает порядок токенов, поэтому модель не может отличить "Alice trusts Bob" от "Bob trusts Alice" только по идентификаторам слов. Решение — добавить к эмбеддингу каждого токена позиционный код, состоящий из синусов и косинусов разных частот. Это создаёт несколько "вращающихся рук" с разными скоростями вращения: быстрые компоненты меняются на коротких расстояниях, медленные — на длинных.
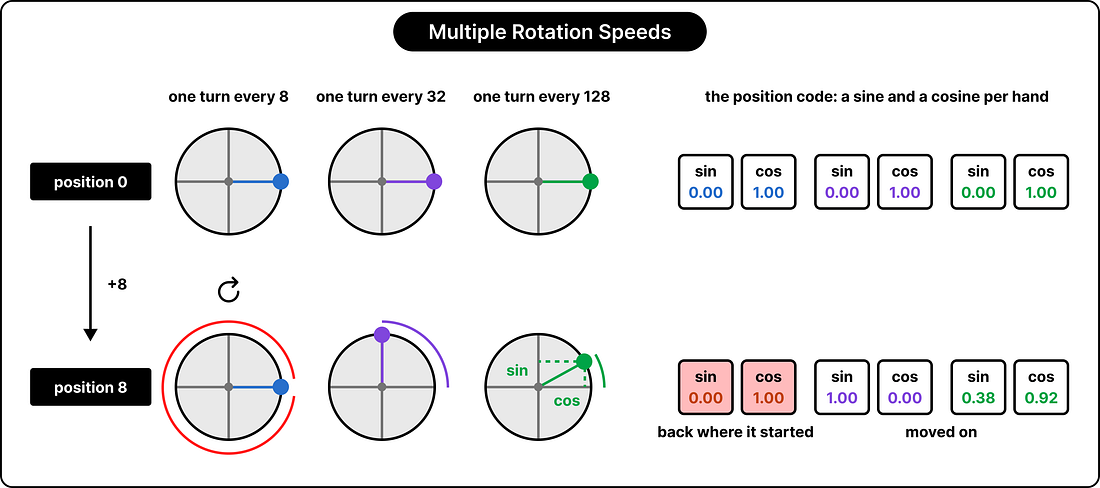
Каждая позиция в последовательности получает уникальный набор значений, объединённых в один вектор. Исходный трансформер добавляет этот позиционный вектор к токен-эмбеддингу: InputRepresentation = TokenEmbedding + PositionEmbedding. Значения позиционного кодирования остаются ограниченными (как синус и косинус), что избегает проблемы подавления исходного значения токена, если просто добавить большое число.
Выводы автора:
- Позиционное кодирование — необходимый механизм, поскольку базовое внимание не учитывает порядок токенов автоматически
- Использование синусов и косинусов с разными частотами обеспечивает структурированное представление позиций, работающее на разных масштабах расстояний
- История математики показывает, что эффективные методы могут переноситься между совершенно разными областями (физика теплопроводности и NLP)
Добавление векторов смешивает их компоненты так, что нет гарантии сохранить два отдельно восстанавливаемых записи, но модель адаптирует эмбеддинги и вычисления для использования этого объединённого сигнала.
Оригиналы:How the Math Used in 19th-Century Heat Physics Helps LLMs Understand Sentences · Attention Is All You Need · RoFormer: Enhanced Transformer with Rotary Position Embedding
Как нанять и управлять Grok Bot: практическое руководство
ИИ и агенты · Linas from Linas's Newsletter · 7/10
Материал разбирает, как правильно работать с Grok Bot – агентом ИИ от xAI, который работает на облачном сервере, интегрируется с вашими инструментами и выполняет задачи по расписанию. Главная идея: нанимать бота как человека – начать с одной простой задачи, дать ему испытательный срок и постепенно расширять полномочия, вместо того чтобы подключить все приложения в первый день. По данным Bloomberg, более 418 000 человек использовали Grok Bot еженедельно к середине сентября. Автор отмечает, что управление ботом стало сложнее за последние недели из-за двух изменений модели и переходом на Anthropic Claude Opus 5.5. Материал предлагает инструменты для контроля: шаблон карточки роли, карту правил (инструкции vs. контроли), трёхуровневый испытательный срок, систему оценки в пять показателей, пятиуровневую лестницу повышения полномочий и готовые промпты для разных ролей (основатель, инвестор, оператор). Отдельно рассматриваются проблемы интеграции с email, Slack, банковскими данными и таймауты одобрения.
Выводы автора:
- Бота нужно вводить в работу постепенно: сначала одна задача, потом испытательный срок, затем расширение полномочий по мере его надёжности
- Необходимо различать между инструкциями (которые бот может игнорировать) и контролями (которые работают всегда), особенно когда модель меняется без уведомления
- Требуется система управления ботом с регулярными тестами, оценкой производительности и механизмом понижения полномочий при ошибках
Наилучший способ нанять Grok Bot – это нанять человека: дайте ему одну письменную работу, поставьте на испытательный срок и передавайте больше полномочий только после того, как он их заслужит.
Оригиналы:How to Hire a Grok Bot: Your First AI Employee · Ultimate Guide to Grok Bot · Claude Opus 5.5
Исключения в C++ бесплатны до первого throw: реальная стоимость и оптимизация
Разработка и архитектура · Habr · 9/10
Статья разбирает, что означает фраза «zero-cost exceptions» в C++ и развенчивает миф о том, что исключения всегда бесплатны. На самом деле zero-cost гарантирует бесплатный проход через try-блок без лишних инструкций и переходов, но сам throw имеет высокую цену. Базовая стоимость броска — около 1,3 микросекунды, каждый дополнительный кадр стека добавляет примерно 200 наносекунд; при глубине 128 кадров один throw занимает 26 микросекунд, что сопоставимо с 26 тысячами обычных вызовов функций.
Раскрутчик работает через таблицы (.eh_frame и .gcc_except_table), дважды проходя по стеку: сначала разведка, затем полный проход с вызовом деструкторов. В многопоточных сервисах раньше возникали проблемы масштабирования из-за глобальных мьютексов, но с февраля 2022 года (glibc 2.35, GCC 13, LLVM август 2022) эта проблема решена благодаря замене блокирующих структур на lock-free варианты — измерения 2024 года показывают линейное масштабирование. Однако при использовании dlopen/dlclose рядом с интенсивным бросанием исключений скорость деградирует в 2-3 раза. Статья также разбирает подводные камни: аварийный пул 72 КиБ, выделяемый в начале программы; неэффективность флага -fno-exceptions (не решает проблему полностью); потерю strong exception guarantee в std::vector при расширении, если move-операция может бросить.
Выводы автора:
- Исключения платят цену при броске (от микросекунды до десятков микросекунд в зависимости от глубины стека), поэтому их нельзя использовать для обработки частых ошибок валидации — лучше std::expected с постоянной стоимостью
- Проблема масштабирования исключений в многопоточных приложениях была решена в современных версиях glibc/GCC/LLVM, но требует проверки версий и осторожности с dlopen/dlclose
- Выключение исключений флагом -fno-exceptions не решает проблему полностью и может привести к unexpected abort вместо обработки ошибок, поэтому это решение только для целого проекта без зависимостей
Zero-cost — это про путь, по которому исключение не летит: за try вы не платите вообще ничем, всё цена переехала на момент броска.
Почему генетические алгоритмы не заменили инженера
Разработка и архитектура · Habr · 8/10
Статья объясняет, почему генетические алгоритмы, несмотря на их способность создавать оптимальные и нестандартные решения (как антенна SpaceX ST5 или экзотический микрочип Адриана Томпсона), остаются нишевым инструментом и не вытеснили людей-инженеров из проектирования сложных систем. Автор разбирает три фундаментальных ограничения эволюционного поиска: во-первых, эволюция не может принять промежуточные неудачи, застревая на локальных максимумах без возможности спуститься в ущелье для лучшей оптимизации; во-вторых, она не способна совершить согласованные многоэлементные изменения сразу (так называемые breaking changes), требующие одновременной переработки множества компонентов. Третье ограничение — невозможность останавливать систему для переосмысления: природа не может позволить себе рефакторинг, как человек, что приводит к накоплению технического долга (гортанный нерв жирафа, универсальный генетический код). Человек же может спроектировать сложные системы целиком, включая синтетическую бактерию E. coli с переписанным кодом (18 214 изменений), которая получила биоблокаду от вирусов. Автор приводит метафору Пегаса — шестиногого существа физически возможного, но невозможного для эволюции, так как требует одновременного переустройства скелета, мышц и нервной системы. Статья подчёркивает: генетические алгоритмы в цифровых системах избегают физических ограничений, но встречают новые преграды, включая закон Гудхарта (когда метрика становится целью, она перестаёт быть хорошей).
Выводы автора:
- Эволюция застревает на локальных максимумах приспособленности и не может предпринять временное ухудшение системы для достижения лучшего глобального оптимума, в отличие от целенаправленного проектирования человеком.
- Генетические алгоритмы не могут осуществить согласованные изменения множества компонентов одновременно (breaking changes), требующие переписания больших частей или всей системы, так как вероятность получить тысячи нужных мутаций за одно поколение равна нулю.
- Природа не имеет возможности останавливать процесс для рефакторинга, что приводит к накоплению технического долга и невозможности менять фундаментальные архитектурные решения, тогда как человеческие инженеры могут проектировать системы с нуля и вносить кардинальные изменения.
У дикой природы есть один фундаментальный недостаток — у неё нет черновиков и лабораторий, всё должно работать здесь и сейчас.
Оригиналы:Почему генетические алгоритмы не заменили инженера
Собственный переключатель раскладки на Delphi: архитектура и алгоритмы
Разработка и архитектура · Habr · 8/10
Статья описывает разработку собственного переключателя раскладки клавиатуры на Delphi с нуля, мотивированной недостатками существующих решений (Punto Switcher, Caramba, EveryLang, Mahou). Автор обосновывает, почему коммерческие утилиты неудовлетворительны (подписки, закрытый код, телеметрия), а open-source проекты избыточны или требуют постоянной дрессировки. За три года разработки протестированы различные подходы: словарный поиск (слишком медленный), чистый анализ n-грамм (много ложных срабатываний на коротких словах и коде), машинное обучение (непредсказуемо и медленно для системного хука), опросы активного окна через GetKeyboardLayout (ненадёжно). Итоговое решение — гибридная модель с жёстким линейным конвейером отсева технических токенов, скользящим окном n-грамм, анализом структуры гласных/согласных и контекстом последних слов. Архитектура разделена на четыре автономных слоя: перехват клавиатуры и мыши (WH_KEYBOARD_LL, WH_MOUSE_LL), интеллектуальное ядро с шестиступенчатым конвейером анализа, потокобезопасная очередь исполнения с фоновым рабочим потоком, интерфейс с индикатором раскладки и звуковой обратной связью. Ключевой инженерный трюк — буфер перехвата (FReplay) в очереди, который накапливает нажатия пользователя во время подготовки SendInput, исключая рассинхронизацию при скоростной печати и стирание свежего текста вместо ошибки.
Выводы автора:
- Разделение на быстрый главный поток (хук) и медленный рабочий поток через потокобезопасную очередь критично для отзывчивости системного перехватчика клавиатуры.
- Гибридный подход (жёсткие фильтры плюс вероятностный скоринг n-грамм) работает лучше, чем чистый словарный поиск, чистый частотный анализ или нейросети в контексте системной утилиты.
- Собственное решение стоит дороже существующих только наличием полного контроля над кодом и возможностью бесконечной доработки под личные привычки, что при длительном использовании окупается.
Для меня этим решением стал проверенный инженерный принцип: сделать ровно тот набор возможностей, который нужен тебе самому в ежедневной работе, и иметь на руках прозрачный код, который можно в любой момент расширить, подправить или доработать под св
Оригиналы:Свой переключатель раскладки на Delphi, от низкоуровневого хука до скоринга n-грамм
Устойчивость ПО на базе ИИ: планирование восстановления при сбоях
Разработка и архитектура · The Pragmatic Engineer · 8/10
Материал содержит выдержки из книги Sam Newman «Building Resilient Distributed Systems» о проектировании надёжных систем в эпоху ИИ-агентов. Автор подчёркивает, что растущее число сбоев в production связано с большим объёмом кода, генерируемого ИИ-агентами, и соответствующим ростом багов. Книга, на написание которой ушло три года вместо двух, переработана с учётом влияния ИИ на архитектуру отказоустойчивых систем.
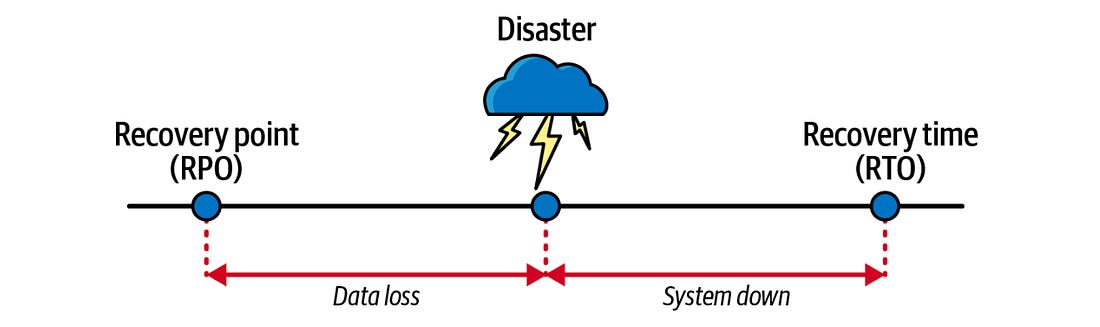
Основной фокус — disaster recovery (DR): процедуры при катастрофических сбоях. Ключевые концепции — Recovery Point Objective (RPO, максимум потери данных за время) и Recovery Time Objective (RTO, время восстановления системы).
Достижение нулевого RPO и RTO невозможно и экономически нецелесообразно; требуется баланс между надёжностью, сложностью и стоимостью. Разные части системы (например, платежи в банке vs регистрация новых клиентов) могут иметь разные требования.
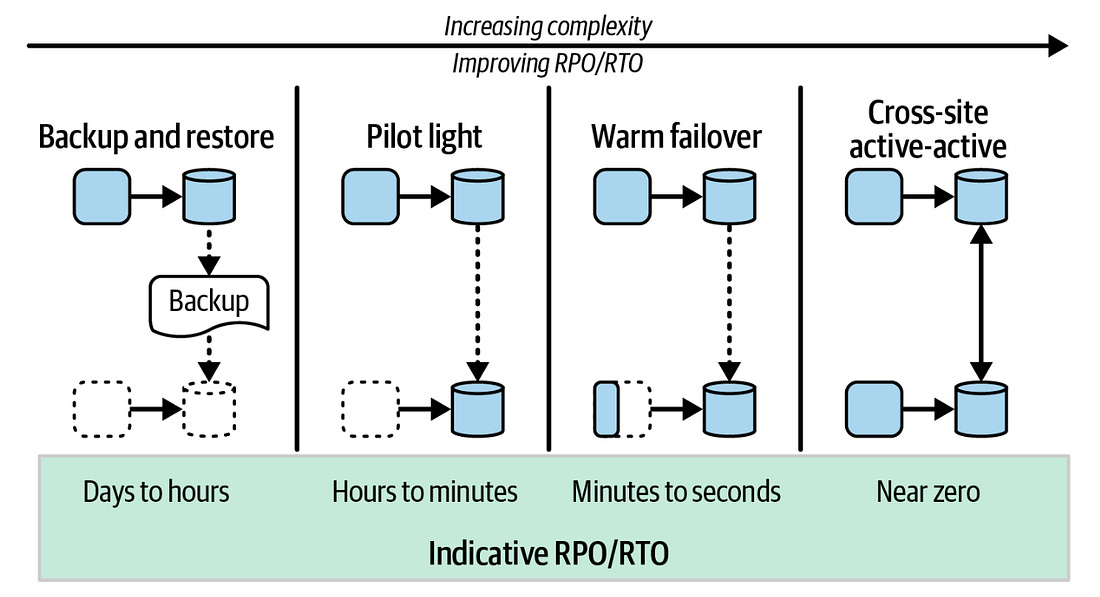
Описаны четыре паттерна DR с растущей сложностью: Backup and Restore, Pilot Light, Warm Failover и Multisite Active-Active.
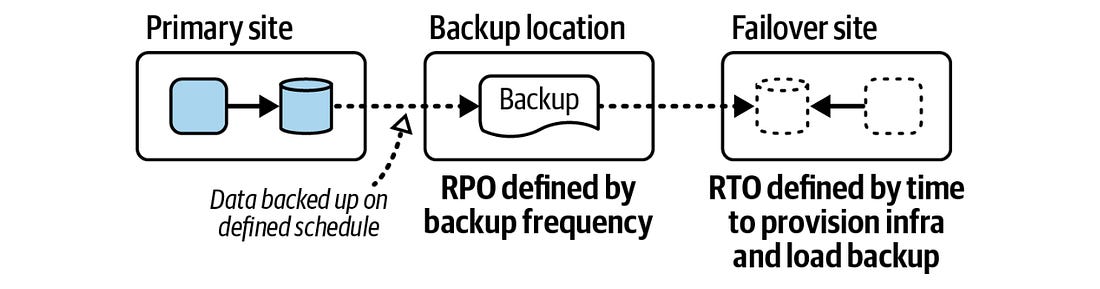
Самый простой — Backup and Restore: периодическое резервное копирование данных на отдельный сайт, затем восстановление инфраструктуры и переключение трафика при отказе основного узла. Для ИИ-систем критичны многовендорность, прозрачность затрат, мониторинг надёжности провайдеров моделей и их способность к изменению.
Выводы автора:
- RPO и RTO должны определяться совместно со стейкхолдерами с учётом бизнес-требований, регуляторных ограничений и баланса затрат на реализацию.
- Четыре паттерна DR (от простого Backup and Restore до Multisite Active-Active) можно внедрять инкрементально в зависимости от требуемых RTO и RPO для разных компонентов системы.
- Для ИИ-powered систем необходимо планировать многовендорность и мультимодельность, обеспечивать наблюдаемость за провайдерами моделей и готовиться к их потенциальным изменениям и недостаточности ресурсов.
По мере снижения RPO и RTO стоимость и сложность растут экспоненциально — и технически невозможно гарантировать нулевое значение ни для одного из них.
Оригиналы:Building resilient AI-powered software, and planning for when things go wrong · Building Resilient Distributed Systems
Почему √7 невозможно найти в геометрических конструкциях из кубов
Разработка и архитектура · Habr · 7/10
Статья рассказывает о математической загадке, продолжавшей интриговать учёных две тысячи лет: почему квадратный корень из 7 невозможно представить как расстояние между вершинами конструкции из единичных кубов, тогда как корни 1–6 и 8–11 находятся легко. Задача сводится к алгебраическому вопросу: можно ли записать 7 в виде суммы трёх квадратов целых чисел. Автор показывает элегантное доказательство через модульную арифметику: квадраты целых чисел при делении на 8 дают только остатки 0, 1 или 4, а их сумма (максимум 4+4+4=12) никогда не даст остаток 7. Материал прослеживает историю этой проблемы от Пифагорейцев через Диофанта, Ферма, Эйлера и Гаусса, показывая, как попытка обобщить простой геометрический паттерн привела к созданию целой области математики — аддитивной теории чисел. Статья объясняет ключевые концепции: многоугольные числа, предположение Баше о четырёх квадратах, модульную арифметику и её применение к этой классической проблеме.
Выводы автора:
- Число 7 невозможно представить как сумму трёх квадратов целых чисел, потому что любая такая сумма не может дать остаток 7 при делении на 8.
- Попытка найти все числа, выражаемые суммой квадратов, привела к развитию аддитивной теории чисел — целой области математики, занимавшей величайших математиков на протяжении двух тысячелетий.
- Ферма обнаружил, что семейства чисел, невыражаемых суммой трёх квадратов, имеют скрытую связь через степени четвёрки.
Как мы уже видели, некоторые числа невозможно представить в виде суммы трёх квадратов, например, семь. Но есть ли ещё подобные числа? В третьем веке нашей эры Диофант доказал, что таких чисел бесконечно много.
Оригиналы:Понадобилось две тысячи лет, чтобы найти причины отсутствия √7
Интервью с Сергеем Кушниренко об архитектуре игровых движков
Разработка и архитектура · Habr · 7/10
Интервью с опытным разработчиком Сергеем Кушниренко, автором книги «Game++. Устройство и оптимизация игрового движка». Кушниренко работает в игровой разработке более 15 лет, специализируется на C++, архитектуре движков и оптимизации производительности. Начал писать статьи на Хабре с 2014 года, когда восстанавливал старый ситибилдер Caesar III и захотел поделиться знаниями — многие проблемы разработчиков оказались типовыми. Книга «Game++» адресована программистам с опытом C++ и рассматривает не синтаксис языка, а инженерные задачи: управление памятью, архитектуру, работу в условиях ограниченных ресурсов и взаимодействие подсистем. Автор подчёркивает, что книга содержит принципы и рассуждения, а не готовые рецепты, и фокусируется на вопросе «почему» конкретные решения работают. Кушниренко считает важным баланс между общими принципами и практическими примерами: читатель должен понять идею, а код написать сам. Часть материала осталась в черновиках и позже была опубликована отдельными статьями на Хабре.
Выводы автора:
- Архитектура и структура данных часто важнее отдельных алгоритмов — производительность системы определяется их взаимодействием
- Техническая книга должна объяснять принципы и ограничения решений, а не предоставлять готовые рецепты без понимания контекста
- В игровых движках фундаментальные инженерные задачи (управление памятью, планирование задач, ограничения ресурсов) актуальны для любых крупных систем, не только для игр
Хороший пример должен давать читателю идею, а не просто показывать, что автор умеет писать код
Оригиналы:О программировании, книгах и разработке игр. Интервью с Сергеем Кушниренко
Яндекс: сбой оказался серьёзнее сценариев потери одного ДЦ
Разработка и архитектура · Habr · 7/10
Директор по стратегическому маркетингу Яндекса Андрей Себрант рассказал о масштабном инфраструктурном сбое компании, произошедшем 11 октября. Яндекс регулярно проводил учения по восстановлению после потери одного дата-центра, но текущий сбой оказался значительно серьёзнее этого сценария. Компания поэтапно восстанавливает сервисы (Поиск, Алиса, Карты, Такси, Почта и другие), в первую очередь те, которыми пользуется наибольшее число людей. При восстановлении сознательно ограничивают некоторые функции Яндекс 360 и Диска, чтобы снизить нагрузку на инфраструктуру. CEO Яндекс Пэй Дмитрий Пирогов подчеркнул, что средства пользователей в безопасности, так как деньги не хранятся в потерявшемся дата-центре, а записи о счётах синхронизированы на несколько площадок. В ликвидации последствий сбоя Яндексу помогают конкурирующие компании отрасли.
Выводы автора:
- Масштабный инфраструктурный сбой Яндекса превзошёл по серьёзности отработанные сценарии потери одного дата-центра, хотя опыт учений и архитектура помогают в восстановлении.
- Все средства пользователей Яндекс Пэй остаются в безопасности благодаря распределённому хранению записей о счётах на различные площадки.
Мы много лет регулярно проводим учения как работать с минус одним датацентром, это отлаженный сценарий. Но сейчас минус жестче.
Оригиналы:Директор по стратегическому маркетингу Яндекса о сбое инфраструктуры
Yandex Cloud в аварийном режиме после атак на три дата-центра
Кибербезопасность · Habr · 9/10
С 8 по 11 октября атаки БПЛА вывели из строя три дата-центра Яндекса (в Сасово, Калуге и Владимире), в результате чего Yandex Cloud перешёл в аварийный режим работы. На момент 11 октября консоль, API и IAM доступны, Compute работает частично, большинство отказоустойчивых кластеров баз данных переключились, но часть недоступна или работает в режиме read-only; Object Storage доступен только на чтение. Недоступны зоны ru-central1-b и ru-central1-a, выдача квот на дополнительные ресурсы приостановлена. В первом полугодии 2026 года Yandex Cloud имел около 64 тысяч клиентов. Компания не может подтвердить, что оборудование в Сасово удастся восстановить; в дата-центрах размещались все три суперкомпьютера Яндекса. По оценкам экспертов, поставка нового серверного оборудования займёт 2–3 месяца, а восстановление суперкомпьютеров в случае их уничтожения — 2–2,5 года. Яндекс договорился с Selectel, K2Cloud и VK Cloud об ускоренном размещении пострадавших клиентов и добавил в пользовательское соглашение пункт о форс-мажоре при атаках.
Выводы автора:
- Три ключевые зоны доступности Yandex Cloud вышли из строя в результате атак БПЛА, что привело платформу в аварийный режим с серьёзными ограничениями по доступности сервисов
- Восстановление инфраструктуры может занять месяцы или годы в зависимости от степени повреждения оборудования и суперкомпьютеров
- Компания рекомендует клиентам миграцию на альтернативные облачные платформы и согласовала ускоренное размещение пострадавших пользователей у конкурентов
Яндекс пока не может подтвердить, что оборудование в Сасово удастся восстановить.
Оригиналы:Yandex Cloud работает в аварийном режиме после атак на три дата-центра Яндекса
Калифорния судится с Polymaker за поддержку производства самодельного оружия
Кибербезопасность · Habr · 7/10
Округ Сан-Диего подал иск на производителя 3D-принтеров Polymaker, обвиняя компанию в целенаправленной поддержке сообщества изготовителей самодельного огнестрельного оружия (ghost guns). По мнению истцов, Polymaker рекламировала свой PLA-филамент специально для привлечения энтузиастов оружия, превращая обычный материал в регулируемую законом заготовку для огнестрельного оружия. Ключевой фигурой в споре стал Шон Аранда — эксперт по 3D-печати и сторонник оружия, чей YouTube-канал (123 тыс. подписчиков) был заблокирован в 2023 году за нарушение правил. Polymaker спонсировала его проект специальной катушкой филамента цвета хаки, а затем нанял его на работу в качестве менеджера по работе с клиентами, позже повысив до старшего технического менеджера. Истцы упоминают Аранду 65 раз в 39-страничном иске, утверждая, что его наняли именно из-за связей с сообществом 3D-печати оружия. Polymaker использует партнёрские программы для продвижения филамента через авторов контента, включая создателей материалов об оружии. Округ требует конфискации незаконно полученной прибыли, штрафов и судебного запрета на такую деятельность. Весной 2024 года нижняя палата парламента Калифорнии одобрила законопроект, криминализирующий обход программного обеспечения, предотвращающего 3D-печать компонентов огнестрельного оружия.
Выводы автора:
- Polymaker обвиняется в целенаправленном развитии и монетизации сообщества производства самодельного оружия через специальный маркетинг, спонсорство контент-креаторов и партнёрские программы
- Наём компанией Шона Аранды, известного своей деятельностью в сфере 3D-печати оружия, рассматривается как доказательство намеренной стратегии привлечения аудитории, связанной с ghost guns
- Калифорния планирует криминализировать обход защитного программного обеспечения для 3D-печати компонентов оружия, усиливая законодательное давление на индустрию
Polymaker активно развивала и монетизировала сообщество призрачного оружия, поддерживая его через рекламу и партнёрские отношения с авторами контента.
Оригиналы:Калифорния подала в суд на Polymaker из-за поддержки изготовителей самодельного оружия
Крупные банки сталкиваются с новой реальностью: торги охлаждаются, кредиты растут
Финтех и финансы · App Economy Insights · 8/10
Материал подробно разбирает итоги квартального отчётного сезона крупнейших американских банков, которые в совокупности отчитались о $32 млрд квартальной прибыли. JPMorgan Chase лидирует по кредитованию: чистая процентная маржа выросла на 13% до $27 млрд, пересмотрены прогнозы роста до $106,2 млрд на год. Goldman Sachs и JPMorgan доминируют в торговле акциями (рост на 72% и 49% соответственно), а вот торговля облигациями упала из-за роста доходности. Wells Fargo повысил руководство по ROE выше 11%, но рост доходов остаётся скромным. Потребители остаются устойчивы: расходы по картам выросли на 10-13%, дефолты управляемы, но расходы банков растут быстрее доходов. Большое внимание уделено предупреждению CEO JPMorgan Jamie Dimon об опасности ИИ-агентов, которые могут получать доступ к счётам клиентов и перемещать деньги между банками, угрожая дешёвым депозитам, лежащим в основе прибыльности банков.
Выводы автора:
- Торговля акциями остаётся сильной, но торговля облигациями слабеет, что создаёт дисбаланс в доходах инвестиционно-банковских подразделений
- Рост кредитования и здоровье потребительского спроса обеспечивают основу для дальнейшего роста прибыли, несмотря на охлаждение рынков капитала
- Руководители банков опасаются нарушения бизнес-модели из-за ИИ-агентов, которые могут снизить конкурентное преимущество в привлечении дешёвых депозитов
Если люди их используют, они должны понимать риск. Мы не позволим просто любому внешнему агенту войти в компанию, потому что это слишком рискованно для клиентов и для JPMorgan.
Сбер превратил общий счет в полноценный семейный банк
Финтех и финансы · Б.О: Банки · 8/10
Сбербанк рассказал о развитии семейного банкинга как комплексного продукта, а не просто общего счета. За год число клиентов, использующих семейные сервисы, выросло кратно до 24,5 млн человек (по состоянию на сентябрь 2026 года). Банк начал стратегию три года назад, заметив, что клиенты самостоятельно адаптировали существующие продукты под семейные нужды. Исследования показали спрос на совместное ведение хозяйства, особенно со стороны мужчин, и потребность в заботе о детях и пожилых родителях. Лариса Болотина, директор дивизиона «Массовый высокодоходный сегмент», подчеркивает, что в отличие от аналогов, Сбер предоставляет реальную юридическую доверенность, а не просто дополнительные карты с ограниченными правами. Философия продукта построена на трех принципах: простота, безопасность и выгода. Сервисы включают общие вклады для целевых накоплений (отпуск, образование, ипотека), шеринг премиальных привилегий и защиту через «Доверенный контакт» от мошенничества. Банк зафиксировал неожиданный положительный эффект: совместный доступ к кредиту снизил просрочки на ранних этапах на 10% за счет дополнительного контроля. В ближайших планах — развитие детского профиля, школьных сервисов, PFM-анализ трат и услуги мобильной связи для семей.
Выводы автора:
- Сбер предоставляет полноценный семейный банк с юридической доверенностью, позволяющей равноправно использовать все функции платежного счета, а не просто дополнительные карты с ограничениями
- Семейный банкинг охватывает разные типы близких (супруги, дети, пожилые родители, даже соседей по квартире), используется для совместного бюджета и целевых накоплений, особенно на отпуск и образование
- Дополнительный контроль через общий доступ и сервис «Доверенный контакт» снизил просрочки кредитов на 10% и помогает защитить от мошенничества, особенно пожилых людей
Важно и то, что у нас под «капотом» — не просто общий счет через дополнительные карты с ограниченными правами, а реальная доверенность с соблюдением всех юридических норм.
Оригиналы:Мы сделали лучший семейный банк
Банки через 5 лет: ИИ-агенты вместо продуктов, конец «налога на невнимательность»
Финтех и финансы · Б.О: Не банки · 8/10
На юбилейном форуме Ассоциации ФинТех топ-менеджеры ведущих банков и финтех-компаний обсудили, как изменятся банковские продукты к 2030 году под влиянием технологий инновационных платежей, токенизации и ИИ-агентов. Ключевой вывод: радикально изменятся не сами продукты (вклады, кредиты, переводы существуют уже 600+ лет), а способ их получения и модель оплаты. Поисковые запросы о виртуальных картах, ЦФА и мультибанкинге выросли на 2000% в год, ИИ-агенты вошли в топ-3 популярных тем. Главная угроза для банков — исчезновение «налога на невнимательность» (забытые пролонгации, неотключенные подписки), который сегодня составляет часть маржи розничного банка. ИИ-ассистенты будут рационально использовать все программы лояльности, что убьёт кешбэк в привычном виде и связанные с ним рекламные бюджеты. Спикеры назвали перспективные продукты 2030 года: персональный ИИ-агент (финансовый советник), финансовый автопилот, токенизация реальных активов (RWA), страховой продукт на риски ИИ-агента. Банкам нужно целиться не в саму услугу, а в ценность для клиента, а крупным игрокам — смелее экспериментировать и договариваться о технологиях для всего рынка.
Выводы автора:
- К 2030 году базовые банковские продукты останутся неизменными, но изменятся способ их доставки и модель монетизации через появление ИИ-агентов и открытых API
- ИИ-агенты полностью нивелируют «налог на невнимательность» (маржу на забывчивости клиентов), заставляя банки конкурировать по реальной ценности, а не условиям
- Защита финансовых сервисов, встроенных в телеком и платежные системы, и страхование рисков ИИ-агентов станут критическими условиями развития финтеха
Сегодня часть маржи в розничном банке — это «налог на невнимательность». В будущем ИИ-ассистенты полностью нивелируют этот налог, и банки лишатся маржи.
Нобелевская премия-2026: как ожидания потребителей меняют макроэкономику
Экономика · РЭШ · 9/10
Роберт Холл и Майкл Вудфорд получили Нобелевскую премию по экономике за включение ожиданий в макроэкономические модели. До 1970-х экономисты полагали, что простые стимулы (снижение ставок, рост госрасходов) всегда помогают восстановлению, но эта логика обрывалась, когда граждане и компании начинали предвидеть инфляцию — результат была стагфляция 1970-х. Холл в 1978 году доказал на данных США, что потребление домохозяйств (две трети ВВП) сглаживается по времени: люди сберегают в хорошие периоды и тратят сбережения в плохие, поэтому государственные стимулы действуют слабее, чем предполагалось. Вудфорд разработал «неокейнсианские модели» — микрообоснованные макромодели, учитывающие рациональные ожидания агентов. Эти модели успешно применялись во время кризиса 2008–2009 годов и пандемии 2020–2021 годов, позволяя точнее оценивать эффективность госполитики и финансовых шоков. Сегодня неокейнсианские модели — стандарт для центробанков и правительств по всему миру.
Выводы автора:
- Включение ожиданий потребителей и фирм в макромодели фундаментально изменило понимание того, как работают государственные стимулы и монетарная политика.
- Неокейнсианские модели лучше предсказывают последствия экономических шоков и позволяют регуляторам минимизировать волатильность экономики.
- Работы Холла и Вудфорда стали основой для практической макроэкономической политики центробанков и правительств во всём мире.
Будущие шоки непредсказуемы и не связаны с текущими макропеременными, поэтому невозможно на них реагировать «уже сегодня».
Оригиналы:Цена ожиданий: как изучение поведения потребителей принесло учёным Нобелевскую премию (Forbes)
Герман Греф: Сбер будет стоить 1000 рублей за акцию
Экономика · Б.О: Экономика · 8/10
Герман Греф на инвестфоруме Сбера высказал смелый прогноз о росте стоимости акций банка до 1000 рублей за штуку (при историческом максимуме около 388 рублей), считая российские активы сильно недооценёнными из-за геополитики. По его мнению, Сбер зарабатывает свыше 20 млрд долларов при капитализации около 80 млрд долларов — то есть стоит значительно дешевле сопоставимых по прибыльности иностранных компаний. Греф рекомендует частным инвесторам портфель из пяти ингредиентов: депозиты и флоутеры (консервативная основа с 5–6% реальной доходности), длинные ОФЗ (потенциал роста на 10–20%), дивидендные акции (Сбер, «Газпромнефть», «ЛУКОЙЛ»), БПИФы для диверсификации и ЦФА с обязательным валютным хеджем (около 20% капитала). Герман Греф был ранним инвестором в биткоин, но не рекомендует включать его в стратегический портфель из-за высокого риска; мемкоины он назвал казино без бесплатного бара. Сбер разрабатывает мультиагентную систему управления инвестициями и планирует предложить ИИ-советников клиентам в 2027 году, однако Греф считает, что окончательное инвестиционное решение должно оставаться за человеком. Критически важна защита прав собственности инвесторов, прозрачность отчётности и качество корпоративного управления для устойчивого роста российского фондового рынка.
Выводы автора:
- Российские акции недооценены из-за геополитики, и после нормализации ситуации рынок может войти в фазу роста, но сроки остаются неопределёнными
- Инвестиционный портфель должен приносить текущий доход (через депозиты, облигации, дивиденды) в ожидании переоценки, а не состоять только из спекулятивных позиций
- Развитие российского рынка требует не только макроэкономических улучшений, но и защиты прав инвесторов, прозрачности корпоративного управления и долгосрочного доверия
Портфель из депозитов — это как хороший бульон. Но если хочешь приготовить хороший борщ, нужно добавить ингредиенты.
Оригиналы:«Сбер будет стоить 1000 рублей за акцию?» — «Как минимум!»
Анализ 155 000 IT-вакансий России: что влияет на зарплату и как читать между строк
Продукт и карьера · Habr · 9/10
Крупное исследование 155 тысяч IT-вакансий России (май–сентябрь 2026) выявило, как описание вакансии коррелирует с уровнем оплаты труда. Анализ показывает четыре сегмента рынка: 56% вакансий массовые и высокооплачиваемые (Project/Product Manager, аналитика, DevOps, Python, Go), 31% массовые и дешёвые (HR, SMM, маркетинг, дизайн), остальные редкие позиции. По грейдам: стажёры получают 52К, джуны — 80К, мидлы — 165К (скачок на 106%), синьоры — 190К, лиды — 200К. Самый дорогой карьерный переход — от junior к middle. "Опыт от 3 лет" — магическое число у 39% вакансий с требованиями к стажу; между 3 и 4 годами скачок на 73%, после 4 лет стаж перестаёт конвертироваться в доп. зарплату. Красные флаги (минус к деньгам): "дружная семья" −19%, "многозадачность" −14%, "молодой коллектив" −14%. Зелёные флаги (плюс к деньгам): опционы +69%, ДМС +50%, годовой бонус +50%, удалённость +20%. Количество упоминаемых технологий коррелирует с зарплатой: 0 технологий — 88К, 15+ — 241К (разница в 2,8 раза).
Выводы автора:
- Карьерный рост в IT зависит скорее от перехода на middle-уровень, чем от количества лет опыта; после 4 лет стаж как таковой перестаёт влиять на зарплату.
- Фраза в вакансии — маркер сегмента рынка: "дружная семья" и "многозадачность" указывают на массовый найм с меньшими зарплатами, ДМС и опционы — на серьёзного работодателя с выше-средним уровнем оплаты.
- Количество технологий в требованиях и конкретность описания прямо коррелируют с зарплатой: вакансии с 15+ технологиями платят почти в 3 раза больше, чем без упоминания технологий.
Почти 8 из 10 вакансий с грейдом в заголовке ищут опытных (senior или руководителя), и только чуть больше 1 из 10 новичков. На одну вакансию для новичка приходится 6,5 вакансии для опытных.
Как оценить наличие экономического рва у стартапа
Продукт и карьера · Lenny's Newsletter · 8/10
Статья объясняет, как определить, есть ли у стартапа устойчивое конкурентное преимущество (так называемый моат), который критически важен при выборе места работы. В эпоху ИИ, когда любой может быстро создать продукт, только компании с настоящим экономическим рвом смогут достичь значительного успеха и не стагнировать при появлении конкуренции. Автор предлагает трёхшаговый фреймворк оценки: найти тип преимущества, измерить его потенциальную силу и проверить, работает ли оно. Существует ровно четыре типа настоящих преимуществ (компаундирующих выгод), которые создают самоусиливающиеся циклы: switching costs (встроенность в рабочие процессы), network effects (растущая ценность с каждым пользователем), scale economies (снижение себестоимости с объёмом) и data effects (улучшение продукта за счёт накопления данных).
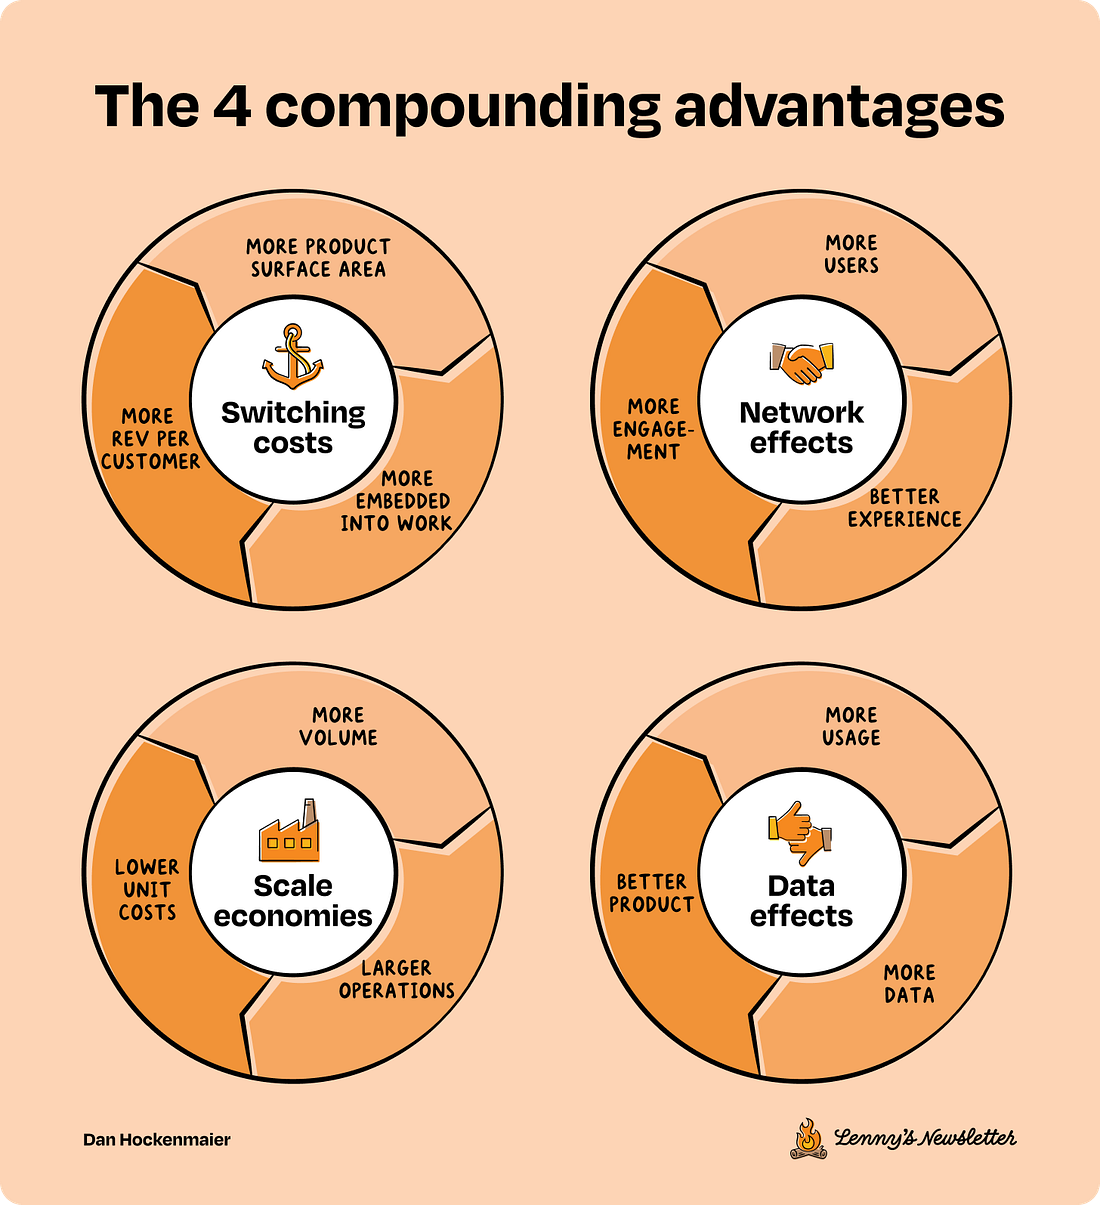
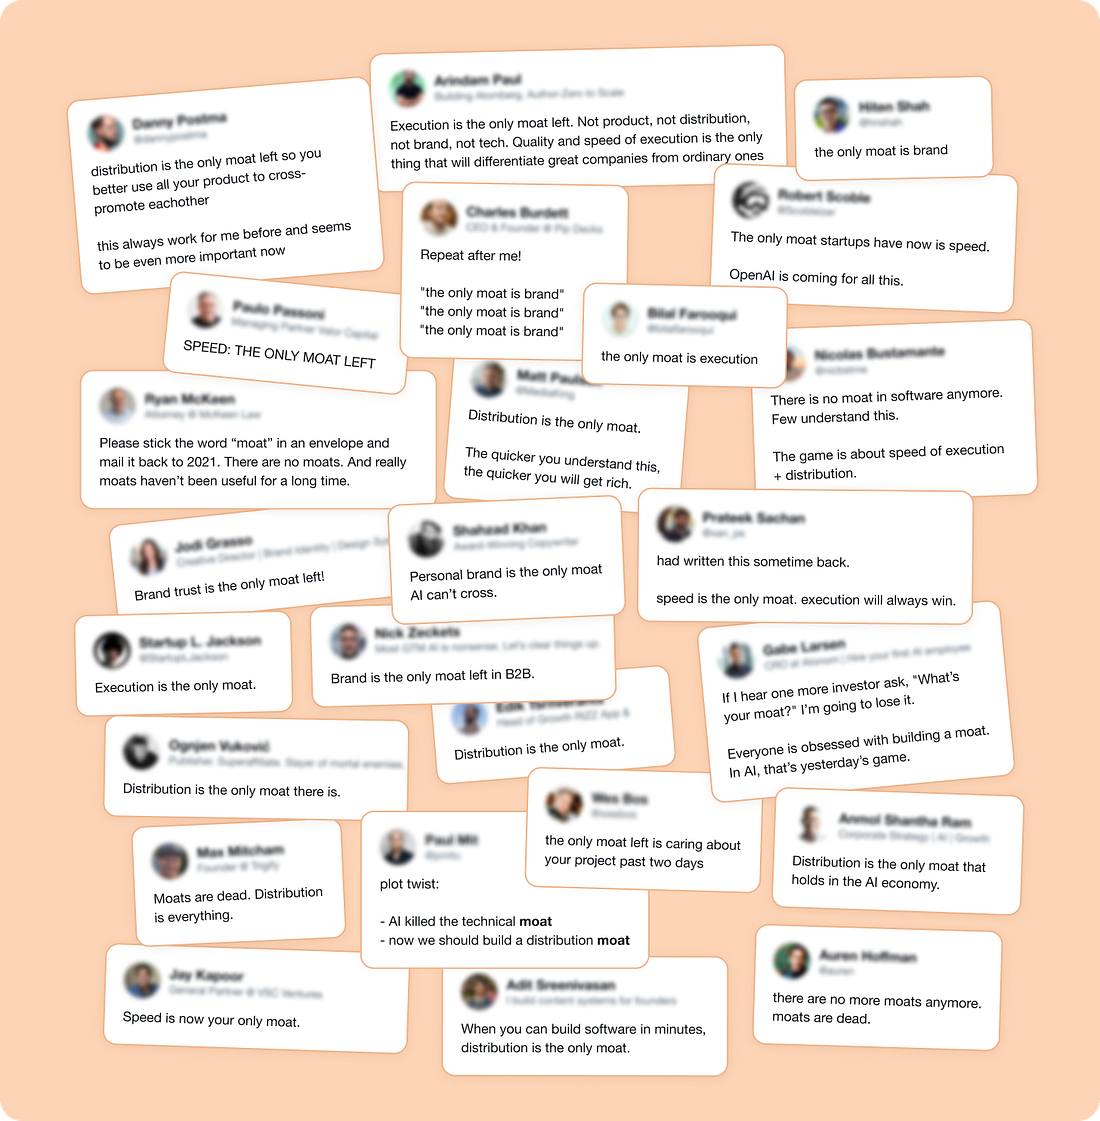
Остальные часто упоминаемые преимущества — скорость выполнения, дистрибьюция, бренд — это скорее топливо для роста, а не настоящие мосты. Например, Rippling демонстрирует стратегию switching costs, интегрируя HR, финансы и payroll в единую платформу. Zipline показывает scale economies: себестоимость доставки упала с $300 до $12 благодаря масштабированию производства и плотности доставок. Stripe Radar использует data effects, обработав 70 триллионов точек данных для лучшей детекции мошенничества.

Выводы автора:
- Настоящий экономический ров — это четыре типа самоусиливающихся преимуществ: встроенность, сетевые эффекты, экономика масштаба и накопление данных; всё остальное — лишь топливо для роста.
- При оценке стартапа сосредоточьтесь на том, что команда реально делает каждый день и какие отделы у них самые большие, а не на их заявленной стратегии.
- В эпоху ИИ компании с потенциалом для data effects становятся привлекательнее, так как каждое использование генерирует данные для улучшения моделей.
Если вы не видите потенциала ни для одного из этих преимуществ в оцениваемом стартапе, это красный флаг.
Оригиналы:Полный материал на Lenny's Newsletter
Коротко
Разработка и архитектура
- Разбор и разработка модулей быстрой зарядки Power Delivery – Статья разбирает тему зарядных устройств и проектирования модулей Power Delivery на примере анализа дешёвого поддельного блока GaN 240W и разработки собственных решений.
Финтех и финансы
- Яндекс Пэй восстанавливает работу после атаки на дата-центр – Яндекс Пэй продолжает восстанавливать работу после повреждения дата-центра во Владимире в результате атаки беспилотного летательного аппарата.
Продукт и карьера
- «Молния» — российский мессенджер с платной моделью вышел в RuStore – Российская компания «Ред Софт» и китайская Passion Tech запустили в RuStore отечественный мессенджер «Молния» для Android, позиционируя его как альтернативу иностранным сервисам.