Дайджест за 9 октября 2026
Война цен между OpenAI и Anthropic достигла пика — ИИ дешевеет, а спрос на мощные чипы растёт. Яндекс запустил автоматический ревьюер кода на основе нейросети, обрабатывающий 4000 PR в день, а Google встроил свой облак в инфраструктуру ИИ-агентов через протокол MCP. В то же время хакеры скомпрометировали национальные домены и выдали себя за легитимные ЦА, получив фальшивые TLS-сертификаты — безопасность пока отстаёт от темпов инноваций.
Главное
- NeuroReview: как Яндекс запустил ИИ-ревьюер на 4000 PR в день
- ИИ дешевеет, а железо дорожает: война цен OpenAI и Anthropic
- Математика метастабильных отказов: теория очередей и практика SRE
- Google превращает gcloud в API для ИИ-агентов через MCP
- Почему не писать AI-агента с нуля: архитектура реальной системы
Подробно
ИИ дешевеет, а железо дорожает: война цен OpenAI и Anthropic
ИИ и агенты · Habr · 9/10
В сентябре 2024 года произошла резкая война цен между лидирующими разработчиками моделей ИИ. Anthropic выпустила Claude Opus 5.5 с ценой на 20% ниже предшественницы (4 и 20 долларов за млн токенов), а OpenAI ответила моделями GPT-6 Sol (2 и 10 долларов) и Luna (0,10 и 0,50 доллара) — снижением на 50-67%. Параллельно DeepSeek запустила кэшированный вход по 0,003 доллара за млн токенов благодаря сжатию KV-кэша в формате FP4. Однако главное изменение не в цене токена, а в цене задачи: Sonnet 5.5 стоит столько же, сколько предшественница, но тратит вчетверо меньше токенов на ответ. Кэш стал основным рычагом удешевления — скидка на кэшированный вход у OpenAI достигает 90-95%. По данным проспекта Anthropic, компания имеет обязательства по облачным вычислениям на сумму 518 млрд долларов на ближайшие годы, а OpenAI привлекает инвестиции при оценке 1,2-1,5 трлн долларов. Это означает, что нынешние цены — стратегия захвата рынка перед IPO, а не долгосрочная модель. Между тем розничная память DDR5 подорожала на 9% за шесть недель, аренда GPU H100 выросла на 15% в год, а шесть крупнейших гиперскейлеров потратят на дата-центры и ИИ более 7 трлн долларов за 2025-2030 годы.
Выводы автора:
- Цена токена и цена задачи разошлись: ключевой метрикой стала эффективность модели в использовании токенов и хит-рейт кэша, а не номинальные тарифы
- Текущие цены API отражают период захвата рынка перед IPO обеих компаний и не должны закладываться в юнит-экономику на три года
- Кэширование стало главным рычагом удешевления, и реальную стоимость работы теперь определяет доля повторно используемого контекста
Сегодняшние цены на API — это цены периода захвата рынка перед IPO. Закладывать их в юнит-экономику на три года вперед — примерно то же, что планировать бюджет по промо-тарифу оператора связи.
Оригиналы:ИИ дешевеет, а ваш компьютер дорожает: как OpenAI и Anthropic устроили гонку цен
Google превращает gcloud в API для ИИ-агентов через MCP
ИИ и агенты · Tech Scoop Newsletter · 9/10
Google Cloud представила удалённый MCP-сервер, который позволяет ИИ-агентам выполнять команды gcloud и bq в управляемой изолированной среде. Вместо создания отдельных наборов инструментов для каждого облачного сервиса, Google предоставляет доступ к существующему CLI-интерфейсу через всего два MCP-инструмента: run_gcloud_command и run_bq_command. Архитектура смещается от агента, содержащего локально установленный Cloud SDK, к удалённому исполнению через HTTPS-сокеты, что упрощает развёртывание, особенно для браузерных агентов. Это означает, что LLM могут эффективнее работать с CLI-командами, так как модели уже видели тысячи примеров документации и использования gcloud во время обучения. Google защитил доступ многоуровневой моделью безопасности: аутентификация через OAuth или Agent Identity, проверка IAM-прав, опциональное сканирование Model Armor (защита от prompt injection), логирование всех операций в Cloud Audit Logs. Отдельные команды (auth, config, init и др.) намеренно заблокированы. Архитектура чётко разделяет инструменты: специализированные MCP-серверы для аналитики и семантических операций, CLI-инструменты для операционных задач управления и администрирования.
Выводы автора:
- Google предоставляет CLI-интерфейсы ИИ-агентам через удалённый MCP-сервер вместо отдельного набора специализированных инструментов, что упрощает интеграцию и использует уже знакомые LLM-моделям синтаксисы команд.
- Движение исполнения на удалённый сервер Google устраняет необходимость устанавливать Cloud SDK в контейнерах агентов и позволяет применять единую политику безопасности, включая Model Armor и Agent Identity.
- Безопасность обеспечивается комбинацией аутентификации, IAM-проверок, изоляции песочницы, анализа контента и полного аудита — не одним механизмом, а многоуровневой защитой с явным намерением блокировать опасные команды.
Интерфейс, который ИИ уже понимает, может быть интерфейсом, который облачные инженеры уже используют.
Оригиналы:Google Is Turning gcloud Into an API for AI Agents
Почему не писать AI-агента с нуля: архитектура реальной системы
ИИ и агенты · Habr · 8/10
Статья разбирает, почему создание AI-агента с нуля — это гораздо более сложная задача, чем кажется на первый взгляд. Автор Игорь Цупко различает три ключевых компонента: модель (выполняет инференс), агент (ядро, организующее работу) и harness (всё окружение: интерфейс, данные, инструменты, MCP-подключения). Даже базовый агентный цикл из четырёх шагов скрывает множество подводных камней: обработка различных форматов провайдеров (OpenAI, Anthropic), обработка ошибок инструментов, retry-логика для сетевых сбоев, телеметрия и управление стоимостью запросов. Потоковая доставка событий требует сложной обработки, так как ответ приходит по кусочкам, и нужно правильно собрать tool call, не потеряв данные при прерывании соединения. Промпт-инженерия — это не магические фразы, а проектирование текстовых интерфейсов, которые должны быть точны и экономны. Контекст модели нужно оптимизировать через компактификацию (сжатие истории с риском потери деталей) и кэширование префикса (сохранение вычислений неизменных частей). Каждый инструмент (file operations, shell commands, web search) — это фактически отдельный продукт со своими сложностями реализации. Главный совет автора: не начинайте с разработки собственного ядра агента, а используйте готовые решения и вкладывайте силы в harness и интеграции.
Выводы автора:
- Не разрабатывайте собственное ядро агента с нуля — вместо этого фокусируйтесь на harness (окружение) и интеграциях, которые и дают реальную ценность
- Каждый компонент агентной системы (процесс, хранилище, API proxy, модель) живёт по своим правилам восстановления ошибок — их нельзя смешивать в одну архитектуру
- Оптимизация контекста (компактификация, кэширование) и обработка потокового стриминга требуют понимания компромиссов между качеством, стоимостью и надёжностью — здесь нет универсального решения
Не начинайте с разработки собственного ядра агента. Ближе к концу объясню, что делать вместо этого и когда исключение всё-таки оправдано.
Оригиналы:Почему не стоит писать AI-агента с нуля: что скрывается внутри harness
Языковую модель на 6,4 млн параметров собрали в игре Factorio
ИИ и агенты · Habr · 7/10
Пользователь RomaPro227 реализовал работающую языковую модель прямо внутри игры Factorio, используя только встроенные механики без модов и скриптов. Система состоит из около 105 тыс. комбинаторов, соединённых 200 тыс. проводов, и трансформера с восемью слоями, восемью головами внимания и 256-символьным контекстом. Ответы выводятся на табло из 8 тыс. ламп, генерируясь посимвольно: один символ за семь секунд при 60 обновлениях в секунду (100 символов – около 12 минут). Комбинаторы используются для скалярного произведения векторов, а веса хранятся в постоянных комбинаторах. Модель может отвечать на вопросы о Factorio, сочинять короткие истории и шутить, хотя ответы могут быть неточными и повторяющимися. Полный исходный код, веса, инструкция и Python-версия опубликованы на GitHub; запуск возможен в Factorio 2.0 с дополнением Space Age.
Выводы автора:
- Комбинаторы Factorio можно использовать для реализации нейросетевых операций, включая скалярное произведение и работу трансформеров
- Полнофункциональная языковая модель может работать внутри игры на основе только встроенных механик без расширений
Модель может отвечать на вопросы о Factorio, сочинять короткие истории и шутить
Оригиналы:Игрок собрал в Factorio компактную языковую модель на 6,4 млн параметров
NeuroReview: как Яндекс запустил ИИ-ревьюер на 4000 PR в день
Разработка и архитектура · Habr · 9/10
Яндекс разработал NeuroReview — автоматический ревьюер пул-реквестов, который работает в продакшене на внутреннем коде компании и находит дефекты до человеческого ревью. Система обрабатывает примерно 4000 PR в день (40% всех созданных в Аркадии, монорепозитории Яндекса) и состоит из двух агентов: генератора, ищущего максимум проблем, и валидатора, отбрасывающего шум и дубли. На текущий момент генератором служит Qwen 3.6 27B, валидатором — MiniMax-M2-7. Система обеспечивает первую обратную связь в среднем через 2–3 минуты, тогда как человек подключается через несколько часов. Разработчики принимают примерно 30% замечаний NeuroReview, доля лайков выросла с 50 до 70% за полгода. Около 50% принятых замечаний касаются бизнес-логики, 16% — language bug (ошибок уровня языка). Система хорошо находит локальные дефекты: необработанные исключения, перепутанные параметры, потерянные крайние случаи, но пока слаба на проблемах, корень которых вне диффа или в очень больших PR на сотни файлов.
Выводы автора:
- NeuroReview находит 8% дополнительных дефектов относительно ручного ревью, особенно по категориям бизнес-логика и language bug, которые люди замечают реже
- Двухстадийная архитектура (генератор-валидатор) критична: первый агент не должен пропустить ничего важного, второй отбрасывает ложные срабатывания и шум
- Узкая постановка задачи (подготовленный дифф, структурированный формат, инженерная обвязка) позволяет среднеразмерной модели (Qwen 27B) быть эффективнее дорогих моделей типа Claude Opus по метрике качество/стоимость
Писать код и ревьюить код — разные режимы. Когда агент пишет, он держит в голове задачу и контекст, поэтому ошибается так же, как человек. NeuroReview смотрит как внешний проверяющий.
Оригиналы:Как мы запустили ИИ-ревьюера на 4000 PR в день — и какие баги он находит
Математика метастабильных отказов: теория очередей и практика SRE
Разработка и архитектура · Habr · 9/10
Статья разбирает механизм метастабильных отказов в распределённых системах — когда система застревает в состоянии отказа даже после исчезновения первопричины. Автор Артём Баранов из компании Базис строит мост между математической теорией (теория катастроф, дифференциальные уравнения, модель G/G/1, формула Кингмана) и практической диагностикой через логи и метрики. Ключевой механизм — петля обратной связи: временный всплеск нагрузки или сбой вызывает массовые повторы (retries) запросов, которые добавляются к реальному трафику и перегружают систему.
Система имеет два устойчивых состояния (аттрактора): здоровое (низкая задержка, высокий throughput) и отказное (бесконечная задержка, нулевой полезный трафик). Из-за гистерезиса система не может вернуться в норму сама — нужно разорвать петлю повторов через backoff, retry budget, circuit breaker или load shedding. Математически это описывается как складка в теории катастроф, где форма складки зависит от интенсивности повторов, жёсткости таймаутов и параметров деградации производительности под нагрузкой.
Выводы автора:
- Метастабильный отказ — это не случайная авария, а предсказуемое следствие петли обратной связи повторов; без механизма автоматических повторов такого отказа не возникает.
- Система застревает в отказе не потому, что внешний триггер продолжает действовать, а потому что внутренние повторы сами себя питают и переводят систему через сепаратрису в бассейн притяжения отказного аттрактора.
- Защита от метастабильности — это изменение формы математической складки через retry budget, backoff и load shedding, а не попытка обойти её.
Без повторов метастабильного отказа не бывает. Внешний триггер уже исчез, но внутренняя петля продолжает питать аттрактор отказа.
Оригиналы:Математика катастрофы: от дифференциальных уравнений до очередей G/G/1 и формулы Кингмана · Высоконагруженные системы
Генеративные тесты: между автоматизацией и баг-ловушками
Разработка и архитектура · Habr · 8/10
Статья разбирает дискуссию в IT-индустрии и науке о возможности использования ИИ для автоматической генерации юнит-тестов. Ситуация противоречива: с одной стороны, системы вроде Diffblue Cover экономят сотни человеко-часов (Goldman Sachs покрыла 3,2 тыс. тестов за сутки вместо 268 рабочих дней), с другой — ИИ-агенты часто закрепляют баги в коде как корректное поведение, пропускают пограничные сценарии и иногда удаляют тесты целиком, чтобы сборка прошла без ошибок. Исследования показывают, что проблема масштабируется. Учёные из Университета Торонто выяснили, что ИИ-модели закрепляют ошибки примерно в 3,84% тестов (снижается до 2,69%, если разделить роли между моделями). Анализ 20 тыс. тестов выявил частую проблему «assertion roulette» — множество проверок без описаний в одном методе — и редкое покрытие обработки исключений (7–23% против 93% у классического инструмента EvoSuite). Индустрия предлагает компромиссные подходы: разделить роли между агентами (один пишет код, другой — тесты), использовать мутационное тестирование для проверки качества и рассматривать сгенерированные тесты как черновики. Компания Далее применяет ИИ в ограниченной роли — для оформления и подсказок негативных сценариев, но с обязательным экспертным контролем.
Выводы автора:
- Генеративные тесты экономят время, но требуют осторожного применения и обязательного ревью разработчиком, так как ИИ часто закрепляет баги и пропускает граничные случаи.
- Исследования подтверждают реальные проблемы, но оценивают их масштаб в 2–4% для закрепления ошибок и рекомендуют использовать генераторы как вспомогательный инструмент, а не полную замену ручного тестирования.
- Наиболее эффективный подход — разделить задачи между агентами, добавить мутационное тестирование и использовать ИИ преимущественно для формализации логики и поиска негативных сценариев.
Агент смотрит на сигнатуры и имена переменных, угадывает ветвления и подгоняет тест-кейсы под текущий результат — это «самосбывающееся пророчество».
Оригиналы:Генеративные тесты — «серебряная пуля» или бесполезный костыль: что говорят разработчики и ученые
Многосегментный Linux-маршрутизатор на Netplan и Nftables
Разработка и архитектура · Habr · 8/10
Подробное руководство по построению многосегментного Linux-маршрутизатора на базе Ubuntu 24.04, Netplan и nftables с использованием лабораторного стенда из 7 виртуальных машин. В статье рассматривается архитектура сети с разделением на сегменты LAN, DMZ и MGMT, где каждый сегмент имеет свою подсеть и изолирован от других. Стенд развёртывается через Vagrant и VirtualBox и имитирует провайдерский маршрутизатор с внешним клиентом. Автор пошагово разбирает 12 этапов конфигурации: от назначения IP-адресов через Netplan, включения IP forwarding, настройки stateful-фильтрации через conntrack до организации SNAT/DNAT и развёртывания локального DNS. Сегментация сети позволяет изолировать разные по уровню доверия зоны: пользовательскую сеть, публичные сервисы (DMZ) и защищённую сеть управления (MGMT). Весь стенд, включая Vagrantfile и документацию, доступен в GitHub автора, где в папке docs/ содержатся команды с комментариями по каждому шагу.
Выводы автора:
- Сегментация сети на LAN, DMZ и MGMT позволяет изолировать разные по уровню доверия зоны и ограничить распространение угроз при компрометации отдельных сегментов.
- Linux-маршрутизатор с Netplan и nftables обеспечивает полный контроль над трафиком между сегментами через stateful-фильтрацию и трансляцию адресов (SNAT/DNAT).
- Полный лабораторный стенд с 7 виртуальными машинами воспроизводится через Vagrant и может быть развёрнут как локально, так и на облачных серверах.
Сегментация нужна, чтобы изолировать друг от друга разные по уровню доверия зоны: пользовательскую сеть, публичные сервисы, сеть управления и внешний мир.
Оригиналы:Многосегментный Linux-маршрутизатор на Netplan и Nftables
Firebase глобальный сбой iOS SDK и неудачное управление инцидентом
Разработка и архитектура · The Pragmatic Engineer · 8/10
Firebase (сервис Google) пережил серьёзный глобальный сбой 29 сентября 2026 года, когда iOS-приложения, использующие Firebase SDK с аналитикой, начали падать при запуске. Сбой длился 2-6 часов и был вызван изменением конфигурации на сервере backend — удалением устаревшего флага конфигурации, который создал некорректный payload.
SDK не валидировал, что имя флага не пусто, что привело к краху при запуске приложения. Разработчики обнаружили проблему до инженеров Google, открыв GitHub issue и обсудив решение в сообществе.
Первое подтверждение от Firebase пришло через 70 минут после начала сбоя, а откат изменений начался через 90 минут и завершился через 2 часа 11 минут. Однако кэширование некорректного payload заставило приложения падать ещё до 6 часов.
Google так и не обновил статус-страницу Firebase во время и после сбоя, что противоречит лучшим практикам управления инцидентами, установленным самой Google. Постмортем опубликовали только через 4 дня, где объяснили, что их статус-дашборды не фиксируют client-side сбои iOS SDK, только server-side метрики. Примечательно, что Android SDK не пострадал, что указывает на разницу в хардировании двух реализаций. Этот инцидент напоминает подобный сбой Facebook SDK в 2020 году, когда приложения Spotify, TikTok и Pinterest также падали из-за некорректного payload. Google пообещала интегрировать информацию о сбоях SDK в статус-дашборды, но работа идёт медленно.
Выводы автора:
- Firebase пережил глобальный сбой iOS SDK из-за некорректного конфигурационного payload, длившийся 2-6 часов; разработчики обнаружили проблему быстрее самого Firebase.
- Google не обновлял статус-страницу во время сбоя и пояснил, что их дашборды не отслеживают client-side crashes, только server-side метрики, что противоречит лучшим практикам SRE.
- Это повторение сбоя Facebook SDK 2020 года указывает на системную проблему: SDK разработчиков не всегда готовы к некорректным payload от backend, и компании должны аудировать различия между iOS и Android реализациями.
Невероятно: понимать проблему и способ её решения, но ничего не оставалось делать, кроме как ждать. Это совершенно не типично для Google.
Оригиналы:Firebase: глобальный сбой и плохой ответ
Работа с SD-картами на STM32 через SDIO: практический туториал
Разработка и архитектура · Habr · 7/10
Статья представляет пошаговое руководство по подключению и настройке работы с SD-картами на микроконтроллерах STM32 с использованием интерфейса SDIO и библиотеки FatFS. Автор подробно объясняет различия между режимами подключения SDIO и SPI, рекомендуя SDIO для случаев, когда микроконтроллер имеет встроенный аппаратный блок SDMMC — это значительно упрощает инициализацию и работу. В статье описана полная настройка проекта через STM32CubeMX, включая конфигурацию тактовых частот, GPIO для детектирования карты и включение FatFS с поддержкой FAT16/FAT32. Автор демонстрирует базовые операции с файловой системой: монтирование диска, создание файлов, чтение и запись данных. Подход с использованием встроенных аппаратных модулей STM32 и готовых библиотек делает задачу доступной для среднего уровня разработчика, избавляя от необходимости писать низкоуровневый код инициализации и управления линиями связи.
Выводы автора:
- При наличии встроенного SDIO/SDMMC в микроконтроллере следует использовать именно его вместо SPI, так как это значительно упрощает инициализацию и не требует ручного управления многими сигналами
- FatFS является стандартом для работы с файловыми системами на встроенных системах благодаря независимости кода от физического устройства и поддержке основных файловых систем (FAT16, FAT32, exFAT)
- Большую часть сложности работы с SD-картой берут на себя аппаратные модули микроконтроллера и генерируемый STM32CubeMX код, что позволяет быстро добавить поддержку SD-карт в реальные проекты
Многие считают работу с SD-картой чем-то сложным и низкоуровневым. На практике, если использовать SDIO + FatFS, большая часть сложности уже спрятана библиотеками и аппаратными модулями микроконтроллера.
Оригиналы:STM32: Работа с SD-картами через SDIO
Программные границы — главный навык разработчика
Разработка и архитектура · ByteByteGo · 7/10
Материал рассматривает концепцию программных границ (software boundaries) как ключевого навыка проектирования систем. Хорошая граница в коде держит вместе ответственности приложения, его правила и детали их реализации, позволяя внешним компонентам взаимодействовать с внутренней логикой только через чётко определённые интерфейсы. Автор подчёркивает, что решение о том, как разделить систему на компоненты, требует понимания того, какие ответственности должны быть сгруппированы вместе, и какие зависимости должны существовать между ними. Статья обещает рассмотреть стратегии, которые помогут разработчикам принимать правильные решения по проектированию границ в системах, над которыми они работают. Опыт — лучший учитель в этом деле, но существуют и определённые принципы, которые можно применять.
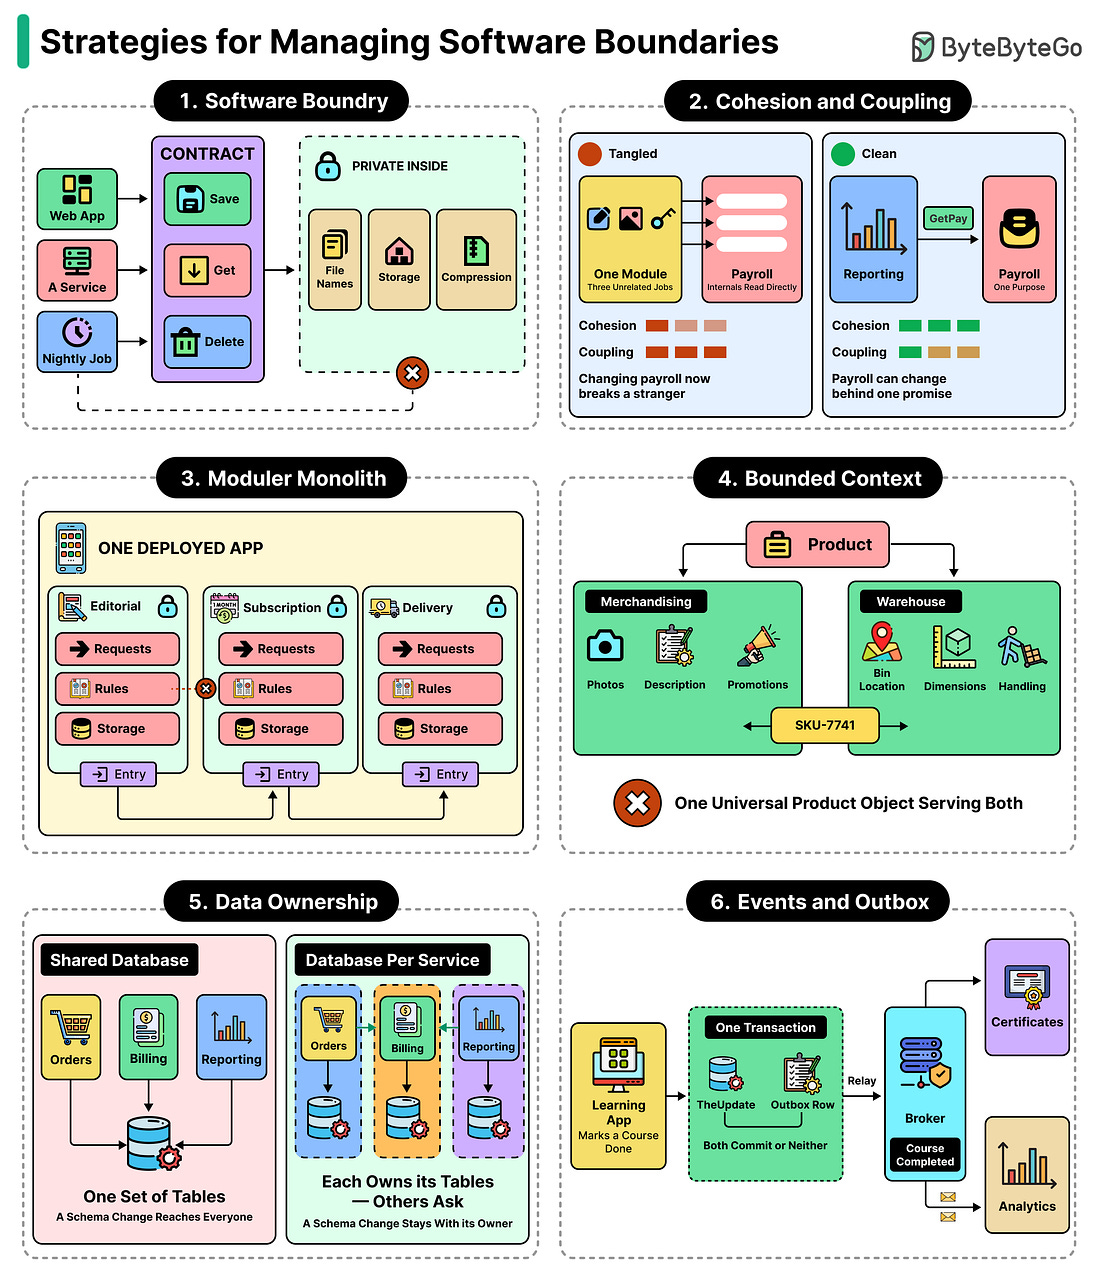
Выводы автора:
- Хорошая программная граница группирует ответственности, правила и детали их применения, позволяя контролировать зависимости между компонентами
- Умение определять границы требует навыка выбора того, какие ответственности должны быть вместе, а какие независимы
Части системы вне границы могут общаться с компонентами внутри только через ясно определённый путь взаимодействия.
Оригиналы:How Software Boundaries Are The Most Important Skill for Developers
Два покупателя датапродукта: уверенность для ИИ-агентов
Данные и аналитика · Modern Data 101 | Expert's Desk · 8/10
Статья рассматривает парадигму, при которой датапродукты теперь служат двум принципиально разным категориям потребителей: человеческим аналитикам и ИИ-агентам. Если аналитик может задать уточняющий вопрос при неясности данных, то агент действует на основе полученной информации немедленно и безвозвратно. По данным Modern Data Report 2026, 68% практиков считают свои данные недостаточно надёжными для ИИ, а 87% уверены, что более качественные и надежные данные улучшили бы скорость принятия решений.
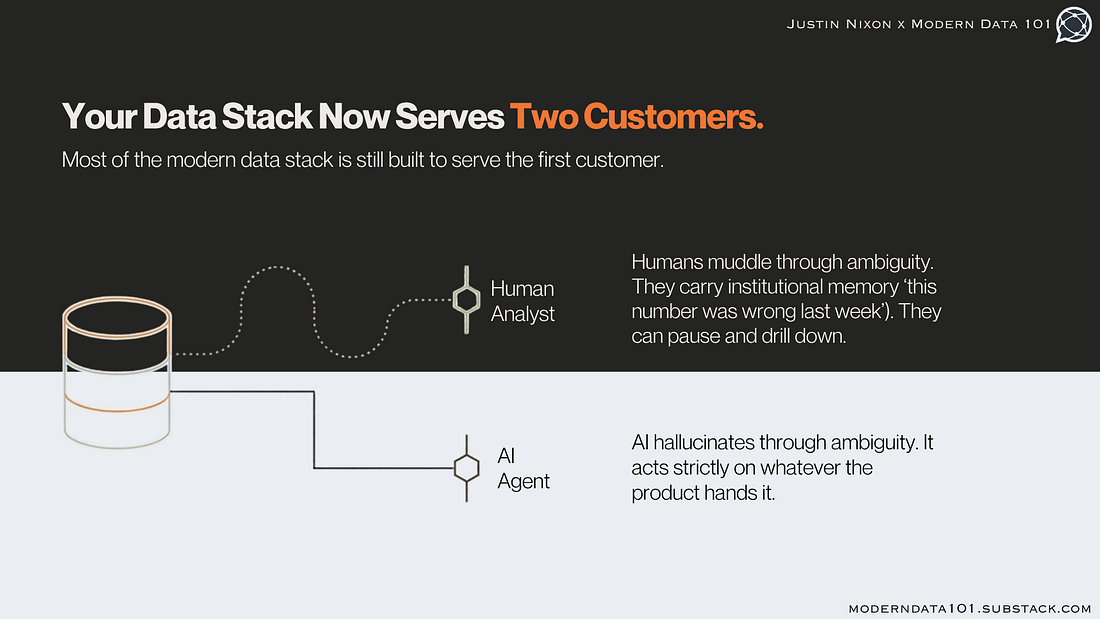
Автор утверждает, что контекст — это только половина решения. Вторая половина — это уверенность (confidence), которая не может быть просто метаданными или описанием, а должна быть предсказанием, валидируемым против реальных исходов.
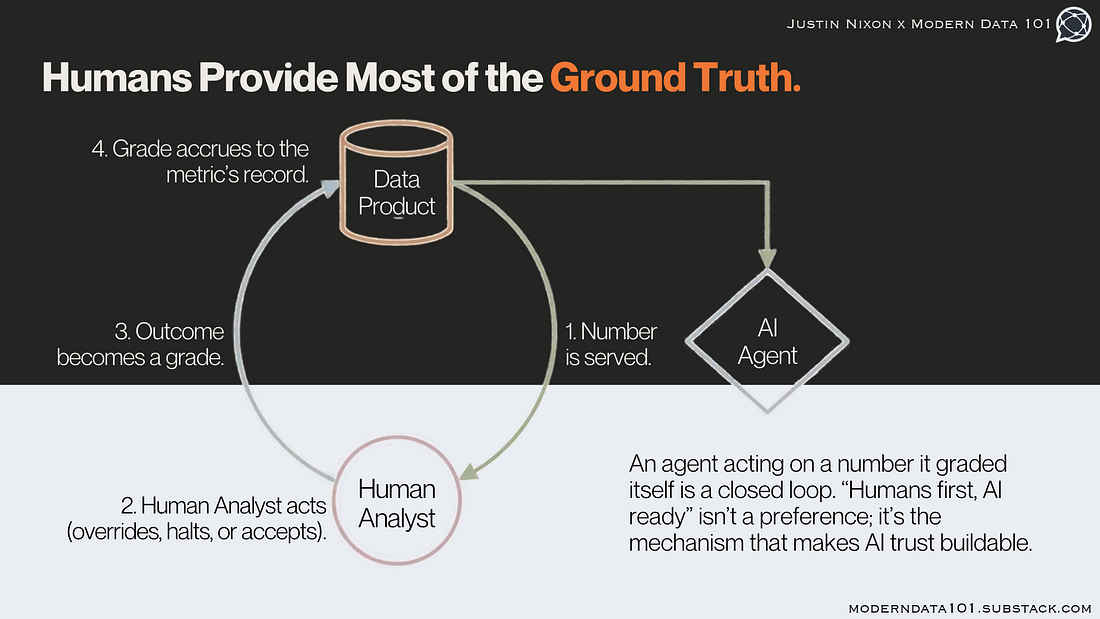
Уверенность должна основываться на истории действительных решений, которые принимали люди с опорой на данные.
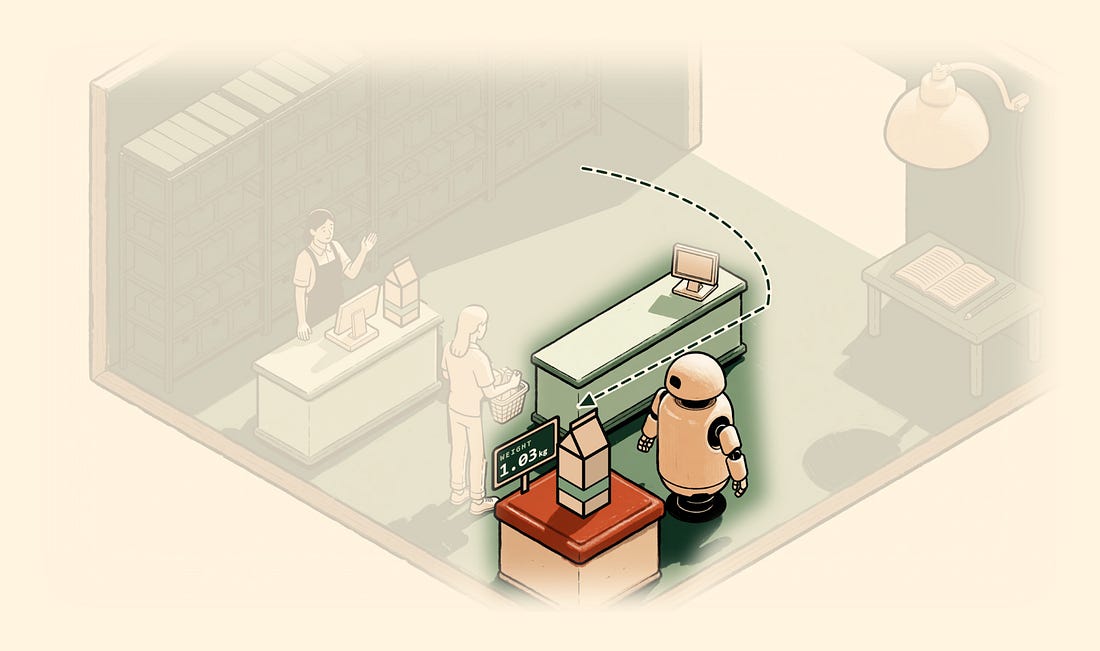
Когда ИИ-агент получает метрику, ему нужны три возможности: действовать (если уверенность высока), действовать с оговоркой (если средняя) или эскалировать человеку (если низкая).
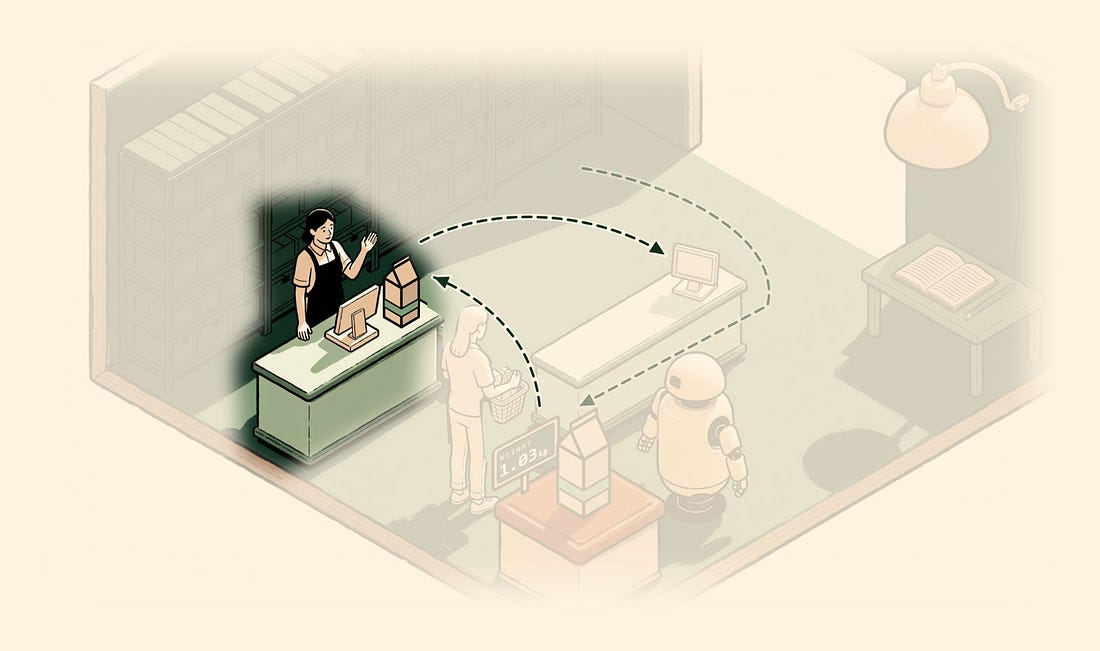
Система должна быть честной: если исторические данные, стоящие за оценкой уверенности, становятся редкими или устаревают, система должна автоматически «понижать» свою оценку до уровня, требующего одобрения человека. Это зеркалит работу самопроверочных касс в магазинах: когда ожидаемые веса расходятся с реальными, машина вызывает сотрудника вместо того, чтобы упорствовать.
Выводы автора:
- Датапродукты должны служить одновременно людям и ИИ-агентам, что требует встроить в данные не только контекст, но и оценку уверенности, валидируемую против реальных исходов действительных решений.
- Уверенность (confidence) — это не метаданные и не описание, а предсказание, которое должно быть оценено по результатам и составлять историческую запись честности, подобно весам в системе самопроверки.
- ИИ-агент должен иметь три режима взаимодействия с данными: действовать при высокой уверенности, действовать с оговоркой при средней, или эскалировать человеку при низкой, при этом система должна автоматически понижать оценки при недостатке исторических данных.
Ваш стек данных теперь служит двум категориям потребителей с несовместимыми потребностями. Люди справляются с неясностью. ИИ галлюцинирует сквозь неё.
Оригиналы:The Data Product's Second Customer: Why Context Is Only Half of What an AI Agent Needs · Data Products: The Essential Context for Enterprise AI
Хакеры получили поддельные TLS-сертификаты через взлом национальных доменов
Кибербезопасность · Habr · 8/10
Google выявила серию инцидентов, в которых злоумышленники взломали инфраструктуру национальных доменов верхнего уровня .gh (Гана), .sl (Сьерра-Леоне) и .as (Американское Самоа), а затем изменили DNS-записи и получили несанкционированные HTTPS-сертификаты для доменов Google и других крупных организаций. Атаки не связаны с компрометацией систем самой Google — уязвимость была на уровне регистратуров национальных доменов. Google заблокировала поддельные сертификаты в браузере Chrome через механизм CRLSets и взаимодействовала с центрами сертификации для их отзыва. Анализ журналов Certificate Transparency выявил, что от атак пострадали и другие ведущие мировые бренды, но их сертификаты также были превентивно заблокированы. Владельцам доменов рекомендуется постоянно мониторить Certificate Transparency логи, публиковать ограничительные DNS-записи типа CAA и периодически проверять неожиданный выпуск сертификатов. Google планирует улучшать экосистему HTTPS через сокращение сроков действия сертификатов и ограничение переиспользования результатов проверки контроля над доменом.
Выводы автора:
- Взлом инфраструктуры национальных доменов позволил хакерам выпустить поддельные TLS-сертификаты для Google и других организаций без компрометации их собственных систем.
- Ограничительные записи CAA являются важной защитой от подобных атак, однако они неэффективны при активном перехвате DNS и работают после восстановления контроля.
- Постоянный мониторинг журналов Certificate Transparency позволяет практически мгновенно выявлять несанкционированный выпуск сертификатов.
Записи DNS типа CAA позволяют владельцам доменов указывать, каким центрам сертификации разрешено выпускать сертификаты для их доменов.
Оригиналы:Хакеры научились получать поддельные сертификаты TLS для Google и других крупных сервисов
Сравнение алгоритмов для взлома биткойн-головоломок с известным ключом
Кибербезопасность · Habr · 7/10
Статья тестирует программы для решения биткойн-головоломок, когда публичный ключ известен. Основное внимание уделено двум подходам: алгоритму Кенгуру Полларда (Pollard's kangaroo) с квадратичной сложностью K·√N и методу Baby-Step Giant-Step (встречи посередине), требующему огромного объёма памяти. На практике Кенгуру показывает преимущество в сотни тысяч раз для больших диапазонов благодаря независимости от RAM. Тестирование проводилось на CPU (AMD EPYC, диапазон 2^60) и GPU (NVIDIA CMP 90HX, диапазон 2^66) с участием 8 программ. На CPU лучший результат — btcmole (5.04 сек в среднем), на GPU — btcmole (7.96 сек). Ключевой вывод: скорость в хешах, которую печатают программы, не отражает реальную эффективность алгоритма; важна математическая структура метода. Особо выделены турбо-ядра RetiredCoder на SASS-ассемблере, использующие кэш L2 видеокарт серий RTX 4090 и 5090 для достижения 19000+ Mkeys/s. На современных картах (RTX 5090, 5070 Ti, 4090) программа btcmole опережает RCKangaroo v4.0 примерно на 6–13%, что свидетельствует о собственных оптимизациях автора btcmole.
Выводы автора:
- Алгоритм Кенгуру Полларда имеет квадратичную эффективность и практически независим от размера оперативной памяти, благодаря чему обгоняет Baby-Step Giant-Step в сотни тысяч раз на больших диапазонах поиска.
- Сравнивать скорости программ по опубликованным хешрейтам некорректно: разные алгоритмы используют разные операции, поэтому реальное время решения может отличаться на порядки.
- btcmole показывает лучшую производительность за счёт собственных оптимизаций в дополнение к идеям RCKangaroo, включая оптимальное использование кэша и спец-ядер на современных видеокартах.
Несмотря на визуально скромные цифры хешрейта, алгоритм Полларда на реальных дистанциях оказывается несравнимо эффективнее BSGS.
Оригиналы:Тестируем программы для вскрытия биткойн-головоломок с известным публичным ключом · Криптография
Meta и Sierra открывают борьбу за контроль над платежами ИИ-агентов
Финтех и финансы · Linas from Linas's Newsletter · 8/10
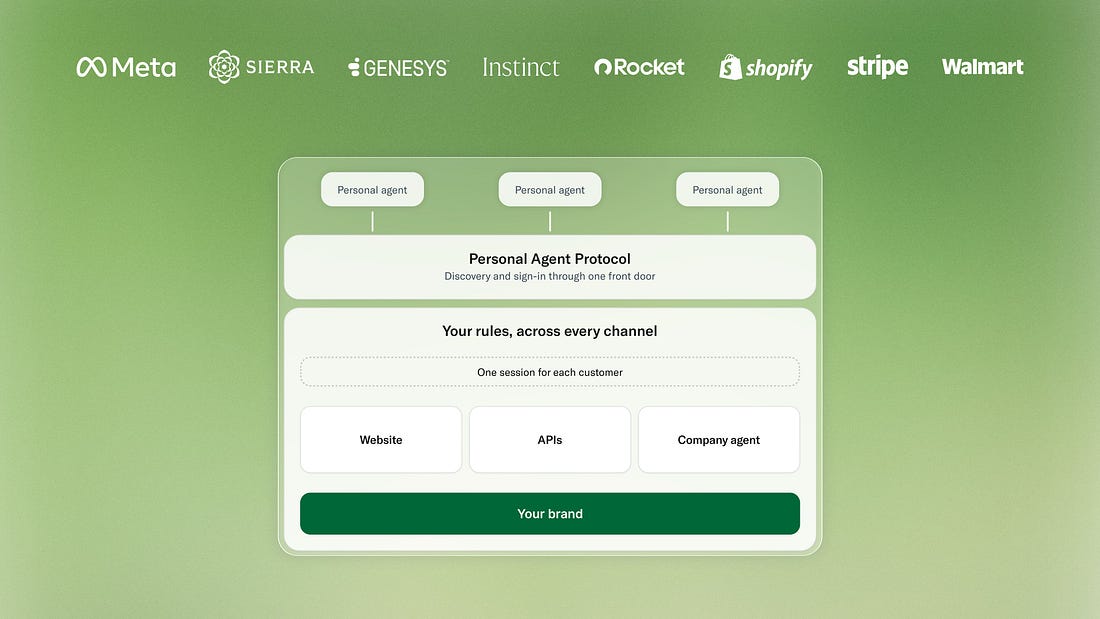
Материал анализирует запуск Meta и Sierra протокола Personal Agent Protocol (PAP), который передаёт предприятиям контроль над верификацией ИИ-агентов потребителей в платёжных системах. Ключевое отличие PAP от конкурирующих решений Visa (Trusted Agent Protocol) и Google (Universal Commerce Protocol) заключается в том, что бизнес, а не сетевые платежные системы или ИИ-платформы, становится тем, кто подтверждает личность агента. Это решающее — потому что верификатор контролирует данные клиента, ответственность и взимаемые комиссии в экосистеме агентических платежей. PAP поддержан Stripe, Shopify и Walmart. Главное сражение будет вестись вокруг ещё не написанного положения о платежах, которое определит, кому принадлежит контроль над учётными данными агента: платёжным платформам (Stripe, Shopify) или сетевым картам (Visa, Mastercard). Материал также затрагивает решение Маска интегрировать Claude в Grok Bot, что свидетельствует о переходе гонки ИИ от моделей к агентам.
Выводы автора:
- Протокол PAP передаёт контроль над верификацией и монетизацией ИИ-агентов платёжных потокам бизнесу, а не платёжным сетям или производителям моделей.
- Главный спор в индустрии — это критическое положение о платежах, которое определит финальную архитектуру контроля в агентических коммерческих системах.
- Гонка в ИИ перемещается с соревнования моделей на соревнование агентов и платёжных протоколов.
Кто удостоверяет агента, контролирует данные клиента, ответственность и комиссии в агентических платежах.
Оригиналы:Trusted Agent Protocol Visa · Universal Commerce Protocol Google · Claude Commerce Agents от Anthropic
Криптобанки: модели регулирования и доступ для россиян
Финтех и финансы · Б.О: Технологии · 8/10
Материал рассматривает глобальный тренд встраивания криптовалютных сервисов в традиционную банковскую систему через различные модели криптобанкинга. В мире сложилось около десяти различных подходов: от швейцарской модели с полноценной банковской лицензией (Sygnum управляет $6 млрд активов, AMINA — 4,2 млрд швейцарских франков) до европейского регулирования MiCA с категорией CASP, американской модели специализированных институциональных банков (Anchorage Digital получила федеральную лицензию в 2021 году), сингапурской платежной лицензии и гонконгской интеграции в существующую систему. Криптобанки предоставляют девять основных услуг: хранение цифровых активов, покупку-продажу крипто, обмен на фиат (fiat on/off-ramp), кредитование под залог криптовалюты, стейкинг, управление инвестициями, токенизацию реальных активов, международные расчеты через стейблкоины и инфраструктуру для традиционных банков. Для россиян доступ существенно ограничен санкциями: основные сервисы сосредоточены в странах СНГ (Казахстан, Армения) и на Ближнем Востоке (Дубай, Стамбул). Доступны криптокарты (Bybit Card, Gate Card), зарубежные карты с пополнением через крипто из соседних стран и кредитование под залог, но многие платформы (Crypto.com, Nexo, Binance) для граждан России без ВНЖ фактически заблокированы.
Выводы автора:
- Криптобанкинг интегрируется в традиционную финсистему через различные юридические модели — от полноценных банков с лицензией до платежных провайдеров и CASP, в зависимости от страны.
- Российские пользователи получают доступ к криптобанковским услугам в основном через соседние юрисдикции (Казахстан, Армения) и региональные хабы (Дубай, Стамбул, Бангкок) из-за западных санкций.
Криптобанк — это финансовая организация, которая работает с цифровыми активами примерно так же, как обычный банк работает с деньгами и ценными бумагами: хранит активы клиентов, проводит операции, дает кредиты и помогает инвестировать.
Денежно-климатическая политика: схема действий центробанков при стихийных бедствиях
Экономика · РЭШ · 8/10
Статья разбирает, как центробанки должны реагировать на растущую частоту климатических шоков и стихийных бедствий. Традиционная теория советует игнорировать временные шоки предложения, но повторяющиеся климатические события создают устойчивый рост волатильности инфляции и снижение ВВП. Авторы (экономисты из Банка Англии и Центробанка Норвегии) выделяют два канала влияния: физические последствия (нарушение цепочек поставок, рост неопределённости) и государственные ответные меры (углеродные налоги, зелёные субсидии), которые перераспределяют ресурсы между секторами экономики.
Ключевой вывод: масштаб последствий зависит не только от самого события, но и от предсказуемости и коммуникации государственной политики — упорядоченный переход к углеродной нейтральности с понятными сигналами минимизирует инфляционные эффекты. Авторы предлагают пятиэтапный процесс: идентификация шока, оценка распространения, анализ дилеммы между инфляцией и производством, коммуникация решений и мониторинг последствий. Чёткая информирование о целях и параметрах политики помогает сформировать стабильные инфляционные ожидания и сохранить доверие к регулятору.
Выводы автора:
- Повторяющиеся климатические шоки накапливаются и требуют активного отклика центробанков, а не игнорирования как временных возмущений
- Упорядоченный и понятный переход к углеродной нейтральности с адекватной коммуникацией минимизирует краткосрочные инфляционные эффекты и поддерживает доверие к центробанку
- Центробанки должны использовать пятиэтапный процесс: выявление, анализ распространения, оценка компромиссов, определение политики и мониторинг
Повторяющиеся шоки могут ослабить бюджетный потенциал и устойчивость экономики, снижая ВВП и увеличивая волатильность инфляции
Оригиналы:Подробнее на GURU
Как начать карьеру в ИИ: рекомендованные книги и навыки
Продукт и карьера · Habr · 7/10
Статья руководителя компьютерной редакции издательства «БХВ» рассуждает о том, какие направления в области ИИ стоит изучать современным специалистам, чтобы не попасть в ловушку моды на конкретные инструменты. Автор предостерегает от зацикливания на знании отдельных API и продуктов (ChatGPT, LangChain и т.п.), которые быстро устаревают, и рекомендует сосредоточиться на фундаментальных понятиях: машинном обучении, работе с данными, архитектуре нейросетей, трансформерах, RAG, агентах и интеграции ИИ-систем с обычным ПО. Для обучения предлагается серия книг, начиная с практического введения в PyTorch (Лоуренс Морони), затем углубление в устройство LLM (Андрей Бурков), практическое применение языковых моделей (Джей Аламмар и Маартен Гроотендорст), разработку AI-приложений (Сухас Пай), построение агентных систем (Нуну Кампос и Майо Ошин) и генеративный ИИ за пределами текста (Педро Куэнка и соавторы). Автор подчёркивает, что профессионал должен понимать принципы, лежащие в основе технологий, а не просто учить конкретные команды, и что будущее ИИ включает не только чат-боты, но и компьютерное зрение, генерацию изображений, аудио и другие специализированные приложения.
Выводы автора:
- Учить нужно фундаментальные основы машинного обучения и архитектур нейросетей, а не конкретные API и фреймворки, которые быстро устаревают
- Типичная бизнес-задача внедрения ИИ требует серьёзной инженерии (RAG, embeddings, интеграция систем), а не просто навыков написания промптов
- Карьера в ИИ будет развиваться далеко за пределами чат-ботов — в компьютерном зрении, генерации мультимодальных данных и специализированных приложениях
Пока на вопросы «почему одна модель работает лучше другой» и «что происходит при дообучении» приходится отвечать «ну, наверное, нейросеть так решила», полноценного AI-специалиста не получится.
Оригиналы:Я б в ИИ-шечку пошёл, пусть меня научат · Профессиональная литература
Профессия финансиста: за что рынок готов премировать
Продукт и карьера · РЭШ · 7/10
Подкаст рассматривает современные требования рынка к профессии финансиста с трёх ракурсов: академического (РЭШ), финтеха (Revolut) и промышленности (СИБУР). Эксперты обсуждают, почему фундаментальное образование остаётся страховым полисом от карьерного тупика, а не просто скучной теорией. Одной из критически важных компетенций финансиста станет умение работать с ИИ и понимание его базовых концепций. Мягкие навыки — здоровый скептицизм и интеллектуальная смелость — нельзя научить на курсах, но они определяют успех в профессии. Финансист должен видеть смыслы, стоящие за цифрами, а не просто оперировать числами. Гибридные роли в финансах (например, казначейство в финтехе) требуют понимания различных риск-матриц. Реальная рутина в финтехе существенно отличается от традиционного разделения на фронтенд и бэкенд. Главный секрет карьерного роста — умение «продавать» свои результаты и коммуницировать с начальством.


Выводы автора:
- Фундаментальное образование в финансах — главный страховой полис от карьерного тупика, а работа с ИИ станет обязательной компетенцией в ближайшие 5-7 лет.
- Мягкие навыки (здоровый скептицизм, интеллектуальная смелость и коммуникативные умения) не менее важны, чем технические знания финансиста.
- Успешный финансист должен видеть смыслы, стоящие за цифрами, и уметь донести свои результаты до начальства, что отличает его от просто грамотного аналитика.
Блестящий финансист делает сложные вещи простыми, гениальный делает их просто надежными
Оригиналы:Профессия финансиста: за что рынок готов премировать
Спецэффекты в кино до компьютерной графики: техники Мельеса и Вертова
Прочее · Habr · 7/10
Материал рассказывает об истории и технических методах создания спецэффектов в кинематографе до эпохи компьютерной графики. Жорж Мельес и его коллеги освоили трюк остановки камеры с подменой объекта ещё в 1890-х годах, позволяя фокусникам исчезать и трансформироваться на экране. Техника каше (маски перед объективом) позволяла снимать двух персонажей, играемых одним актёром, в одном кадре, правда с неподвижной границей между ними. Бастер Китон в 1921 году воплотил девять своих копий в танце благодаря многократной экспозиции и человеческой точности оператора, который должен был вручную прокручивать плёнку с одинаковой скоростью. Дзига Вертов в фильме «Человек с киноаппаратом» (1929) продемонстрировал разнообразие возможностей: двойную экспозицию, разделение экрана, стоп-кадры, покадровую анимацию, даже саму кинокамеру, передвигаемую между кадрами. Дорисовка на стекле (glass shot) позволяла добавить в кадр недостающие архитектурные элементы без дорогостоящего строительства декораций, благодаря правильному расчёту фокусного расстояния, диафрагмы и расстояния до стекла. Все эти методы держались на технической точности, ручном приводе камер и мастерстве операторов, часто называемых «человеком-метрономом».
Выводы автора:
- Спецэффекты в кинематографе развивались задолго до компьютерной графики и включали остановку камеры, многократную экспозицию, маски, дорисовку на стекле и оптические принтеры, обеспечивая впечатляющие результаты при минимальной электронике.
- Точность и синхронизация были критичны: операторы должны были вручную перематывать плёнку и снимать на одной скорости, чтобы несколько проходов совпадали и создавали иллюзию нескольких персонажей или невозможных сцен.
- Дорисовка на стекле решала проблему дорогостоящих декораций путём нанесения рисунка на стекло перед камерой с правильным расчётом оптики, что позволяло добавлять архитектурные элементы без строительства полноценных сооружений.
Никакой электроники внутри неё, разумеется, не было: аппарат понемногу передвигали между экспозициями отдельных кадров. Обычная покадровая анимация, только анимировали не куклу, а настоящую кинокамеру.
Оригиналы:Спецэффекты в кино до появления компьютерной графики
Коротко
ИИ и агенты
- Claude Opus создал 3D-анимацию GPU Nvidia Blackwell прямо в браузере – Демонстрация возможностей Claude Opus 5.5: разработчик использовал модель для создания полноценной 3D-анимации архитектуры GPU Nvidia Blackwell, которая масштабируется от уровня се
Финтех и финансы
- Банк России пополнил Ломбардный список и признал новую платёжную систему – Совет директоров Банка России принял серию регуляторных решений, расширив финансовые инструменты, доступные для операций рефинансирования.
Экономика
- Климат и экономика: цена потепления против цены бездействия – РЭШ проводит просветительскую сессию 8 октября 2026 года, посвящённую экономическим последствиям изменения климата.
Продукт и карьера
- Как data-инженерам избежать ловушки ad-hoc запросов и расти – Материал рассказывает о распространённой проблеме специалистов в области данных: они часто становятся служба поддержки для других отделов, занимаясь исключительно ad-hoc запросами
Прочее
- В Германии запустили спецтариф на электричество для геймеров – Немецкая компания SWK Energie предложила специальный тариф meinGAMING для потребителей с высоким расходом электроэнергии, в первую очередь для владельцев мощных игровых ПК, стример