Дайджест за 5 октября 2026
ИТ-инфраструктура переживает революцию под давлением искусственного интеллекта, заставляя корпорации радикально переосмыслять архитектуру и массово мигрировать в облако. LLM-агенты стремительно становятся новой реальностью интернета, хотя их надёжность пока остаётся под вопросом — как и механизмы контроля доверия к памяти этих систем. Внутри этих трансформаций разворачиваются десятки конкретных вызовов: от оптимизации сложных A/B-тестов до борьбы лидеров данных с разобщённостью стратегии и фрагментированностью систем.
Главное
- Как трансформируется ИТ-инфраструктура под требования ИИ
- Инженерная тайна AMD: как архитектура R400/Crayola связала Xbox 360 и мобильные устройства
- Как музыкальный плеер определяет тональность трека: алгоритм Крумхансла
- Корпорации массово переводят ИТ-системы в облако и внешние дата-центры
- MDL: контроллер доверия к памяти LLM-агентов — дешево, но ненадёжно
Подробно
MDL: контроллер доверия к памяти LLM-агентов — дешево, но ненадёжно
ИИ и агенты · Habr · 8/10
Статья разбирает архитектуру Memory Decision Layer (MDL) — подхода для уменьшения галлюцинаций в LLM-агентах при работе с внешней памятью (RAG). Проблема: классический RAG не различает надежные и ненадежные источники в контексте; когда база содержит противоречивую информацию, модель генерирует вымысел в 53% случаев. MDL вдохновлена нейробиологией — работой с префронтальной корой макак — и использует три независимых сигнала: релевантность документа (косинусное сходство), надежность (проверка противоречий через детектор лексики) и риск задачи (коэффициент для медицины, права, финансов). Сигналы не складываются, а раскладываются в ортогональные подпространства через QR-декомпозицию, чтобы один не маскировал другой. Решение принимается за ~40 микросекунд на геометрических правилах. Результаты показывают компромисс: на конфликтных данных MDL снижает галлюцинации до 23,3%, но на сильных моделях (DeepSeek) выигрыш теряется в статистическом шуме. На высокорисковых запросах контроллер ошибается в 8% одобренных им ответов. Критичная проблема: при одновременно высокой релевантности и высоком риске точность падает до 55,6% — хуже подбрасывания монеты. Обучаемые модели (логрегрессия, градбустинг) на тех же сигналах показывают 63-64%, но требуют разметки. Главное преимущество MDL — скорость (в 50 раз быстрее поиска), что делает её скорее подстраховкой существующей RAG, чем решением фундаментальной проблемы.
Выводы автора:
- MDL снижает риск галлюцинаций в RAG-системах, но не устраняет его полностью и уступает простым обучаемым моделям по точности.
- Подход хорошо работает на слабых базовых моделях и на однозначно-рисковых запросах, но дает сбой когда документ одновременно релевантен и опасен.
- Основной практический выигрыш MDL в скорости (0,14 мс на решение), что позволяет использовать его как быструю проверку перед критичными ответами.
На высокочувствительных запросах контроллер не ошибается совсем, но там, где одновременно высокий риск и высокая релевантность, точность падает до 55,6% — немногим выше подбрасывания монеты.
Оригиналы:Дешево, но не точно: разбираем контроллер доверия к памяти LLM-агентов · Машинное обучение
Глава ChatGPT о Dots: агенты будут доминировать в интернете
ИИ и агенты · Lenny's Newsletter · 8/10
Tibo Sottiaux, руководитель ChatGPT в OpenAI, обсуждает новую платформу персональных агентов Dots и будущее ИИ. Он считает, что большинство действий в интернете вскоре будут выполняться агентами, а не людьми напрямую. Sottiaux поделился инсайтами о том, почему Dots – главная ставка OpenAI, и развеял миф о том, что для работы агентов критичны сложные рабочие процессы с циклами и графами. Он также обсудил, какие навыки растут или снижаются в эпоху ИИ, и рассказал о случае, когда его собственный Dot предупредил команду о сбое в production за пять минут до запуска. В разговоре затронуты подход OpenAI к безопасности ИИ и трансформация рынка под влиянием агентов.
Выводы автора:
- Агенты скоро будут выполнять большинство действий пользователей в интернете, что коренным образом изменит способ взаимодействия с цифровыми сервисами
- Сложные рабочие процессы с циклами и графами для обучения агентов – лишь временный этап, который будет вытеснен более простыми подходами
Мы входим в новую эпоху ИИ – это происходит снова
NVIDIA представила AI-компьютер DGX Spark за $4999
ИИ и агенты · Habr · 7/10
NVIDIA анонсировала настольный AI-компьютер DGX Spark 64GB с ценой от $4999, поступление в продажу – 23 октября через партнёров (Acer, ASUS, Dell, HP, MSI и других). Устройство получило чип GB10 Grace Blackwell и объединённую память ёмкостью 64 ГБ, доступную как процессору, так и GPU, что позволяет запускать локально модели размером до 100 млрд параметров без копирования данных между ОП и видеопамятью. Из коробки поддерживаются PyTorch, Ollama, vLLM, llama.cpp и другие фреймворки; компьютер предназначен для инференса, дообучения и работы локальных агентов. Два устройства можно объединить через ConnectX-7 в кластер со 128 ГБ памяти, способный запускать модели до 200 млрд параметров; при тестировании с Qwen 3.8 27B два компьютера работали до 1,7 раза быстрее одного. Критическое замечание: оригинальный DGX Spark со 128 ГБ стоил $4699, поэтому новая версия с вдвое меньшей памятью дороже на $300 минимум, что снижает её привлекательность с точки зрения ценности, хотя доступность в продаже может стать главным аргументом покупки.
Выводы автора:
- DGX Spark 64GB с объединённой памятью позволяет локально запускать модели до 100 млрд параметров, что практически полезно для развёртывания AI-агентов без облачных зависимостей.
- Два устройства можно кластеризировать для работы с моделями до 200 млрд параметров, хотя прирост производительности (1,7x) ниже теоретического максимума.
- Цена $4999 за 64 ГБ памяти менее конкурентна, чем оригинальная модель со 128 ГБ за $4699, что затрудняет позиционирование как доступного решения.
Один компьютер сможет локально запускать модели размером до 100 млрд параметров. Конкретный предел зависит от архитектуры модели, длины контекста и формата весов.
Оригиналы:NVIDIA представила AI-компьютер за $4999
Как трансформируется ИТ-инфраструктура под требования ИИ
Разработка и архитектура · Habr · 9/10
Статья описывает фундаментальные изменения в архитектуре ЦОДов и ИТ-инфраструктуры при массовом внедрении ИИ-систем. Меняются целевые метрики оценки — вместо FLOPS и пиковой производительности приоритетом становятся tokens/s, time-to-first-token и tokens/W. На рынке процессоров наряду с доминирующей Nvidia появляются конкурирующие архитектуры: китайские Huawei Ascend, Cambricon MLU, собственные ускорители Amazon (Trainium, Inferentia), Google TPU, Microsoft Maia, Meta MTIA и инновационные решения вроде Cerebras. Возникает новая многоуровневая иерархия памяти и интерконнектов (UCIe, HBM, PCIe 6.0/7.0, CXL, NVLink-C2C, AMD Infinity Fabric, InfiniBand, Ultra Ethernet), граница между памятью и сетью размывается. Современные ЦОДы переходят от модели "россыпи commodity компонентов" к тщательно спроектированным программно-аппаратным комплексам (ПАКам). С распространением reasoning-моделей и ИИ-агентов основной вычислительной нагрузкой становится массовый inference, а не обучение. Мощность ИИ-стойки превышает 100 кВт, требуется жидкостное direct-to-chip cooling и новая схема питания 800 VDC. География ЦОДов определяется доступной электрической мощностью, развиваются подводные и космические варианты (хотя космос требует 5,6 тыс. м² солнечных батарей на мегаватт), реалистичнее ЦОДы рядом с ГЭС и ядерными реакторами. Резко растут требования к данным — необходимо хранить обучающие корпуса, векторные представления, истории запросов, телеметрию ИИ-агентов. Появляются специализированные планировщики и системы управления распределённым выполнением ИИ-нагрузок. В результате ЦОД превращается из набора независимых серверов в единый огромный распределённый компьютер.
Выводы автора:
- Метрики оценки инфраструктуры кардинально меняются: вместо FLOPS и пиковой производительности ключевыми становятся токены в секунду, задержка первого токена и энергоэффективность на токен.
- Инференс (повседневное использование обученных моделей) и ИИ-агенты становятся основными потребителями вычислительных ресурсов ЦОДов, вытесняя обучение модели.
- ЦОД превращается из коллекции независимых серверов в единый распределённый компьютер, требующий новых подходов к архитектуре памяти, сети, энергопитанию и управлению.
ИИ превращает ЦОД из помещения с большим количеством относительно независимых серверов в один огромный распределенный компьютер.
Оригиналы:Что и как меняется в ИТ-инфраструктуре при внедрении ИИ?
Инженерная тайна AMD: как архитектура R400/Crayola связала Xbox 360 и мобильные устройства
Разработка и архитектура · Habr · 8/10
Статья раскрывает удивительную связь между разными устройствами нулевых годов через общую архитектуру графических чипов AMD. Автор проходит путь развития видеокарт от ATI — от простых адаптеров Wonder и GUI-акселераторов через первые 3D-видеокарты (3D Rage) до того момента, когда Nvidia доминировала рынок благодаря технологиям T&L и кубмапам. В 2000 году ATI с линейкой Radeon и архитектурой R100 наконец-то приблизилась к конкурентам, и далее развивала серии R200, R300, R350. Ключевой точкой стала разработка в 2005 году совершенно новой архитектуры R400 (кодовое имя Crayola) с унифицированными шейдерами и VLIW5-моделью, предназначавшейся для поддержки DirectX 10/11. Хотя на ПК R400 Crayola не вышла (вместо этого появилась R500), именно эта архитектура легла в основу GPU Xenos для Xbox 360. Параллельно подразделение Imageon разрабатывало мобильные видеочипы, и в них тоже использовались наследники Crayola — сначала Z430 (мини-Xenos), потом Qualcomm лицензировал его как Adreno 200/205 для бюджетных смартфонов (Sony Ericsson Xperia Play, LG Optimus L2), а HTC коммуникаторы (HTC HD2) работали на Adreno 130, восходящем к Imageon 2300. Таким образом, унификация микроархитектуры под все платформы привела к тому, что совершенно разные устройства использовали одни и те же графические основы — от консоли до телефонов.
Выводы автора:
- AMD/ATI разработала унифицированную архитектуру Crayola (R400) с одинаковыми унифицированными шейдерами для всех устройств: ПК, консолей и мобильных телефонов.
- Эта же архитектура лежит в основе GPU Xenos для Xbox 360 и мобильных видеочипов Z430/Adreno 200, что объединяет десятки устройств разных типов одной технологией.
- AMD продала Imageon компании Qualcomm в 2009 году, которая переименовала Z430 в Adreno и продолжала использовать эту архитектуру в мобильных чипсетах вплоть до 2013 года.
Мы же с вами помним про то, что основное подразделение ATI разрабатывало новую микроархитектуру R400 с унифицированными шейдерами и именно она легла в основу GPU Xenos в Xbox 360? Так вот: в задачах ATI была унификация этой микроархитектуры под все у
Оригиналы:Инженерная тайна AMD из нулевых: архитектура Crayola
Как музыкальный плеер определяет тональность трека: алгоритм Крумхансла
Разработка и архитектура · Habr · 8/10
Статья разбирает алгоритм определения тональности трека в музыкальном плеере Nami. Программа не анализирует гармонию как музыкант, а считает энергию каждой из 12 нот в диапазоне 80–5000 Гц (хромаграмма), затем сравнивает результат с 24 эталонными профилями мажорных и минорных тональностей Крумхансла-Кесслера, используя коэффициент корреляции Пирсона.
Тональность с наибольшей корреляцией считается ответом. Алгоритм реализован примерно 110 строками на Rust без внешних библиотек и работает на сервере и мобильных устройствах. Основные источники ошибок: параллельные и родственные тональности имеют одинаковый набор нот, модуляции внутри трека усредняются в хромаграмме, профили не учитывают экспериментальные лады и хроматику, ударные и обертоны добавляют шум.
Несмотря на развитие нейросетей, автор оставил классический метод за его простоту, независимость от модельных данных и адекватность для подбора треков в микс.
Выводы автора:
- Тональность от программы — это ответ на вопрос, на какую мажорную или минорную гамму больше всего похож набор звучащих нот, а не истинный музыкальный анализ.
- Коэффициент корреляции (0,85 — уверенный ответ, 0,3 — неясная тональность) информативнее названия, так как честно отражает неопределённость.
- Самые частые ошибки — определение соседней квинтовой тональности и родственной тональности, что ожидается даже в конкурсе MIREX.
Тональность от программы — ответ на вопрос «на какую мажорную или минорную гамму больше всего похож набор нот», а не музыкальный анализ.
Оригиналы:Как плеер угадывает тональность трека: 12 чисел и одна корреляция
Корпорации массово переводят ИТ-системы в облако и внешние дата-центры
Разработка и архитектура · Habr · 8/10
Исследование Uptime Institute показывает, что в 2026 году впервые в истории большинство корпоративных нагрузок размещается не в собственных дата-центрах, а у внешних провайдеров: 46% против 44% в собственных ЦОД. Этот переход вызван несколькими факторами: растущей плотностью стоек (средняя превысила 11 кВт, а для ИИ-инфраструктуры доходит до 30+ кВт), сокращением циклов обновления оборудования из-за быстрого развития моделей ИИ, дефицитом электроэнергии и квалифицированных кадров. Серверы с современными ускорителями (например, восемь NVIDIA B300 потребляют 56 кВт в стойке) требуют масштабного переоснащения инженерной инфраструктуры. К 2028 году прогнозируется, что доля внешних площадок вырастет до 48%, так как компании всё чаще предпочитают арендовать актуальное железо, чем нести риски управления собственными ЦОД. Одновременно стоимость сбоев растёт: 71% опрошенных сообщили о крупных сбоях, обошедшихся минимум в 100 тыс. долларов.
Выводы автора:
- Внешние облачные площадки впервые превзошли собственные дата-центры по доле размещаемых корпоративных нагрузок, и тренд будет усиливаться к 2028 году.
- Растущая плотность и требовательность ИИ-инфраструктуры к электроэнергии (30+ кВт на стойку), дефицит электроэнергии и кадров делают собственные ЦОД экономически неоправданными для большинства компаний.
- Цикл обновления оборудования сокращается: серверы, купленные для инференса ИИ в начале года, часто морально устаревают уже через год из-за выхода новых моделей, поэтому аренда актуального железа экономически выгоднее владения.
Аренда не обязательно дешевле владения железом, но она дешевле владения рисками, которые появляются вокруг железа.
Оригиналы:Большинство корпоративных ИТ-систем впервые размещается за пределами собственных дата-центров
Оптимизация A/B-тестов с множественными метриками: метод перераспределения альфы
Данные и аналитика · Habr · 8/10
Статья описывает метод оптимизации A/B-тестов при наличии нескольких целевых метрик, разработанный в лаборатории прикладной статистики Т-Банка. Классический подход поправки Бонферрони делит уровень значимости поровну между метриками, что приводит к увеличению требуемого размера выборки — часто одна метрика с высокой дисперсией определяет длительность всего теста. Авторы предлагают не делить уровень значимости поровну, а перераспределять его оптимально между метриками, сохраняя при этом контроль вероятности ложноположительного результата (FWER). Ключевая идея: в оптимуме размеры выборок по метрикам должны выровняться, что минимизирует максимальный размер выборки.
На реальных тестах с двумя метриками метод сократил размер выборки в среднем в 1.2 раза (в примере с выручкой и CR покупки — с 872k до 720k пользователей). В синтетических сценариях с большим числом метрик выигрыш достигает 1.6–1.9x. Метод практически применим: на этапе дизайна задаются параметры метрик (MDE, дисперсия, тип альтернативы), выбирается общий уровень значимости, затем алгоритм распределяет его оптимально. После эксперимента p-value каждой метрики сравнивается с соответствующим индивидуальным уровнем значимости, определённым на этапе дизайна.
Выводы автора:
- Перераспределение уровня значимости между метриками вместо равного деления сокращает требуемый размер выборки без изменения общего контроля ошибки первого рода
- Наибольший выигрыш метод дает при сильном различии метрик по дисперсии, MDE и требуемому размеру выборки; если метрики похожи, обычная поправка Бонферрони уже близка к оптимуму
- Метод не заменяет содержательный выбор целевых метрик — добавлять метрики только для ускорения теста неправильно
Размазывание поправки — бесплатное ускорение A/B-теста. Мы не меняем общий уровень значимости, не ломаем контроль FWER, а просто умнее распределяем тот же самый бюджет ошибки между метриками.
Оригиналы:Как мы перераспределили альфу в A/B-тестах и сократили размер выборки
Пять забот лидеров данных: от слабого бренда до стратегической разобщённости
Данные и аналитика · Dylan Anderson from The Data & AI Ecosystem · 8/10
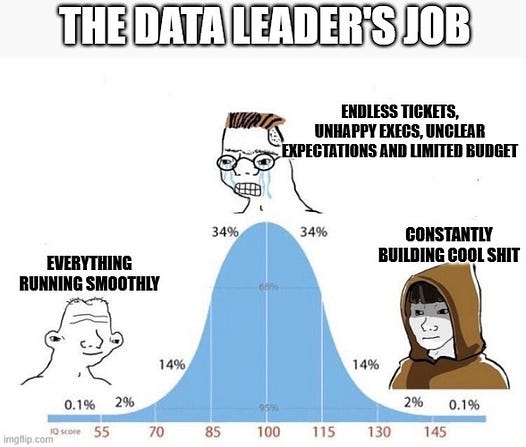
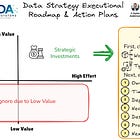
Серия интервью с 25 лидерами данных по всему миру раскрывает систематические проблемы, которые беспокоят руководителей данных и AI. Автор Dylan Anderson выявил, что роль лидера данных изначально невыполнима: от них требуют овладеть 5-10 техническими навыками, быть экспертом в менеджменте и стратегии, при этом часто не имея чёткого описания должности или поддержки от руководства. Главная беспокойство – слабый бренд функции данных внутри организации: команды рассматриваются одновременно как софтверные, консультационные и финансовые подразделения. Второе беспокойство касается слабых фундаментов: плохого качества данных, ненадёжных пайплайнов, отсутствия понятного владения датасетами и уязвимостей безопасности, которые часто не финансируются бизнесом. Третье и наиболее критичное – расхождение между стратегией данных и общей бизнес-стратегией, приводящее к силосам, отсутствию единого источника истины и неправильной интерпретации данных. Лидеры подчёркивают, что без связи фундаментальной работы с конкретными бизнес-результатами её невозможно профинансировать, а успех требует активного построения репутации команды через презентации и демонстрацию ценности.
Выводы автора:
- Роль лидера данных структурно невыполнима: ожидания руководства не согласованы с реальным объёмом работы и влиянием, которое может иметь функция данных.
- Слабый бренд и видимость данных внутри организации – главный источник проблем; его нужно активно строить через презентации, внутренние мероприятия и демонстрацию ценности.
- Отсутствие стратегического выравнивания данных с бизнес-целями приводит к силосам, плохому качеству данных и невозможности создать единый источник истины.
Роль CDO неясна в каждой организации. Она имеет разный объём полномочий и разные руководители на разных уровнях.
Оригиналы:Dylan Anderson – The Data & AI Ecosystem · Полная версия выпуска Issue #72
Robinhood Q2 2026: 44% превышение EPS и $106M прибыли, которая испарилась
Финтех и финансы · Linas from Linas's Newsletter · 8/10
Robinhood отчитался о рекордном втором квартале 2026 года с выручкой $1,31 млрд (+32% год-к-году) и разбавленной прибылью на акцию $0,62, на 44-51% превысившей консенсус-прогноз $0,41-0,43. Достигнуты рекорды по чистым депозитам ($21,7 млрд), активам на платформе ($369 млрд) и подписчикам Gold (4,8 млн), однако акция упала на 3,15% в день публикации результатов и ещё на 2,69% следующим утром до $87,42. Ключевая проблема: $10,1 млрд из $21,7 млрд депозитов пришло только в июне, а темп июля составил примерно $4 млрд в месяц, что соответствует лишь 13% годовых темпов роста — самый медленный месяц года и медленнее любого квартала предыдущих двух лет. Вся рекордная производительность квартала сконцентрирована в одном месяце. Кроме того, $0,62 прибыли на акцию включали одноразовый $106M прибыль от венчурного фонда Robinhood (RVI), зарегистрированный в конце июня, но к моменту презентации результатов на конференц-звонке 29 июля вся прибыль уже испарилась из-за падения цены акций RVI.
Выводы автора:
- Рекордный квартал Robinhood построен на одном сильном месяце (июне), а темпы роста замедлились в июле до самого низкого уровня за год
- Существенная часть квартальной прибыли на акцию ($106M) была получена из одноразовой прибыли венчурного фонда, которая полностью развернулась к моменту публикации результатов
Рекордный квартал закончился в тот момент, когда квартал закончился
Оригиналы:Robinhood's Q2 2026: рассчитанный анализ финансов и падения акции
Как математик из Стэнфорда обнаружил уязвимость в казино через анализ тасования карт
Прочее · Habr · 7/10
Статья рассказывает о том, как Перси Диаконис — математик и бывший профессиональный фокусник из Стэнфорда — выявил критическую уязвимость в новой машине для тасования карт, разработанной для казино Лас-Вегаса. Компания-производитель утверждала, что один проход через устройство полностью перемешивает колоду, но Диаконис вместе со статистиком Сьюзен Холмс обнаружили, что в колоде сохраняются восходящие и нисходящие последовательности, позволяющие предсказать примерно 9–10 карт из колоды — почти каждую пятую. Этого достаточно, чтобы увеличить преимущество опытного счётчика карт в два-три раза. Диаконис известен тем, что доказал: для хорошего перемешивания обычной колоды необходимо примерно семь правильных тасовок типа riffle shuffle, после чего происходит резкий переход (cut-off phenomenon), и колода становится практически неотличимой от случайной. Он использовал математическую модель цепей Маркова для описания этого процесса. Исследования Диакониса показали, что случайность — это не просто отсутствие порядка, а система, которая может выглядеть хаотичной, но одновременно сохранять значительное количество информации о своём прошлом.
Выводы автора:
- Машина для тасования карт, казавшаяся защищённой, содержала математическую уязвимость: сохранение восходящих и нисходящих последовательностей позволяло предсказывать карты и увеличивать преимущество счётчика в 2–3 раза.
- Для полного перемешивания колоды необходимо примерно семь правильных тасовок; переход от порядка к случайности происходит резко, а не постепенно (эффект отсечения).
- Случайность — это не отсутствие порядка, а состояние, когда система может сохранять скрытую информацию о прошлом, которая иногда позволяет превратить кажущийся хаос в предсказуемую систему.
Думать — не значит жульничать. Думать — значит думать.
Оригиналы:Как фокусник-математик из Стэнфордского университета обнаружил лазейку в казино
Коротко
Разработка и архитектура
- Microsoft добавила символ тильды для быстрого доступа к профилю в Windows 11 – Microsoft внедрила в Windows 11 поддержку символа тильды (~) для сокращённого доступа к папке профиля пользователя, что уже давно используется в Unix-подобных системах, Linux и WSL
- DOS Navigator портирован на Free Pascal с поддержкой DOS и Linux – Разработчик Иван Сорокин выпустил порт классического файлового менеджера DOS Navigator (проекту исполнилось 35 лет) на современный язык Free Pascal.
Прочее
- Как поляки создавали письменность: история польского алфавита и орфографии – Статья рассказывает о развитии письменной польской орфографии, начиная с первых упоминаний польских слов в латинских документах XI века и заканчивая официальной стандартизацией в 1
- Скрытая опция Shift+клик в полосе прокрутки Windows – Рэймонд Чен из Microsoft поделился историей малоизвестного сочетания клавиш для полосы прокрутки Windows, существующего с времён Windows 2000.