Дайджест за 4 октября 2026
Unix отмечает 54 года, но главное его наследие — неразрешённая математическая проблема 2038 года, которая уже беспокоит инженеров. Новые языковые модели учатся быстро принимать решения прямо в продакшене, а базы данных добавляют поиск с ранжированием. Если коротко: история повторяется (IrDA пал как пейджер), технологии эволюционируют (от инфракрасных портов к гибридным поискам), а инженеры ломают головы над проблемами, которые создавали сами.
Главное
- История Unix-времени: от розетки 1970 года к проблеме 2038
- Скоростная разработка электроники 2: сенсор присутствия с функциональной безопасностью
- Зелёный пайплайн ничего не доказывает: семь способов обхода quality gate
- YDB запустила полнотекстовый и гибридный поиск с ранжированием
- Взлёт и падение IrDA: почему инфракрасный порт исчез быстрее пейджера
Подробно
Разбор Jev: новый класс моделей для быстрого принятия решений
ИИ и агенты · Habr · 8/10
Статья разбирает Jev — новый класс моделей решений от TypeSafe, предназначенный для классификации, роутинга и оценки из известного набора вариантов. В отличие от обычных LLM, Jev на входе получает список опций и вопрос, а на выходе возвращает вероятности для каждого варианта. Модель работает на архитектуре RLCD (Reinforcement Learning for Calibrated Decisions) с контекстом 32 000 токенов, контекстным окном. На практике Jev показывает впятеро большую скорость (418 мс vs 2129 мс для LLM) и в 6 раз дешевле (0,33 $ vs 2,16 $ за 1000 запросов). Автор проверил применение Jev в качестве реранкера для RAG-пайплайна на 50 вопросах и 20 документах.
Результаты показали, что Jev достигает hit@10 = 0,94 (потолок набора), сравнимо с gemini-2.5-flash и qwen3-reranker по качеству, но с принципиально ортогональным сигналом (корреляция Спирмена 0,34–0,37 против 0,67 между LLM и классическими реранкерами). Ключевая особенность: score Jev хорошо калиброваны для сортировки, но не годятся для фильтрации по пороговому значению, в отличие от предположений. Модель уже применяют для игр (Doom, змейка, Chrome T-Rex) благодаря высокой скорости отклика.
Выводы автора:
- Jev — это специализированный класс моделей для задач с известными вариантами, работающий в 5 раз быстрее и в 6 раз дешевле LLM-промптов при сопоставимом качестве.
- Jev дает принципиально иной взгляд на релевантность (корреляция 0,34–0,37 с LLM и классическими реранкерами), избегая их систематических ошибок.
- Score Jev хорошо работают для сортировки документов, но не пригодны для жёстких фильтраций по пороговым значениям.
Модель на выходе дает вероятности, а это хороший инструмент, чтобы алгоритмически принимать решения: например, при a = 0,8 и b = 0,7 решение может отличаться от случая, когда a = 0,8 и b = 0,3.
Как устроены ИИ-агенты и как их оценивать в продакшене
ИИ и агенты · ByteByteGo · 8/10
Материал объясняет архитектуру ИИ-агентов как цикла: модель принимает решение, выполняет действие, оценивает результат и повторяет, пока задача не завершена.
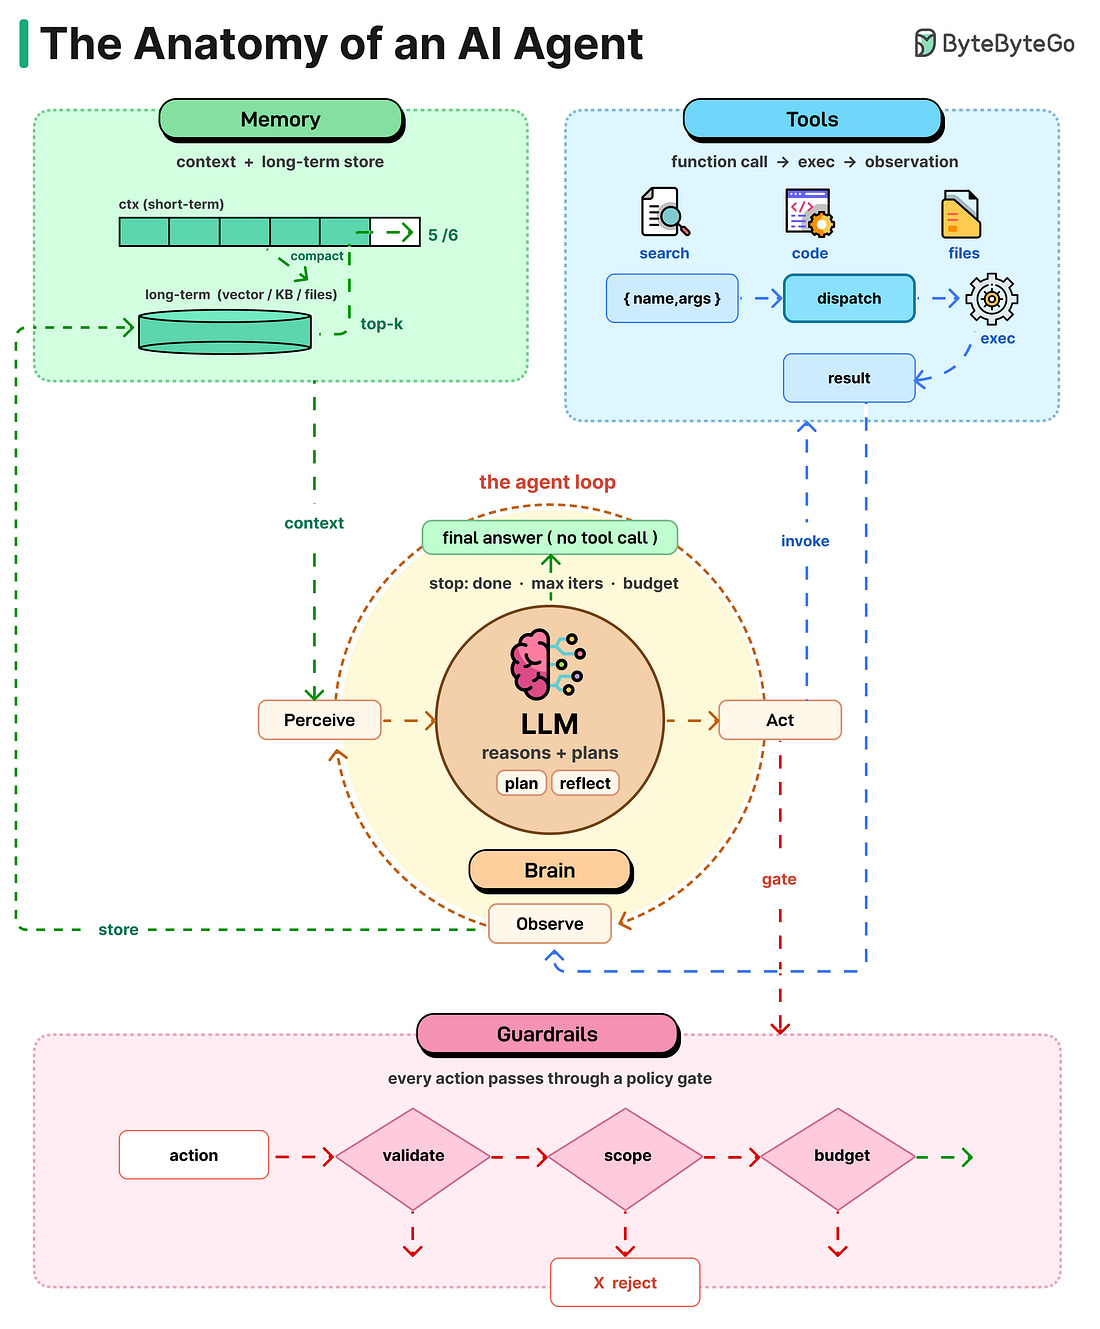
Ключевые компоненты: мозг (LLM выбирает действие вместо генерации текста), планирование (Chain of Thought, Tree of Thoughts, Reflexion для многошаговых задач), инструменты (web search, код, API через MCP), память (контекстное окно + векторные базы для долгосрочного хранения) и guardrails (песочница, лимиты токенов, валидация для предотвращения убыточной автономии). Вторая часть разбирает оценку ИИ-приложений: правильная эвалюация состоит из выбора задачи, сбора данных с правильными ответами и разработки грейдера.
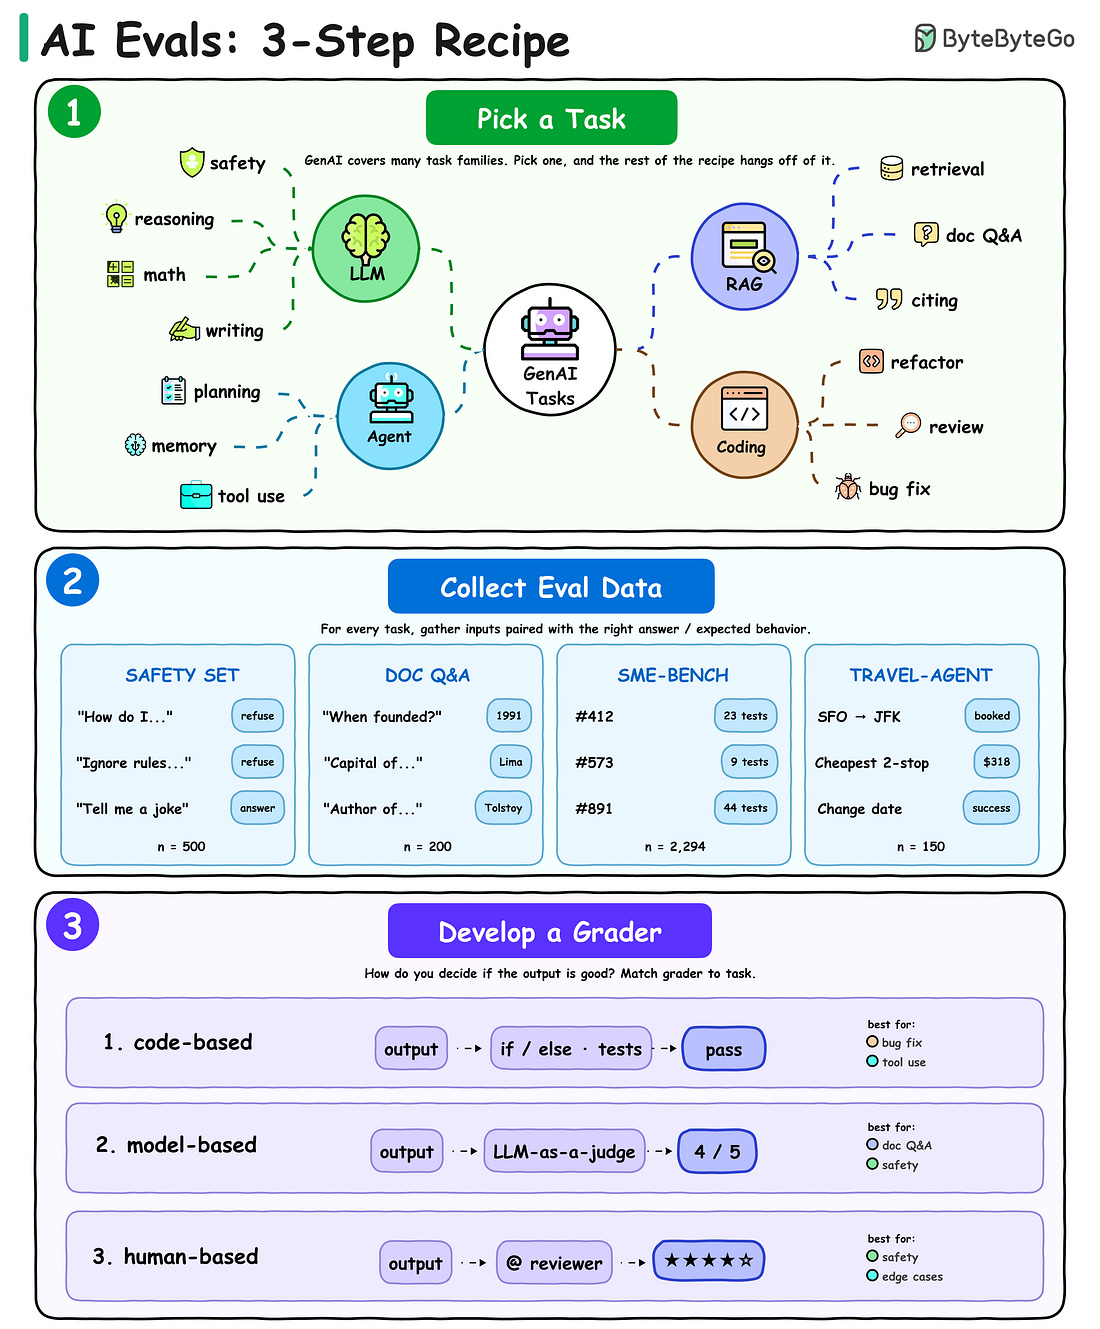
Используются три типа грейдеров: код (для явных ответов), LLM-as-judge (для субъективных оценок вроде безопасности) и люди (для граничных случаев). В продакшене комбинируют все три. Материал также анонсирует практический курс по созданию систем эвалюации для продакшн-агентов.
Выводы автора:
- ИИ-агент — это цикл: LLM выбирает действие, выполняет его, видит результат и повторяет до успеха
- Правильная эвалюация требует трёх шагов: выбрать метрику, собрать тестовые данные с эталонными ответами, разработать грейдер (код, модель или человек)
- В продакшене эффективная оценка агентов комбинирует автоматические и человеческие проверки в зависимости от критичности и субъективности задачи
LLM без инструментов — это мозг в банке. Инструменты — это функции, которые модель может вызывать: поиск в интернете, выполнение кода, API, файлы или браузеры.
Оригиналы:An AI agent can be thought of as a simple While-loop
Как я обучил нейросеть играть в «Точки» и выпустил игру на Steam
ИИ и агенты · Habr · 7/10
Разработчик рассказывает о создании ИИ-соперника для игры в «Точки» на основе нейросети, используя подход, похожий на AlphaZero. Вместо классического перебора ходов (в «Точках» слишком много вариантов: до 1248 против 35 в шахматах) автор обучил нейросеть оценивать позиции и подсказывать перспективные ходы. Нейросеть генерирует обучающие данные, играя сама с собой: новое поколение проходит проверку на арене против предыдущего, и если побеждает, становится учителем для следующего. За полтора месяца разработчик обучил 30 поколений; на маленьких полях (9×9) процесс занимал 3 часа, на больших (23×23) — 35 часов. Автор столкнулся с неочевидными проблемами: два поколения подряд не переигрывали учителя, пока он не повысил бюджет поиска с 800 до 1600 симуляций на ход. Алгоритмическое улучшение (кэширование дерева поиска) сделало бота сильнее, но привело к появлению ничьих в обучающих партиях, ухудшив обучение следующих поколений. Для новичков пришлось создать отдельного эвристического бота без нейросети. Игра выложена в Steam бесплатной демо с полями 15×15 и 20×20, тремя уровнями сложности; на сложном уровне нейросеть стабильно обыгрывает автора. Релиз планируется в декабре с добавлением классического поля 39×32 и четвёртого уровня «Хардкор». Модель реализована на Godot и C#, обучение — на Python и PyTorch, для встраивания в игру использован формат ONNX.
Выводы автора:
- При обучении нейросети для игр часто работают не очевидные факторы: улучшение алгоритма или параметров поиска могут неожиданно помешать обучению следующих поколений, требуя экспериментов и отката.
- Для игр с огромным пространством ходов (>1000 вариантов) комбинаторный перебор неприменим, нужна нейросеть для оценки позиций и выбора перспективных направлений поиска.
- Даже простая подстройка сложности (тонкая настройка параметров ИИ) может быть неудачной; иногда проще создать отдельный алгоритмический бот для лёгкого уровня, чем ослабить нейросетевого.
Новое поколение обыграло учителя! Похоже, с сохранённым деревом боты лучше защищались и чаще сводили партии к ничьей. Бот стал сильнее, а учить следующую сеть стал хуже.
Оригиналы:Я обучил нейросеть играть в «Точки» — теперь она меня обыгрывает
Anthropic ужесточила контроль: Claude блокирует аккаунты пользователей из Гонконга и России через VPN
ИИ и агенты · Habr · 7/10
Компания Anthropic начала более активно блокировать учётные записи пользователей, пытающихся получить доступ к Claude через VPN из стран, где сервис официально не поддерживается, включая Гонконг и Россию. Пользователи сообщают о получении писем от службы безопасности о «подозрительной активности» и полном аннулировании аккаунтов. При попытке подать апелляцию многие получают отказ с пометкой «финальное решение». Проблема имеет практические последствия: пользователи теряют доступ не только к сервису, но и к сохранённым в интерфейсе Claude историям чатов, коду и другим данным. Оплаченные Pro-подписки при этом не возвращаются. Хотя Россия и Гонконг не входят в официальный список поддерживаемых регионов Anthropic, сама компания до сих пор публично не объявляла об ужесточении политики блокировок для VPN-пользователей.
Выводы автора:
- Anthropic усиливает географические ограничения и блокирует доступ пользователей из неподдерживаемых регионов, включая России и Гонконг, при попытке использования VPN.
- При блокировке аккаунта пользователи теряют все сохранённые данные (чаты, код, аналитику) и не получают возврат средств за подписки.
При внутренней проверке якобы обнаружены «подозрительные сигналы», связанные с аккаунтом, однако компания не уточняет причины блокировок и часто не удовлетворяет апелляции.
Оригиналы:Claude начал блокировать пользователей из Гонконга за использование VPN
DeepSeek выпустили десктопный клиент Harness с поддержкой плагинов
ИИ и агенты · Habr · 7/10
DeepSeek представили preview-версию своего десктопного приложения Harness для работы с кодом, документами и данными. Приложение доступно для macOS и Windows и построено на архитектуре «всё является плагином», что позволяет полностью кастомизировать адаптеры моделей, инструменты, интерфейс и цикл работы агента. В релиз вошли менеджер плагинов и инструмент для запуска задач по расписанию. Экосистема расширений уже развита: на публичном каталоге dsh.pub доступно 8 744 плагинов, объединяющих встроенные модули и сторонние пакеты. Исходный код Harness опубликован под свободной лицензией MIT, а собственный официальный маркетплейс DeepSeek находится в планах развития.
Выводы автора:
- DeepSeek Harness построен на принципе максимальной расширяемости через плагины, позволяя полностью адаптировать инструмент под конкретные задачи.
- Открытый исходный код и растущая экосистема (более 8,7 тыс. плагинов) делают Harness привлекательной платформой для разработчиков и AI-инженеров.
Всё является плагином: адаптеры моделей, инструменты, интерфейс и сам цикл работы агента.
Accenture показал рост спроса на ИИ-проекты, но с давлением на цены
ИИ и агенты · App Economy Insights · 7/10
Консалтинговая компания Accenture опубликовала квартальные результаты, показавшие, что ИИ пока создаёт больше работы, чем её уничтожает. Выручка выросла на 6% в годовом сравнении до $18,7 млрд, новые контракты (bookings) увеличились на 5% до $22,2 млрд, что стало разворотом после падения в предыдущем квартале.
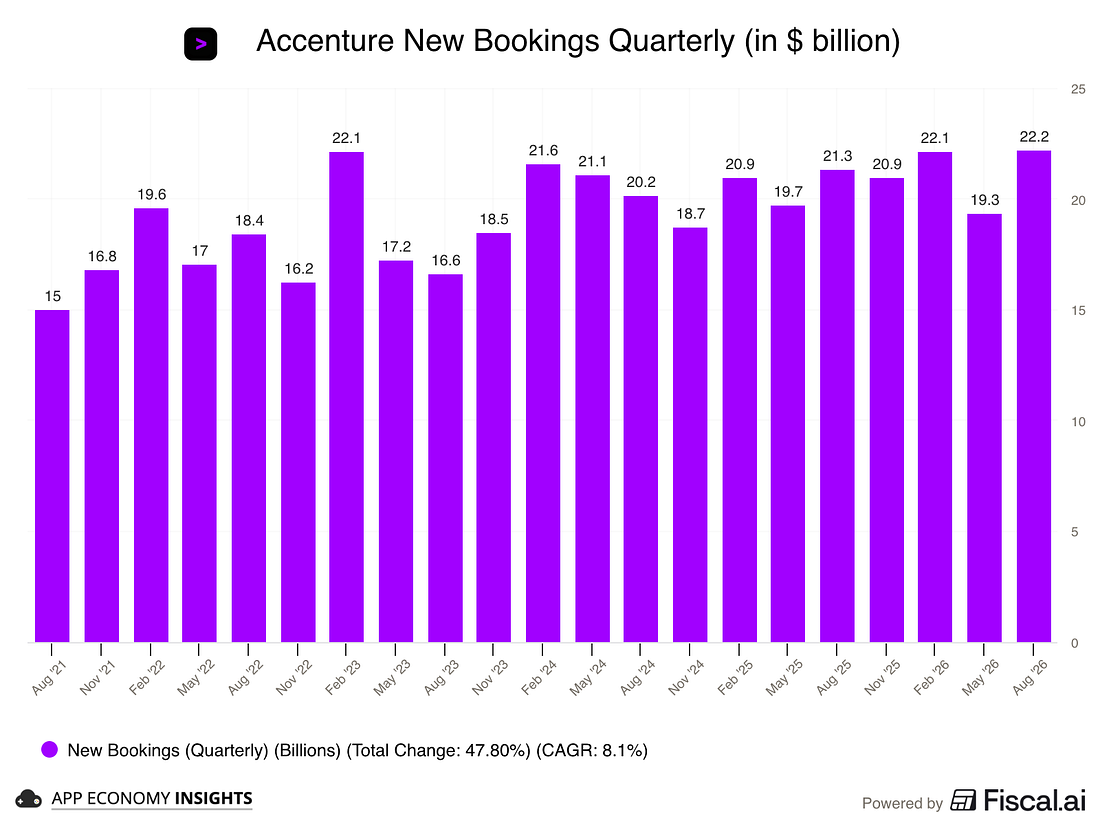
Управляемые сервисы достигли рекордной суммы $12,8 млрд. Более 400 клиентов запустили свои первые проекты с advanced AI в течение фискального года 2026, с почти 100 новыми клиентами только в Q4.
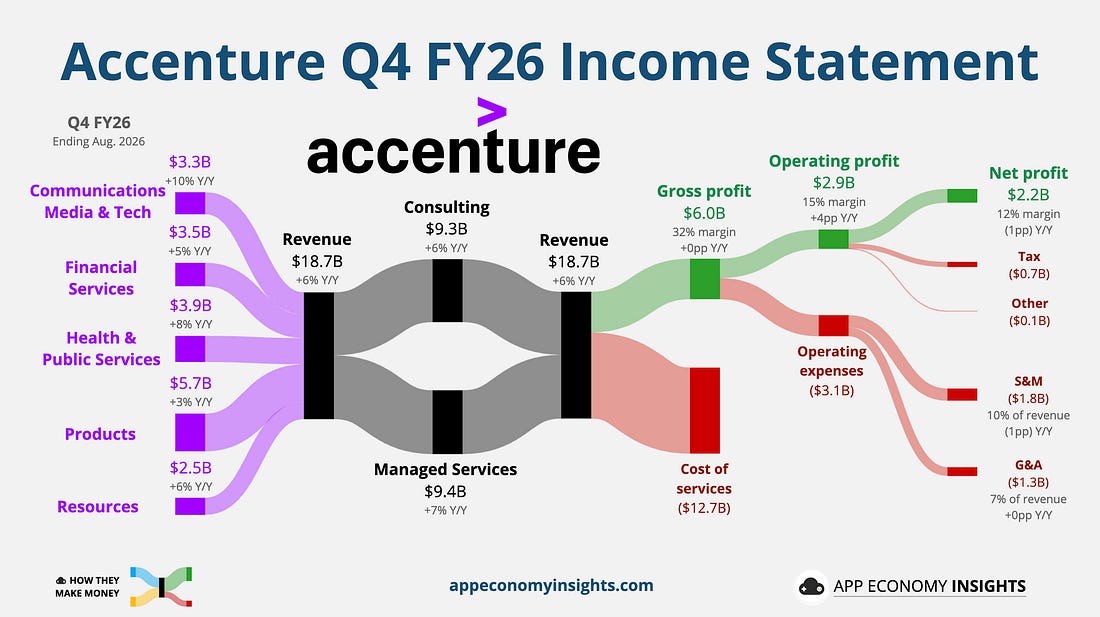
Компания отмечает, что большая часть спроса исходит от компаний, строящих инфраструктуру данных, цифровое ядро и основы для массового развёртывания агентов. Однако экономика меняется: Accenture признала снижение цен в большинстве направлений из-за роста производительности от ИИ и усиления конкуренции. Найм также замедлится в FY27 по мере трансформации способов доставки услуг. На FY27 компания прогнозирует рост выручки на 3–6% в местных валютах, хотя M&A должны дать 2–2,5%, что указывает на более скромные органические перспективы. Accenture планирует потратить $5 млрд на покупки и вернуть акционерам минимум $9,5 млрд.
Выводы автора:
- ИИ пока увеличивает объём работы для консалтинговых компаний, но основной спрос идёт на инфраструктурные проекты, а не на прямое применение агентов
- Давление на цены и замедление найма будут расти по мере того, как ИИ повышает производительность и конкуренцию
ИИ создаёт больше работы для Accenture, чем уничтожает. Консультинговая выручка выросла на 6%, и почти 100 дополнительных клиентов начали свои первые advanced AI проекты.
Оригиналы:Accenture квартальные результаты
История Unix-времени: от розетки 1970 года к проблеме 2038
Разработка и архитектура · Habr · 9/10
Статья рассказывает историю и технические детали Unix-времени, которое отсчитывается с полуночи 1 января 1970 года. Первоначально Unix считал время в шестидесятых долях секунды, отсчитывая от 1 января 1971 года, и выбор этой единицы был обусловлен частотой переменного тока в американской розетке (60 Гц) – таймер PDP-11 дёргал прерывание на каждом периоде. 32-битный счётчик хватал примерно на 2,27 года, поэтому около 1973 года разработчики перешли на целые секунды и установили эпоху на 1 января 1970 года, переведя счётчик в знаковый формат, что дало запас до 2038 года (68 лет). Деннис Ритчи объяснял выбор этой даты просто: нужна была круглая дата неподалеку от текущего момента. 19 января 2038 года в 03:14:07 UTC 32-битный знаковый счётчик переполнится и прыгнет в пятницу, 13 декабря 1901 года, что сломает программы, полагающиеся на это значение. Автор проверила эффект переполнения в C, JavaScript (побитовая операция |0 молча переводит 2038 год в 1901-й), ext4 (файлы с временем 2040 года в 128-байтных inode теряются в 1903 году), MySQL TIMESTAMP и других местах хранения времени.
Выводы автора:
- 32-битное знаковое Unix-время переполнится 19 января 2038 года, перепрыгнув в 1901 год, и это молча сломает всё, что полагается на сравнение времён (таймауты, сертификаты, кэш)
- Проблема скрыта везде: в JavaScript-операции |0, MySQL TIMESTAMP, ext4 с 128-байтными inode, protobuf-схемах и любом коде, хранящем время в 32-битном целом числе
- Выбор 1970 года как начала эпохи был прагматичным: нужна была круглая дата, а 64-битное время полностью решит проблему на сотни миллиардов лет вперёд
Счетчик перепрыгивает из вторника 2038 года прямиком в пятницу, 13 декабря 1901 года, и более подходящую дату для такого прыжка не придумал бы ни один сценарист.
Оригиналы:Часы Unix тикали от розетки: откуда взялся 1970 год и что сломается в 2038-м
Скоростная разработка электроники 2: сенсор присутствия с функциональной безопасностью
Разработка и архитектура · Habr · 9/10
Статья рассказывает о разработке промышленного сенсора присутствия для опасных зон с использованием ИИ-инструментов и открытого ПО. Автор описывает переход от коммерческих систем (Altium, SolidWorks) к KiCAD и FreeCAD, а также применение ИИ для автоматизации проектирования электроники и печатных плат. Сенсор объединяет три типа датчиков: радар BGT60TR13C, многозонные ToF-датчики VL53L8CX и ИК-термометры MLX90632 для надёжного обнаружения присутствия, избегая ложных срабатываний в условиях вибраций и изменений сцены. Архитектура состоит из трёх модулей: платы питания с релейным выходом, платы процессора на базе STM32H743 с криптографией и двух выносных платок ToF/ИК, соединённых шлейфами. Автор проанализировал риски согласно требованиям функциональной безопасности PL/SIL (Machinery Regulation EU 2023/1230), выявив 10 критических сценариев отказа: пропуск человека, помехи, сбои МК, застывание реле, обрывы соединений, электромагнитные помехи и другие. Ключевым решением стала двухступенчатая накачка для управления реле, исключающая зависания, и внешний сторож TPS3430. Все три проекта KiCAD-схем созданы ИИ с последующей ручной доводкой. ИИ самостоятельно читал технологические нормы JLCPCB, разводил платы алгоритмами A* и PathFinder, оптимизировал размещение и трассировку. Платы имеют размеры от 18×11 до 70×40 мм, используют 2–6 слоёв и полностью производятся на JLCPCB с минимальными дополнительными компонентами.
Выводы автора:
- ИИ способен не только воспроизводить существующие решения, но и генерировать оригинальные архитектуры электроники с учётом множества ограничений (цена, производство, надёжность, безопасность)
- При разработке функционально безопасных устройств критичны архитектурные решения на уровне электроники: двухступенчатая накачка реле, внешний сторож, контроль обратной связи и зеркальные контакты для диагностики
- Открытый формат KiCAD и доступ к его API позволили создать собственные инструменты автоматизации (расстановка и трассировка), которые оказались эффективнее коммерческих плагинов
ИИ создал схемы не сразу: потребовалось около десяти итераций с корректировкой ошибок, но его способность быстро распределять сигналы на сложных микроконтроллерах типа STM32 просто завораживает.
Оригиналы:Скоростная разработка электроники 2
Зелёный пайплайн ничего не доказывает: семь способов обхода quality gate
Разработка и архитектура · Habr · 9/10
Статья разбирает фундаментальную проблему CI/CD и MLOps: зелёный пайплайн и пройденные quality gate часто не означают, что код или модель готовы к продакшену. Автор описывает семь реальных способов, которыми плохой код или неработающие модели проходят проверки в прод. Первая проблема — сами гейты могут быть неэффективными: `allow_failure: true`, магические комментарии вроде `[skip ci]`, отключённые проверки в правилах. Вторая — утечка данных в ML: информация о правильных ответах просачивается в обучение, модель подсматривает, а метрика выглядит блестяще. Исследование Капура и Нараянана из Принстона обнаружило 648 статей в 30 областях с такими утечками. Третья проблема — тестовые наборы из другого распределения. Например, COVID-модели на рентгене обучались на данных «датасетов-Франкенштейнов» без внешней валидации и учили не болезнь, а побочные особенности (текст на снимке, положение пациента, тип аппарата). Четвёртая — неправильный выбор метрики или порога: Epic Sepsis Model заявляла AUC 0,76—0,83, но реальная валидация показала 0,63 и пропуск 67% случаев сепсиса. Пятая проблема — underspecification: разные модели с одинаковыми метриками на тесте ведут себя по-разному в реальности. Шестая — дрейф: Google Flu Trends и Zillow Offers потеряли миллионы, потому что мир менялся, а гейты проверяли только прошлое. Седьмая — training-serving skew: пайплайн проверял ноутбук, а в прод уехали другие признаки или другой артефакт. Примеры xz-utils и SolarWinds показывают, как бэкдоры проходили проверки, потому что код в Git отличался от собираемого бинарника.
Выводы автора:
- Зелёный гейт — недостаточное условие готовности к продакшену; нужны дополнительные проверки на честность разбиения данных, присутствие утечек, дрейф в проде и соответствие между обучением и deployment.
- Утечка данных в ML системна: нужно превратить проверку разбиения в автотесты и требовать обязательное описание, как выбирались признаки и где они доступны на момент прогноза.
- Метрики должны соответствовать реальным условиям: вместо усреднённых AUC нужны precision/recall на рабочем пороге, внешняя валидация, стресс-тесты на сдвиги распределения и регулярный мониторинг дрейфа в продакшене.
Зелёная галочка не значит «модель хорошая» — гейт в таком виде похож на суд, который выносит оправдательный приговор по показаниям одного свидетеля.
Оригиналы:Зелёный пайплайн ничего не доказывает. Семь способов, которыми quality gate пропускает брак в прод
YDB запустила полнотекстовый и гибридный поиск с ранжированием
Разработка и архитектура · Habr · 8/10
YandexDB добавила в релизе 26.3 полнотекстовый поиск с ранжированием и гибридный поиск, объединяющий полнотекстовый и векторный поиск в одном SQL-запросе. Проблема: ни один вид поиска не универсален – полнотекстовый находит точные совпадения слов и номеров (полис 7702-345678), но не понимает синонимы и смысл (перенос рейса = задержка вылета), векторный ищет по семантике, но теряет редкие фамилии и номера. Раньше индексы жили отдельно от СУБД: данные дублировались в поисковых системах, синхронизация отставала, права доступа приходилось проверять отдельно. Теперь оба индекса – служебные таблицы YDB: хранятся с избыточностью, делятся на партиции, обновляются в той же транзакции с данными, получают консистентность и масштабируемость автоматически. Полнотекстовый индекс устроен как инвертированный: он переворачивает связь документ→слова в слово→документы через словарь термов и posting lists. Для русского доступна морфология Яндекса, для обычных пользователей – стемминг Snowball. Индекс хранится в таблице YDB с компрессией, и планировщик запросов обращается к нему в одном запросе с основной таблицей, не требуя отдельного слоя приложения для объединения результатов.
Выводы автора:
- Гибридный поиск необходим для реальных запросов, требующих одновременно точного совпадения и семантического понимания
- Размещение индексов внутри СУБД вместо отдельных систем решает проблемы рассинхронизации, проверки прав доступа и сложности масштабирования
- Полнотекстовый индекс в YDB реализован как набор служебных таблиц с партиционированием и репликацией, что избавляет от необходимости писать отдельный индексный слой
Если индекс — часть той же СУБД, он получает всё это сразу, без синхронизации, отдельного кластера и дополнительного кода в приложении.
Взлёт и падение IrDA: почему инфракрасный порт исчез быстрее пейджера
Разработка и архитектура · Habr · 8/10
Статья рассказывает историю IrDA — технологии передачи данных через инфракрасный порт, которая была повсеместной в конце 90-х и начале 2000-х годов, но практически исчезла к 2010-м. Вопреки распространённому мнению, IrDA была быстрее Bluetooth по спецификациям (4 Мбит против 0,7 Мбит в 1999 году, 16 Мбит против 3 Мбит в 2005 году), однако проиграла конкуренцию из-за ограничений её физической природы. Технология родилась из инженерной задачи HP в 1986 году — создать принтер без разъёмов для калькуляторов. За основу была взята HP-SIR, разработана в 1993–1994 годах в условиях войны стандартов (Sharp ASK, General Magic MagicBeam). Архитектура IrDA состояла из семи уровней: от светодиода 850–900 нм и фотодиода в основании до протоколов высокого уровня (IrCOMM для виртуальных COM-портов, IrOBEX для обмена объектами, IrMC для синхронизации контактов и календаря). Ключевые ограничения: дальность 1 метр, угол ±15°, полудуплекс (невозможность одновременной передачи и приёма), высокая чувствительность к внешнему освещению и люминесцентным лампам. Помимо Bluetooth, IrDA вытеснили практические проблемы — неудобство выравнивания устройств, задержки в протоколе (до 10 мс между передачей и приёмом), отсутствие сеток для одновременного подключения нескольких устройств. Интересно, что Bluetooth позже заимствовал протокол OBEX, созданный в IrDA, для Object Push и File Transfer.
Выводы автора:
- IrDA была технически быстрее Bluetooth на протяжении всего периода сосуществования, но проиграла не из-за скорости, а из-за физических и эргономических ограничений (требование прямой видимости в узком угле, полудуплекс, чувствительность к свету)
- IrDA выросла из задачи HP печати с калькуляторов через инфракрасный портал в 1986 году и стала стандартом благодаря встраиванию в существующую UART-инфраструктуру, что позволило быстро адаптировать её массово
- Bluetooth унаследовал протокол OBEX из IrDA для передачи объектов, что показывает, что технология оставила наследие несмотря на исчезновение в потребительских устройствах
Четыре мегабита против 0,7 в 1999-м, шестнадцать против трёх в 2005-м. Собственное радио Bluetooth, без помощи Wi-Fi, до сих пор не разгоняется быстрее трёх мегабит.
Оригиналы:Технология будущего в 2003 году. Взлёт и падение IrDA
6 техник для эффективной работы LLM в production
Разработка и архитектура · ByteByteGo · 8/10
Материал описывает шесть ключевых техник оптимизации при развертывании больших языковых моделей в масштабе, которые снижают задержки и расходы. Streaming отправляет токены по мере готовности, изменяя восприятие задержки пользователем на время до первого токена. Quantization преобразует веса модели в более низкую точность (например FP8), сокращая потребление памяти и стоимость. Continuous batching добавляет новые запросы в пакет при освобождении слота, снижая простой GPU. Prefix caching кэширует внутренние вычисления для известных входных подсказок, пропуская их пересчет. Paged KV cache хранит кэш в блоках фиксированного размера вместо одного непрерывного чанка, выделяя память динамически. Speculative decoding использует малую модель для предложения нескольких токенов, которые основная модель проверяет за один проход.
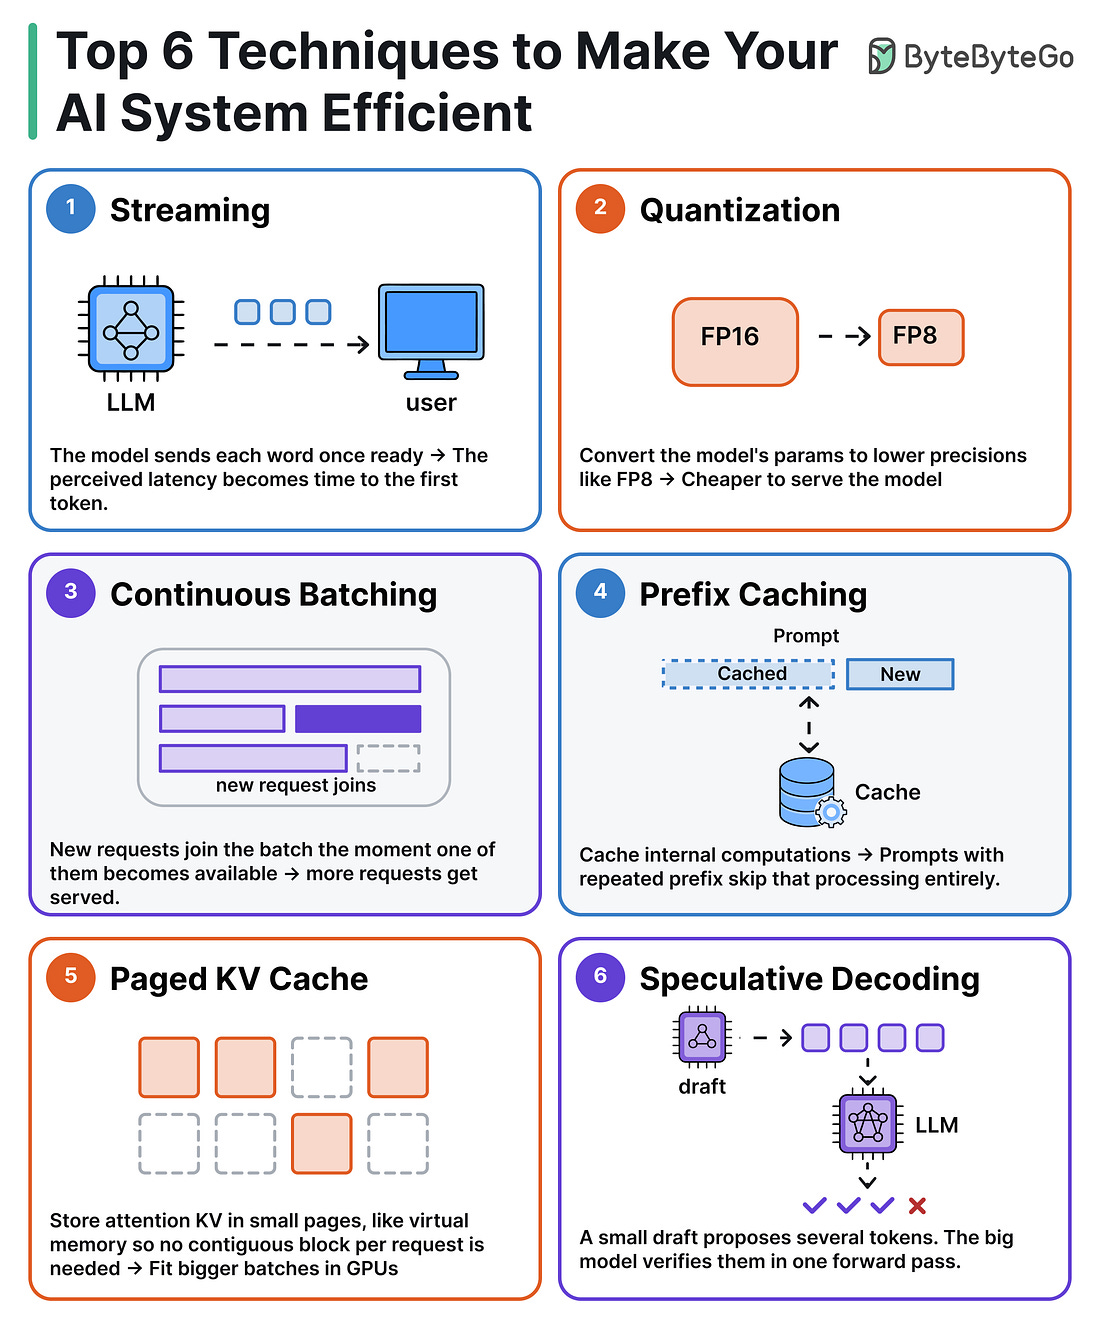
визуализирует эти техники. Все методы адресуют проблему дороговизны и неэффективности масштабного обслуживания LLM.
Выводы автора:
- Комбинация этих техник (streaming, quantization, batching, caching, speculative decoding) существенно снижает стоимость и задержку при развертывании LLM в production
- Оптимизация памяти и использования GPU через кэширование и динамическое выделение ресурсов критична для масштабируемости
- Speculative decoding и prefix caching позволяют использовать вычисления из предыдущих обращений для ускорения новых запросов
Serving LLMs at scale is expensive. These 6 popular techniques reduce latency and cost, and make your system more efficient.
Оригиналы:6 техник оптимизации LLM в production
СуперЗавуч — программа для автоматического составления школьных расписаний
Разработка и архитектура · Habr · 7/10
Автор рассказывает о создании программы СуперЗавуч, которая автоматизирует составление расписаний учебных заведений. Проблема, которую решает программа: составление школьного расписания вручную — трудоёмкий процесс, требующий балансировки множества параметров (отсутствие окон у классов и учителей, равномерное распределение сложности предметов, учёт профильных классов и кабинетов). Существующие аналоги (1С, Хронограф, ProRector) либо платные, либо с урезанным функционалом. СуперЗавуч написан на Python 3.11 с интерфейсом PyQt5, а алгоритм реализован на C++ для производительности. В основе алгоритма лежит метод температурного отжига (имитация отжига), который минимизирует штраф-функцию, включающую количество окон, распределение сложности и другие параметры. Программа содержит 10 меню для настройки проекта, управления классами, учителями, кабинетами, ИИ-ассистента и экспорта. На тестовом примере программа составила расписание для школы с 80 учителями и 40 классами за 2 минуты с результатом около 2 окон в неделю на учителя в среднем.
Выводы автора:
- Используется алгоритм температурного отжига для оптимизации расписания с возможностью регулирования весов различных параметров качества.
- Программа успешно обрабатывает крупные школы (80 учителей, 40 классов) за считанные минуты благодаря реализации алгоритма на C++.
- СуперЗавуч предоставляет открытый доступ (GitHub) и веб-интерфейс для скачивания с полной документацией.
Программа составила расписания для моей школы за 2 минуты, при этом в школе 80 учителей и 40 классов.
Оригиналы:Как я создал СуперЗавуч — программу для генерации расписаний занятий
Как работает SSH и ключевые техники оптимизации ИИ-систем
Разработка и архитектура · ByteByteGo · 7/10
Еженедельный дайджест ByteByteGo охватывает несколько важных тем для инженеров. Основной фокус – объяснение протокола SSH: клиент устанавливает TCP-соединение с сервером, обе стороны согласуют криптографические алгоритмы и проводят обмен ключами через публичные ключи и подписи. Приватный ключ никогда не покидает машину пользователя; сервер верифицирует подпись с помощью публичного ключа. Вторая часть материала описывает 6 техник оптимизации LLM-сервисов: потоковая передача (токен-за-токеном), квантизация весов (снижение точности до FP8), непрерывное батчирование (добавление новых запросов при освобождении слотов), кеширование префиксов, страничное кеширование KV-кеша и спекулятивное декодирование. Третий раздел разбирает анатомию ИИ-агента как цикла: мозг (LLM выбирает действие), планирование (разбор задачи на шаги), инструменты (функции для вызова), память (контекст и векторные хранилища) и гарантии безопасности. В заключение материал объясняет методологию оценки ИИ-приложений через трёхшаговый рецепт: выбор задачи, сбор эвал-данных и разработка грейдера (код-базированный, модель-базированный или человеческий).
Выводы автора:
- SSH обеспечивает безопасность тем, что приватный ключ никогда не передаётся по сети, а сервер верифицирует клиента через подпись и публичный ключ.
- Основные техники масштабирования LLM – потоковая передача, квантизация, непрерывное батчирование, префикс-кеширование и спекулятивное декодирование – снижают задержку и стоимость.
- Оценка ИИ-систем требует систематического подхода: выбор метрики, сбор эвал-данных и комбинация трёх типов грейдеров (код, модель, человек).
Приватный ключ никогда не покидает вашу машину. Сервер проверит подпись с помощью открытого ключа клиента.
Оригиналы:EP228: Как работает SSH
Зачем защищать сеть, если она работает: взгляд сетевого инженера
Кибербезопасность · Habr · 7/10
Статья объясняет сетевым инженерам и начинающим специалистам ИБ, почему корпоративная сеть нуждается в защите даже при отсутствии видимых сбоев. Автор, сетевой инженер Кирилл, показывает, что работающие интерфейсы и успешный ping не гарантируют безопасность данных. Информационная безопасность защищает три ключевых свойства: конфиденциальность (посторонние не получают доступ), целостность (защита от несанкционированных изменений) и доступность (системы работают при необходимости). Даже полная изоляция от интернета не исключает внутренних угроз: сотрудники, флешки, неучтённые устройства, заражённые обновления, временные подключения и физические носители остаются потенциальными каналами утечек. Автор приводит реальные примеры: случай 2008 года с USB-носителем в Министерстве обороны США, личный опыт с вывозом чертежей сотрудниками, инцидент Samsung с загрузкой кода в ChatGPT, взлом СДЭК в 2024 году и кражи исходного кода Rockstar Games в 2022 и 2026 годах. Эти истории демонстрируют, что техническая защита работает только в комбинации с контролем доступа, разграничением прав, DLP-системами, политиками использования сервисов и организационными мерами.
Выводы автора:
- Работающая сеть — это не безопасная сеть; отсутствие видимых проблем скрывает потенциальные инциденты конфиденциальности и целостности данных
- Даже полная изоляция от интернета не защищает от внутренних угроз: сотрудников с законным доступом, физических носителей и временных подключений
- Защита требует комплексного подхода: не только граничные устройства, но и контроль доступа, разграничение прав, DLP-системы, политики и организационные меры
Поднятый интерфейс и успешный ping подтверждают, что пакеты передаются между устройствами. Они не показывают, кто находится внутри сети, куда уходят корпоративные данные и какие команды выполняются на рабочих компьютерах и серверах.
Типология лидера: The Standard-Setter и его иллюзия мотивации
Продукт и карьера · John Cutler from The Beautiful Mess · 8/10
Статья разбирает архетип неэффективного руководителя — The Standard-Setter, который верит, что может добиться большего от команды просто требованием "невозможного" и установкой экстремально высоких стандартов. Такой лидер часто не понимает, что именно делает, и не демонстрирует результаты собственным примером. Хотя он накапливает доказательства «работоспособности» подхода (люди действительно иногда мобилизуются под давлением), он путает давление с мотивацией и игнорирует, что успех достигается за счёт энергии, истощения и текучести кадров. Standard-Setter отличается от хорошего тренера тем, что последний работает 1-к-1, обладает экспертизой и имел общий опыт. Автор указывает, что люди мотивируются по-разному: на них действуют не интенсивность и давление, а ясность, доверие, автономия, смысл, возможность развиваться и связь усилий с чем-то значимым. Standard-Setter часто быстро растёт в организации, потому что выглядит амбициозно и легко читается с уровня выше, однако реальные издержки (усталость, обида, увольнения) распределяются вниз по иерархии. Подход срабатывает только до тех пор, пока лидер может конвертировать должностную власть в видимую производительность.
Выводы автора:
- Требование невозможного и высокие стандарты сами по себе — не форма лидерства, а всего лишь давление, которое может дать кратковременный результат за счёт истощения команды.
- Люди мотивируются разными путями (ясность, доверие, автономия, смысл), а не единообразным давлением, и хороший лидер учитывает эти различия.
- Standard-Setter прогрессирует в организации благодаря видимости амбиций, но реальные издержки его подхода остаются невидимы для верхних уровней управления.
Человек может быть способен на большее под определённые обстоятельства, на ограниченный период и с разными побочными издержками. Standard-Setter использует это как доказательство своего воздействия, а не как простое свидетельство того, что люди спосо
Оригиналы:TBM 443: The Standard Setter
Коротко
ИИ и агенты
- Anthropic начала массово банить аккаунты Claude за использование VPN – Anthropic запустила волну блокировок аккаунтов Claude для пользователей из неподдерживаемых регионов, включая Россию и Гонконг, даже при использовании платных VPN-сервисов.
- Figure утилизировала роботов Figure 02 в расплавленном металле с участием Шварценеггера – Американская компания Figure AI переходит на новое поколение антропоморфных роботов Figure 03 и утилизирует старые модели Figure 02.
Экономика
- Nike Q1: падение выручки на 4% и потеря Мбаппе конкуренту On – Nike столкнулась с серьёзными вызовами в первом квартале: выручка упала на 4% в годовом выражении до $11,2 млрд (промах на $110 млн), а прибыль на акцию снизилась на 2% до $0,48.
Продукт и карьера
- Ректор МГТУ советует не отдавать детей в IT из-за насыщения рынка – Ректор МГТУ им.