Дайджест за 25 сентября 2026
Интерактивные ИИ-агенты научились работать эффективнее через манипуляции KV-кешем, а инженеры открывают новые способы экономить память даже в асинхронном Rust — это переломный момент для высоконагруженных систем. JetBrains превращает IDE Air в полноценную экосистему для AI-агентов, пока локальные LLM-решения вроде YuE2 Studio начинают вытеснять облачные сервисы, давая разработчикам контроль и скорость.
Главное
- Интерактивные агенты через манипуляции KV-кешем: новый подход к инференсу
- Как фигурная скобка экономит килобайты памяти в асинхронном Rust
- Паттерны реал-тайм коммуникации для собеседований по системному дизайну
- ИИ, полезное трение и потеря суждения в product-разработке
- Кэширование промптов в GPT-6: революция в экономике долгоживущих агентов
Подробно
Интерактивные агенты через манипуляции KV-кешем: новый подход к инференсу
ИИ и агенты · Habr · 9/10
Статья исследователя Яндекса Георгия Якушева описывает принципиально новый подход к созданию интерактивных ИИ-агентов, которые работают асинхронно и могут обновлять состояние прямо во время вычислений, без переобучения модели. Основная идея: рассматривать KV-кеш не как пассивную оптимизацию скорости, а как активное состояние агента, которым можно манипулировать на уровне инференса. С помощью поворотов RoPE один и тот же физический блок кеша получает разные логические позиции для разных потоков вычисления. Описаны два ключевых подхода: Hogwild! Inference позволяет нескольким экземплярам модели работать параллельно, записывая токены в общую память и видя работу друг друга в реальном времени; AsyncReasoning разделяет инференс на три независимых логических потока—входящую информацию, внутреннее рассуждение (Thinker) и ответ пользователю (Writer), сокращая воспринимаемую задержку до первого токена ответа в 80 раз. Система демонстрируется на примере мультимодального агента, играющего в Doom, который получает кадры в реальном времени, рассуждает и генерирует команды параллельно, без специального переобучения на игровых траекториях.
Выводы автора:
- KV-кеш можно переиспользовать для разных логических представлений одних и тех же данных, создавая асинхронные взаимодействия между потоками агента без переобучения модели
- Интерактивные системы с параллельным рассуждением и коммуникацией позволяют агентам думать во время ответа, радикально сокращая воспринимаемую пользователем задержку
- Мультимодальные агенты можно строить как асинхронные I/O-системы с независимыми входными и выходными каналами, позволяя модели обновлять действия на основе новых наблюдений в реальном времени
Рассуждение и коммуникация становятся независимо планируемыми процессами; модель может долго думать над сложной задачей, но ей больше не обязательно всё это время молчать.
Оригиналы:Как сделать интерактивного агента с помощью KV-кеш-манипуляций
Кэширование промптов в GPT-6: революция в экономике долгоживущих агентов
ИИ и агенты · Tech Scoop Newsletter · 9/10
OpenAI внедрила механизм кэширования промптов в GPT-6, который переопределяет экономику работы долгоживущих ИИ-агентов. На поверхности это выглядит как оптимизация инференса, но на самом деле это влияет на всю архитектуру приложений с агентами. Ключевой инсайт: стоимость работы агента растёт не столько из самого ответа, сколько из повторного прочтения тысяч токенов контекста (инструкций, определений инструментов, истории). Механизм кэширует внутренние KV-состояния трансформера для переиспользуемых префиксов промпта, а не просто сохраняет токены. При повторном запросе, начинающемся с того же префикса, модель переиспользует ранее вычисленное состояние вместо пересчёта. Экономия огромна: при 100 тысячах стабильного контекста и десяти запросах кэширование снижает эквивалент обработанных токенов с 1 млн до 215 тыс (экономия ~78%). Цены: запись в кэш стоит 1,25× обычного входного токена, а чтение только 0,1×, что создаёт мощный стимул к переиспользованию. Минимальный порог кэшируемого префикса — 1024 токена, что переворачивает интуицию: иногда выгоднее добавить примеры до порога, чем держать короткий некэшированный промпт. Новые инструменты: явные точки разрыва кэша (cache breakpoints), управление инструментами через allowed_tools вместо их удаления, смена reasoning_effort без инвалидации кэша. Жизненный цикл кэша: минимум 30 минут, обновляется при переиспользовании. Это делает кэш похожим на рабочую память сессии агента.
Выводы автора:
- Разработчикам теперь нужно проектировать промпты как инженеры систем — думать о топологии контекста, где стабильная информация должна быть в начале, а волатильная в конце, чтобы максимизировать переиспользование кэша.
- Кэширование превращает оптимизацию промптов из минимизации количества токенов в минимизацию дорогостоящих вычислений — иногда выгоднее расширить стабильный префикс выше порога 1024 токенов, чем держать его короче.
- Управление инструментами должно разделяться на стабильный каталог с fixed порядком (для кэша) и runtime-политику выбора доступных инструментов (для функциональности).
Это означает, что разработчики всё больше должны думать о LLM-промпте так же, как системные инженеры думают об иерархиях памяти, индексах БД и КДН-кэшах.
Оригиналы:OpenAI's New Prompt Caching Changes the Economics of Long-Running AI Agents
Краш-тест клона корпоративной системы, написанного ИИ за 48 часов
ИИ и агенты · Habr · 8/10
Директор компании-разработчика платформы продвинутой аналитики провел эксперимент, чтобы проверить, способны ли нейросети полностью клонировать сложный корпоративный продукт за 48 часов, имея только документацию без исходного кода и архитектурных схем. На первый взгляд результат впечатляет: ИИ создал современный веб-интерфейс с асинхронным управлением, пошаговые визарды, специфичные визуализации (ROC-кривые) и даже добавил функционал поиска аномалий, которого не было в оригинале. Однако глубокое тестирование на реальных данных выявило критические проблемы: узлы для Python/JavaScript кода не интегрированы в поток данных, OLAP-куб показывает только первые 1000 записей и дает неверные итоговые суммы, система падает при загрузке 50 млн строк с ошибкой Out of Memory, декларируемый параллелизм отсутствует, код покрывает только «удачные сценарии» без обработки граничных условий. Автор делает вывод, что ИИ хорошо удешевляет прототипирование, но не способен воспроизвести эмерджентные свойства сложных систем, возникающие на стыке компонентов, и создает опасный технический долг за счет непроверенного кода.
Выводы автора:
- ИИ эффективен для быстрого прототипирования, но не в состоянии создавать надежные корпоративные системы, требующие обработки граничных условий, параллелизма и эмерджентных свойств на стыке компонентов.
- Недостаток документации по деталям реализации, оптимизациям и edge-cases не может быть компенсирован правильными промптами — это накопленный инженерный опыт, который нельзя извлечь из текстовых описаний.
- Непроверенный код, сгенерированный ИИ, создает скрытый технический долг на годы вперед, так как каждый слой непроверенного кода усугубляет проблему.
20 лет инженерного опыта невозможно скачать из документации за 2 дня.
Оригиналы:Краш-тест клона корпоративной системы, написанного ИИ за 48 часов
Бенчмарк качества англо-русского перевода для LLM: методология и результаты
ИИ и агенты · Habr · 8/10
Автор разработал методику оценки качества англо-русского художественного перевода для LLM, встроенную в конвейер BookTrans. На основе адаптированного рассказа О. Генри проверяются модели через 100 контрольных точек по 12 категориям (точность смысла, полнота, стиль, согласованность, имена и др.), каждая точка даёт одно очко, итог нормируется к 100. По результатам тестирования лучшие показатели у GPT-6 Astra (90 баллов) и Gemini 3.8 Flash (88), китайские модели GLM 5.3 (84) и DeepSeek V4 Flash (82,3) неожиданно обошли Claude Opus (78,3). Методика избегает недостатков счёта редакторских правок: каждая модель судится трижды с расчётом среднего (не медианы) для учёта нестабильности, используется внешний судья (Claude Opus 5.5), штрафуются отсебятина и нарушения формата, различаются ошибки модели и сбои сети. Бенчмарк входит в BookTrans с версии 1.10.77, доступен для тестирования любых переводчиков через открытый интерфейс командной строки, включает примеры с локальными моделями.
Выводы автора:
- Китайские LLM (GLM 5.3, DeepSeek V4 Flash) показали более высокое качество художественного перевода с англ. на рус., чем флагманы Claude, хотя слабые китайские модели остаются заметно ниже.
- Методика оценки через контрольные точки вместо счёта редакторских правок позволяет объективнее измерять качество, исключая вкусовщину судьи и стимулы к искусственному упрощению перевода.
- Бенчмарк встроен в свободно доступный инструмент BookTrans и позволяет тестировать как облачные модели через API, так и локальные модели.
Редактор не видит оригинала, поэтому гладкий перевод, который выбросил метафоры и упростил предложения, получает меньше правок, чем смелый и точный.
Оригиналы:Бенчмарк качества англо-русского перевода для ведущих западных и китайских LLM
Как Selectel автоматизировал разбор инцидентов SOC с помощью RAG и локальной LLM
ИИ и агенты · Habr · 8/10
Selectel описывает систему автоматизации первичного анализа инцидентов безопасности с использованием локальной LLM, RAG и валидатора вместо облачных сервисов и файнтюнинга. До внедрения на разбор каждого из ~100 ежемесячных инцидентов уходило до двух рабочих дней, при этом ~80% оказывались ложными срабатываниями; внедрение RAG позволило освободить аналитиков от рутины. Команда выбрала локальную модель GLM-5.2 вместо Qwen 3.6-27B из-за лучшей точности (67,6% vs 48,5% accuracy) и меньшей ложной эскалации (4% vs 9,1%). Вместо файнтюнинга выбрали RAG, так как не было крупного размеченного датасета и требовалась быстрая реализация. Схема включает: нормализацию сырого JSON из SIEM, обогащение данными из OSV API (уязвимости), поиск контекста в Confluence, анализ локальной моделью, валидацию вторым проходом с проверкой согласованности (agreement_score). При согласии валидатора (≥0,8) инцидент закрывается как ложное срабатывание или эскалируется L2; при несогласии или недостатке данных — отправляется на ручной разбор. Инцидент по шагам: SIEM → нормализация → обогащение CVE → поиск в документации → RAG обработка → анализ моделью → валидация → решение (close_fp/escalate_l2/monitor/human_review) → уведомление в Telegram.
Выводы автора:
- RAG оказался более практичным решением чем файнтюнинг благодаря быстроте внедрения, отсутствию необходимости в большом размеченном датасете и возможности обновлять информацию без переобучения модели.
- Валидатор как второй проход анализа критичен для снижения ложных эскалаций и обеспечения надежности системы в боевых условиях.
- Локальное развертывание моделей и n8n необходимо для соблюдения требований безопасности при работе с приватными данными инцидентов и инфраструктуры.
RAG позволяет собрать данные из внутренней документации, которая содержит информацию по хостам, доменам и инфраструктуре. Модель получает только нужную информацию и на её основе принимает решение.
Оригиналы:Почему для разбора инцидентов мы выбрали RAG, а не файнтюнинг
YuE2 Studio: локальная генерация музыки на видеокарте вместо облачных сервисов
ИИ и агенты · Habr · 8/10
Автор представляет YuE2 Studio — десктопное приложение для генерации музыки на собственной видеокарте, созданное как альтернатива облачному Suno. Приложение использует открытую модель YuE2 от команды M-A-P, которая сначала генерирует партитуру в формате ABC (мелодию, аккорды, инструментальную тему), а затем преобразует её в звук. Ключевое отличие YuE2 от закрытых сервисов: партитуру можно редактировать, меняя ноты, темп и тональность, и перепевать композицию. Интерфейс включает нотный стан, библиотеку треков, плеер с караоке, видеоредактор для создания клипов и разбор песни на шесть стемов (барабаны, бас, вокал, гитара, пиано и прочее). На RTX 4090 трек длиной 3:38 генерируется примерно за 46 секунд. Модель работает от 6 ГБ видеопамяти благодаря квантованным весам GGUF, что в четыре раза меньше, чем требует официальная сборка.
Выводы автора:
- YuE2 обеспечивает лучшее качество песен по сравнению с Suno v6 и другими открытыми конкурентами благодаря промежуточной генерации редактируемой партитуры
- Переход с Python/Gradio на нативный движок C++, Rust и Tauri позволил снизить требования к видеопамяти в четыре раза, ускорить генерацию и создать полноценное десктопное приложение без облачных зависимостей
- Весь код студии (7 тысяч строк поверх базовой сборки) написан Claude Code за восемь часов разработки, что демонстрирует практическую эффективность агентов для портирования и модификации сложных проектов
Партитура решает проблему не только в качестве генерации, но и в каверах: на тесте SHS100K YuE2 сохраняет мелодию так, что кавер узнаётся как та же песня в 71% случаев.
Оригиналы:YuE2 Studio на Habr
Сравнение GPT6-Astra и Opus 5.5 в разработке браузерной игры «Ну, погоди!»
ИИ и агенты · Habr · 8/10
Автор провёл объективное сравнение двух флагманских моделей ИИ — GPT6-Astra и Opus 5.5 — на практической задаче разработки полнофункциональной браузерной игры по мотивам советской электронной игры «Электроника ИМ-02 — Ну, погоди!». Обе модели получили одинаковый подробный промпт с жёсткими требованиями: HTML+CSS+JavaScript без фреймворков и внешних зависимостей, SVG-первый подход для графики, поддержка desktop-клавиатуры и мобильного touch-управления, полная игровая механика с четырьмя позициями Волка, падающими яйцами, системой штрафов и прогрессирующей сложностью. Оценка выполнения проводилась по 9 критериям на 100 баллов: работоспособность (20 баллов), игровая механика (25), динамика игры (10), управление на desktop (10), мобильная версия (10), SVG и анимация (10), визуальное качество (5), звук и обратная связь (5), качество кода (5). Каждой модели была дана одна итерация без уточнений, подсказок и исправлений — оценивалась именно первоначально полученный результат. Это полезный практический тест для оценки способности современных LLM выполнять комплексные задачи разработки с множеством требований и ограничений, часто встречающихся в реальной работе.
Выводы автора:
- Практическое сравнение LLM-моделей на сложной задаче разработки полноценного приложения более информативно, чем абстрактные бенчмарки, так как показывает способность моделей самостоятельно принимать архитектурные решения и выдавать законченный результат с первой попытки.
- Подробный, структурированный промпт с явным указанием ограничений (никаких фреймворков, CDN, внешних зависимостей) и критериев оценки позволяет объективно сравнивать LLM на выполнение практических задач разработки.
Оценивается именно тот результат, который агент смог выдать самостоятельно с первой попытки без уточнений и подсказок.
Оригиналы:Сравнение GPT6-Astra и Opus 5.5 в разработке игры «Ну, погоди!»
JetBrains превращает IDE Air в полноценную экосистему для работы с AI-агентами
ИИ и агенты · Habr · 8/10
JetBrains расширила концепцию своей среды разработки Air (Agentic Development Environment), представленной в конце 2025 года, превратив её из простой IDE в комплексную экосистему для разработки с AI-агентами. Теперь Air включает три основных компонента: Air в IDE — инструмент для запуска и управления AI-агентами (Claude, Codex, Gemini, Junie, GitHub Copilot и других) прямо в средах разработки JetBrains с поддержкой параллельных сессий и просмотра изменений; Air Teams — облачная среда для совместной работы разработчиков и агентов с возможностью автоматизации рутины, включая ревью кода и подготовку описаний релизов; Air Governance — корпоративный слой для управления доступом к моделям, установки лимитов токенов и отслеживания использования. Параллельно JetBrains развивает открытый протокол Agent Client Protocol (ACP) для стандартизации взаимодействия между агентами и IDE. Air Context следит за контекстом проекта и семантически индексирует кодовую базу. Плагин Air уже доступен для установки в IDE JetBrains, а компоненты Teams и Governance находятся в раннем доступе.
Выводы автора:
- JetBrains трансформирует Air в многоуровневую экосистему с поддержкой различных AI-агентов для индивидуальных разработчиков и команд
- Air Governance обеспечивает корпоративный контроль над доступом к моделям и расходом токенов, делая решение пригодным для enterprise
- Открытый протокол ACP и система Air Context позволяют стандартизировать взаимодействие агентов с IDE и повышать качество работы за счёт контекста проекта
Air становится общим слоем для нескольких продуктов JetBrains, объединяя инструменты для разработчиков, команд и корпоративного управления
Оригиналы:JetBrains трансформирует IDE Air в экосистему для разработки с AI-агентами
Как фигурная скобка экономит килобайты памяти в асинхронном Rust
Разработка и архитектура · Habr · 9/10
Статья разбирает, почему размер асинхронной функции в Rust может варьироваться от 2 до 1026 байт в зависимости от расположения переменных, и как это масштабируется на сервисах с десятками тысяч соединений. Компилятор Rust преобразует асинхронные функции в перечисления (enum) с вариантами для каждого состояния (Unresumed, Suspend, Returned, Panicked). Внутрь этого перечисления попадают только переменные, которые переживают точку await — остальные можно обернуть в скобки, чтобы они уничтожились раньше. Если буфер на 1024 байта объявлен до await и используется после, он займёт место во всех вариантах перечисления. Если обернуть его в блок со скобками, буфер умирает до await и компилятор может переиспользовать память для других переменных в разных вариантах. На матрице конфликтов компилятор отслеживает, какие переменные живы одновременно, и распределяет память только под необходимое. Каждый уровень вложенности футур добавляет один байт (дискриминант). Самореферентные структуры (срезы вектора, хранящие указатель на сам вектор) требуют Pin для безопасности. Размер future определяется кодом, а не флагами оптимизации — это свойство промежуточного представления компилятора, которое LLVM уже не меняет.
Выводы автора:
- Размер асинхронной функции зависит исключительно от области видимости переменных: обернув буфер в фигурные скобки, вы можете сократить её с килобайта до 2 байт
- Компилятор автоматически переиспользует память для разных переменных, если их времена жизни не пересекаются, но это нужно правильно выражать в коде
- Уровни оптимизации не влияют на размер future — раскладка определяется в промежуточном представлении rustc, задолго до LLVM
Размер future — свойство вашего кода, а не настроек сборки. Рычаг здесь один, и он в том, где вы объявляете переменные и когда они умирают.
Оригиналы:Ваш future весит два килобайта, и виновата одна фигурная скобка
Паттерны реал-тайм коммуникации для собеседований по системному дизайну
Разработка и архитектура · Ashish Pratap Singh · 9/10
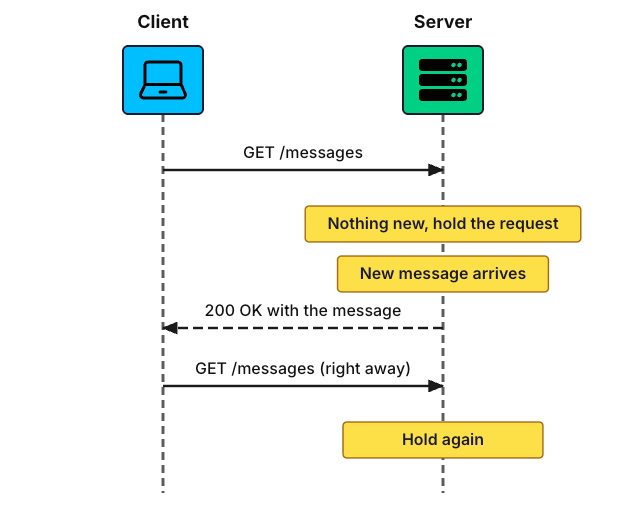
Материал разбирает четыре основных подхода к доставке обновлений в реальном времени: Long Polling, Server-Sent Events (SSE), WebSockets и Webhooks. Каждый метод решает проблему получения данных без ожидания инициирующего запроса клиента, но с разными компромиссами. Long Polling использует стандартный HTTP и прост в реализации, но требует частых запросов с полными заголовками и имеет промежутки между подключениями.
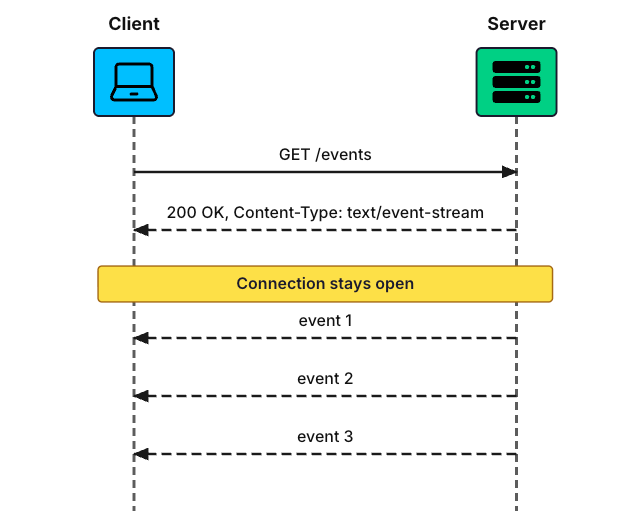
SSE поддерживает открытое соединение для односторонней передачи от сервера к клиенту и используется для потоковой передачи от LLM, уведомлений и мониторинга.
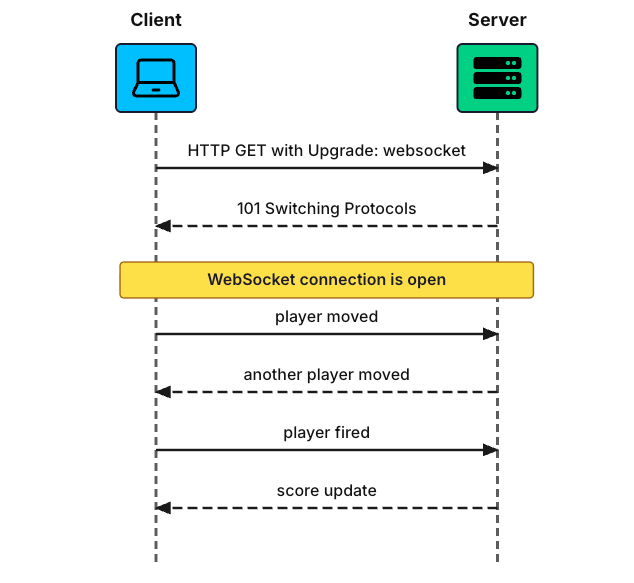
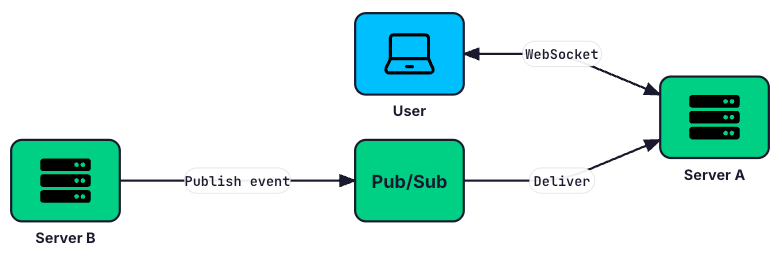
WebSockets обеспечивают двусторонний обмен в реальном времени с низкой задержкой и идеальны для чатов, игр и совместного редактирования, но требуют сложной инфраструктуры масштабирования с брокерами сообщений для маршрутизации между серверами.
Webhooks предназначены для асинхронной коммуникации между бэкенд-системами через HTTP POST без постоянного соединения; требуют правильной обработки повторных попыток, идемпотентности и аутентификации через подписание запросов.
Выводы автора:
- Выбор подхода зависит от паттерна коммуникации: Long Polling для редких обновлений, SSE для одностороннего потока данных, WebSockets для интерактивного двустороннего обмена, Webhooks для уведомлений между системами.
- WebSockets обеспечивают минимальную задержку и двусторонний обмен, но требуют значительной оперативной сложности при масштабировании до миллионов соединений с использованием pub/sub инфраструктуры.
- Webhooks должны быть идемпотентными, иметь механизм повторных попыток и подписание запросов для безопасности, так как они выполняют HTTP POST во внешние системы.
WebSockets — это естественный выбор, когда обе стороны должны часто общаться в реальном времени с низкой задержкой, но эта мощность требует большей операционной сложности при масштабировании.
Оригиналы:Паттерны реал-тайм коммуникации для собеседований по системному дизайну
Electron E1: потоковый процессор в 100 раз эффективнее ARM
Разработка и архитектура · Habr · 8/10
Стартап Efficient Computer представил инновационный процессор Electron E1, разработанный с целью решить проблему энергоэффективности вычислений. На типичных задачах (быстрое преобразование Фурье, свёртки нейросетей) E1 показывает производительность в 10–100 раз выше, чем ARM-процессоры. Причина успеха — переход от классической архитектуры фон Неймана к потоковой архитектуре (CGRA), которая минимизирует перемещение данных между памятью и вычислителями. Архитектура E1 состоит из плиток (упрощённых ядер), соединённых программируемой сетью Fabric; компилятор effcc распределяет программу не только во времени, но и в пространстве чипа, что исключает затраты на выборку инструкций и предсказание ветвлений. E1 уже проходит бета-тестирование среди разработчиков через веб-песочницу Compiler Playground, а участники программы получают готовые отладочные комплекты EVK для embedded-систем. Похожий подход используют TPU от Google и Inferentia от Amazon, но E1 отличается поддержкой произвольных рекурсий и лучше подходит для вычислений общего назначения.
Выводы автора:
- Потоковая архитектура E1 устраняет узкое место фон Неймана, минимизируя дорогостоящие перемещения данных между памятью и процессором, что критично для ИИ-вычислений и обучения LLM.
- Компилятор Electron E1 автоматически распределяет программный код по пространству микросхемы, требуя от программиста только разметки функций, что упрощает разработку без специальных навыков.
- Спрос на энергоэффективные процессоры нового поколения с архитектурой «memory-first» растёт, порождая конкурентный рынок решений для edge-вычислений и потенциально дата-центров.
Основные энергетические затраты в работе ИИ приходятся на передачу данных между памятью и процессором, а не на сами вычисления.
Оригиналы:В 100 раз эффективнее ARM: потоковый процессор Electron E1
Дефицит CPU в облачных сервисах из-за бума ИИ-агентов
Разработка и архитектура · The Pragmatic Engineer · 8/10
Мир IT столкнулся с новой волной нехватки ресурсов: после дефицитов GPU и памяти теперь не хватает процессорных мощностей в облачных провайдерах. Причина – ИИ-агенты потребляют значительно больше CPU при использовании инструментов (компиляция, тестирование, линтинг кода). Раньше облачные провайдеры могли предлагать скидки до 90% на неиспользуемые вычисления через spot-pricing; теперь этого больше нет, так как спрос постоянно превышает предложение.
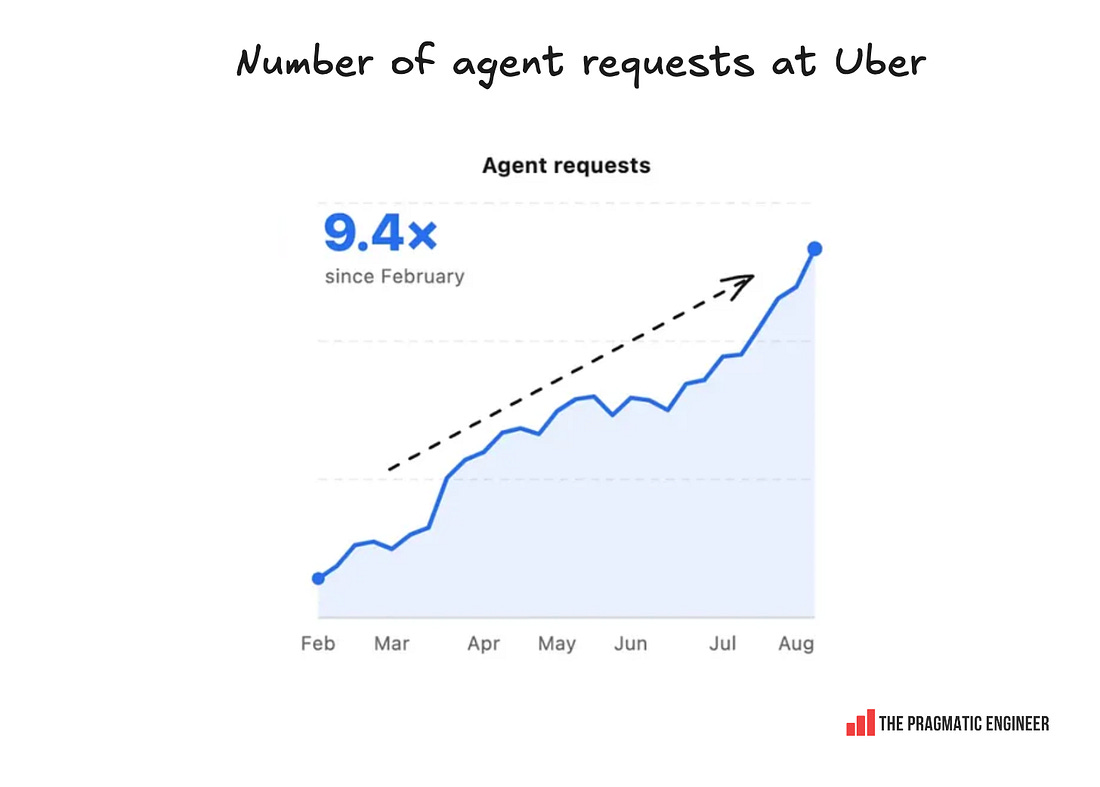
Даже крупные компании вроде больших inference-провайдеров и Uber испытывают трудности с резервированием CPU мощностей – облачные провайдеры отказывают даже компаниям с достаточным бюджетом. Соотношение CPU к GPU в ИИ-дата-центрах изменилось с 1:8 на 1:4 и может дойти до 1:1. Проблема усугубляется тем, что TSMC загружена производством GPU, а производители памяти (SK Hynix, Samsung, Micron) приоритизируют High Bandwidth Memory вместо обычной DRAM. Резервирование CPU требует планирования на 12 месяцев вперёд вместо стандартных 1-2 недель, цены выросли на 10-20%. Рекомендация: начать планирование CPU-ёмкости прямо сейчас и оптимизировать использование существующих ресурсов.
Выводы автора:
- Спрос на CPU в облачных провайдерах резко возрос благодаря ИИ-агентам, использующим инструменты, требующие интенсивного CPU-времени, и теперь даже крупные компании борются за доступ к мощностям.
- Традиционный spot-pricing для CPU практически исчез из-за постоянной нехватки, требуя от компаний резервировать ёмкость за 12 месяцев вперёд по повышенным ценам.
- Необходимо срочно переосмыслить подходы к capacity-планированию, оптимизировать текущую CPU-нагрузку и рассмотреть фиксированные выделения мощности вместо динамического масштабирования на основе спроса.
Даже крупные компании борются друг с другом за право получить выделения CPU. Я предполагаю, что ситуация станет намного хуже, прежде чем улучшится.
Оригиналы:The Pulse: дефицит CPU – новый тренд
Управление интеллектом как фидуциарным активом: зрелость в эру ИИ
Данные и аналитика · CXO Insights | Modern Data 101 · 8/10
Интервью с Нехой Пурохит, SVP глобальных информационных систем United Talent Agency, о переопределении зрелости данных-организации в эпоху ИИ. Главная идея: истинная зрелость — это не количество технологий, а способность генерировать правильные решения и управлять контекстом как активом компании. Автор рассказывает о критическом кейсе, когда инфраструктура показывала зелёные метрики (99,99% uptime, задержка <50ms), но доход на вывод упал на 2% в месяц ($14 млн убытков за 6 месяцев) из-за деградации контекста и семантического дрейфа. Она вводит концепцию Context Debt (долг контекста) как финансовый обязательство руководителя данных перед советом директоров и предлагает её количественное измерение. Ключевые практики: картирование данных по трём уровням (Experimental, Operational, Auditable), система маршрутизации компьютных ресурсов (3-Zone Compute Routing), Trust Telemetry для мониторинга семантического здоровья, Decision Capsules вместо дашбордов, Federated Velocity Model для управления shadow data, найм лидеров с когнитивным разнообразием. На примере Ciena, Philips Healthcare и UTA показано, как эти подходы сэкономили и оптимизировали сотни миллионов долларов.
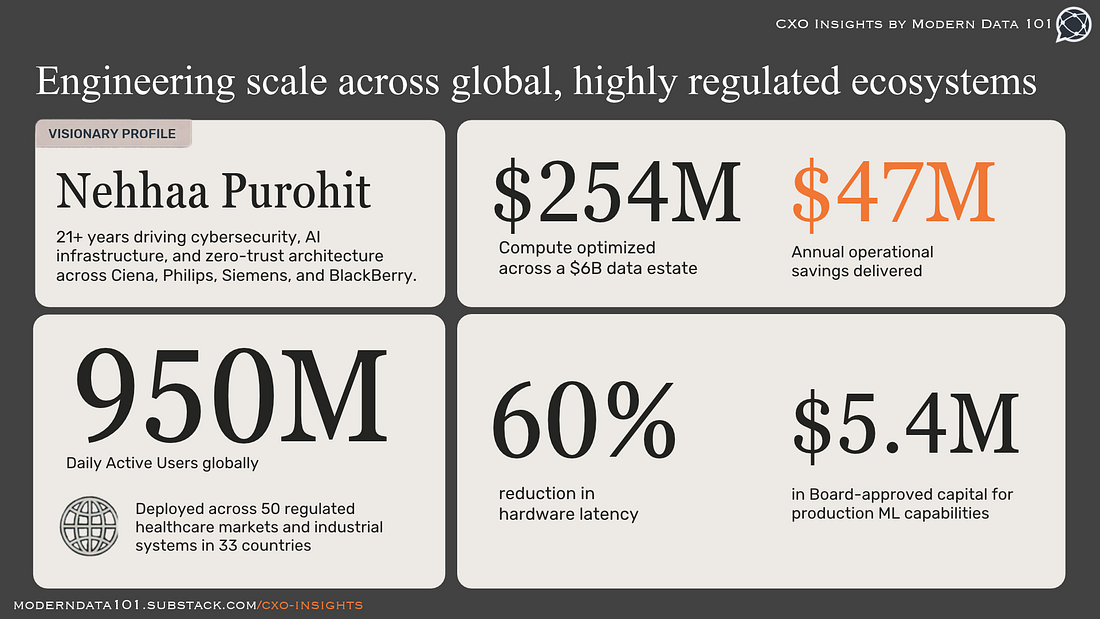
Выводы автора:
- Истинная зрелость данных-организации измеряется не сложностью технологий, а способностью превращать интеллект в финансовую ценность и управлять контекстом как фидуциарным активом.
- Семантический дрейф и деградация контекста — главные скрытые причины потерь бизнес-стоимости, которые не видны стандартным инструментам мониторинга инфраструктуры.
- Управление shadow data как инновационным конвейером с глобальным контролем семантического выравнивания эффективнее, чем попытки его запрета.
Истинная зрелость в 2026 году требует фидуциарного лидерства в технологиях. Мой долг перед советом директоров — не просто держать системы в работе, а обеспечить, что капитал, потраченный на вычисления, приносит бизнес-ценность.
Оригиналы:Manage Intelligence as a Fiduciary Asset: Redefining Maturity in the AI Era
Три ложных решения в работе с данными, которые создают долги
Данные и аналитика · Substack · 7/10
Материал разбирает три распространённых ошибки в управлении данными, которые кажутся быстрыми решениями, но на деле усугубляют ситуацию. Первая ошибка — исправлять бизнес-логику на уровне SQL в хранилище данных вместо того, чтобы исправить источник; это ведёт к техдолгу и необходимости постоянно синхронизировать изменения логики в разных местах. Вторая — добавлять слишком много проверок качества данных, которые становятся шумными и игнорируются командой; правильнее агрегировать некритичные проверки в дашборды и рассматривать их в рамках более крупных инициатив, например работы над опозданиями пайплайнов. Третий пункт в материале остаётся незавершённым. Автор подчёркивает, что правильный подход — решать проблемы у источника данных, а не в слое хранилища, и рационально балансировать мониторинг качества.
Выводы автора:
- Исправлять данные нужно в источнике их создания, а не в слое SQL хранилища, чтобы избежать техдолга при изменении логики.
- Избыток проверок качества данных становится контрпродуктивным; лучше агрегировать менее критичные проверки и связывать их с более крупными проектами.
Намного эффективнее добиться того, чтобы исходная команда обеспечивала правильность данных в месте их создания, а не в хранилище данных.
Оригиналы:SeattleDataGuy: О ложных решениях в работе с данными
Жизненный цикл данных: от создания к удалению
Данные и аналитика · ByteByteGo · 7/10
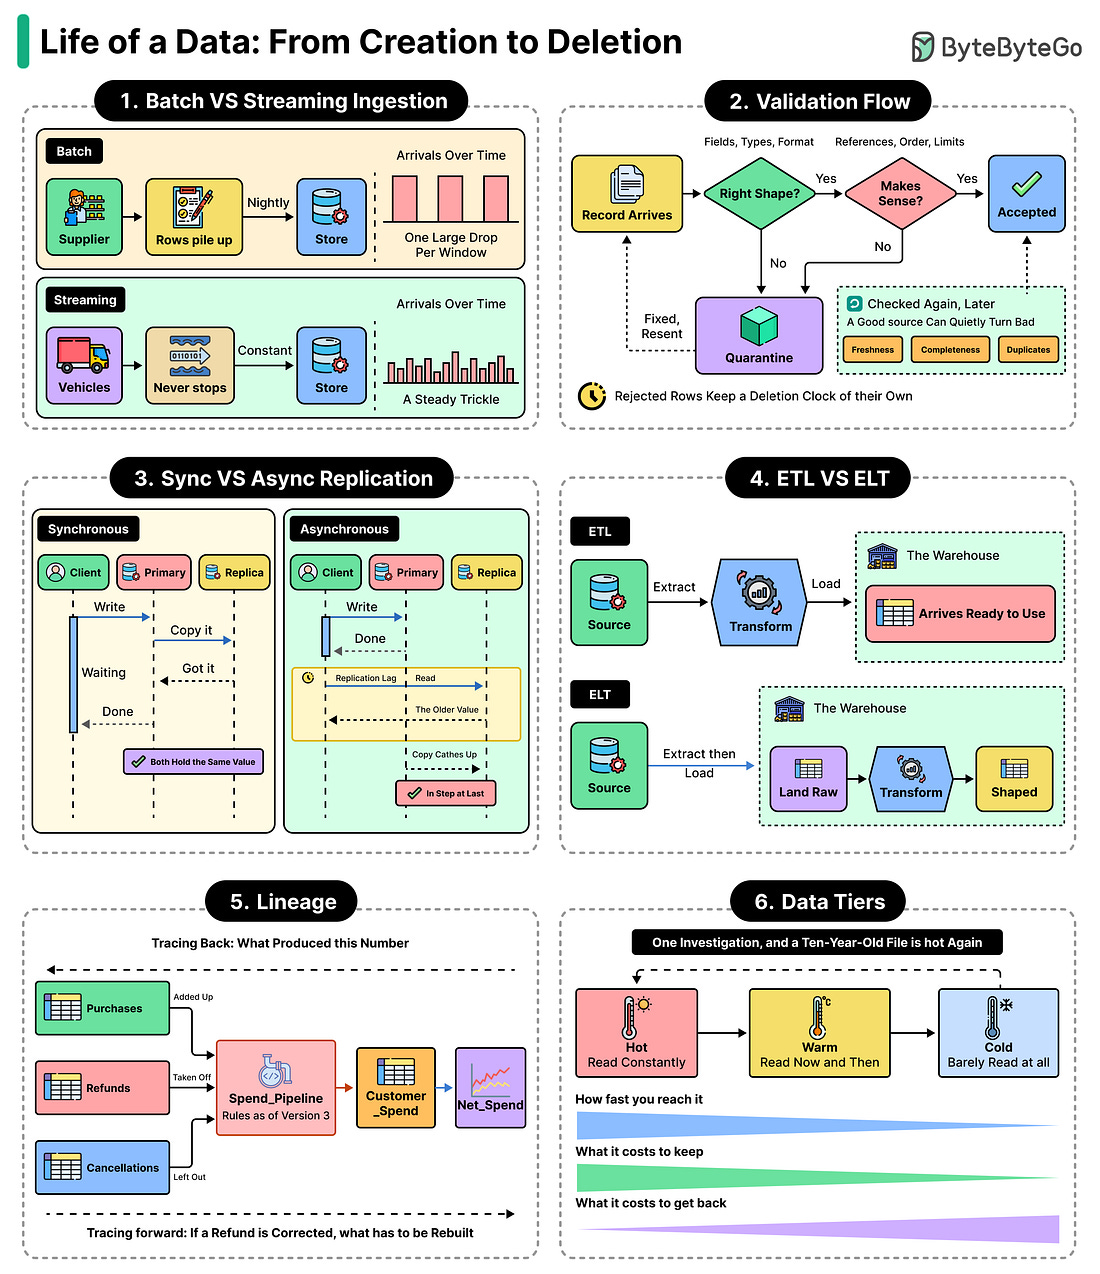
Материал рассматривает полный жизненный цикл данных в системах от момента создания до удаления. На первый взгляд процесс кажется простым: пользователь отправляет форму, приложение сохраняет информацию, позже её можно увидеть или удалить. Но в растущих системах один и тот же информационный элемент существует во множественных копиях одновременно: в основной базе данных, в кеше для быстрого доступа, в индексах поисковых систем, в аналитических пайплайнах для отчётов и в резервных копиях старых версий. Каждая из этих копий имеет собственное назначение, график обновления и время жизни в системе. Понимание полного жизненного цикла данных помогает связать воедино решения, которые обычно рассматриваются отдельно: проектирование базы данных, производительность, отчётность, затраты на хранение, восстановление после сбоев и вопросы приватности.
Выводы автора:
- Данные в системе существуют одновременно в нескольких местах (БД, кеш, поиск, аналитика, резервные копии), и каждый источник имеет свой жизненный цикл
- Осознание полного жизненного цикла данных позволяет интегрировать различные архитектурные решения в единую целостную картину
Информация может войти в систему, стать полезной, распространиться на другие компоненты, устаревать и в конце концов быть удалённой.
Как Ростелеком будет следить за сотрудниками: разбор DLP-системы
Кибербезопасность · Habr · 7/10
Статья разбирает техническое задание Ростелекома на закупку расширенной DLP-системы (системы предотвращения утечек данных) для контроля не менее 5000 рабочих станций. Автор анализирует, что скрывается за официальной риторикой защиты данных, и описывает реальные возможности планируемого решения. Система будет работать по трём эшелонам контроля. Первый — перехват всех внешних каналов связи: корпоративная почта, облачные хранилища, мессенджеры (Telegram, Яндекс.Телемост), поисковые запросы и соцсети. Второй — фиксация всего, что происходит на рабочем столе: кейлоггер (перехват клавиатуры), мониторинг буфера обмена, скриншоты, съёмка экрана, учёт USB-устройств. Третий — форензика и предиктивная аналитика: анализ графов взаимодействия сотрудников, выявление аномалий, OCR для распознавания текста на картинках и даже попытки вскрытия запароленных архивов через словарный брутфорс. Особенно важный момент: система отслеживает не только отправленные сообщения, но и удалённые или стёртые черновики. Каждый введённый символ попадает во внутренний буфер агента в момент печати. Архитектура включает Windows-агентов, Linux-серверы RedOS, PostgreSQL-базу для хранения событий и требует сертификата ФСТЭК не ниже 4-го уровня доверия. MacOS в списке поддерживаемых ОС отсутствует, что автор связывает с закрытым подходом Apple к системе.
Выводы автора:
- Ростелеком разрабатывает не просто защиту от утечек, а полноценный контур превентивного наблюдения за поведением сотрудников с анализом даже удалённых сообщений и чёрновиков.
- Система способна отслеживать каждый вводимый символ в реальном времени, анализировать графы социальных связей между сотрудниками и попытаться вскрывать защищённые архивы.
- Подобные решения уже применяются на практике в компаниях, хотя традиционные программы-шпионы менее функциональны и могут пропустить некоторые действия.
Каждый введённый символ падает во внутренний буфер агента в тот момент, когда вы его напечатали. Удалили сообщение или закрыли вкладку? В DOM-дереве браузера текст исчез, но в локальной базе агента уже сохранен лог.
Оригиналы:Полный текст статьи на Habr
Антифрод 3.0: синергия МВД, банков и регуляторов в борьбе с мошенничеством
Финтех и финансы · Б.О: Технологии · 8/10
На XXIII Международном банковском форуме АБР обсуждался прогресс в противодействии финансовому мошенничеству и перспективы третьего законодательного пакета «Антифрод 3.0». Банк России зафиксировал снижение на 7–8% количества и объёма мошеннических операций без согласия клиентов, а также сокращение среднего чека с 18,6 до 15,5 тыс. рублей. Антифрод-системы коммерческих банков блокируют 97–99% попыток мошенничества: за первое полугодие предотвращено хищений на сумму 3,7 трлн рублей при 34 млн попыток. Ключевой механизм успеха — быстрый обмен риск-индикаторами между банками прямо в протоколах транзакций, совместное выявление новых паттернов мошенничества и координация экспертного сообщества. МВД пресекло разработчиков вредоносного приложения NFCGate для перехвата NFC-трафика, приложение заблокировано на сетях связи. Вопрос возврата похищенных средств частично решён через двухуровневую систему: более 15,5 тыс. человек вернули почти 650 млн рублей. В «Антифрод 3.0» обсуждается около 23 мер, включая ужесточение оборота средств связи, запрет субдилерства SIM-карт, использование отечественных SIM-карт для мессенджеров и дальнейшее регулирование финансовых инструментов.
Выводы автора:
- Антифрод-системы блокируют 97–99% мошеннических транзакций благодаря синергии быстрого обмена информацией между банками, оперативному выявлению новых угроз и координации экспертного сообщества.
- Эффективность достигнута через интеграцию риск-индикаторов в протоколы транзакций, что позволяет банкам оценивать платежи ещё до одобрения.
- Третий пакет мер должен включить ужесточение регулирования средств связи, запрет субдилерства и повышение ответственности мессенджеров для предотвращения потребительского экстремизма.
Банк мыслит категорией "счастье клиента". А клиент не может быть счастлив, если у него украли деньги. Для банка это главный приоритет.
Оригиналы:Добрая воля и неотвратимость
Как BSS стала лидером рынка решений АУСН для банков
Финтех и финансы · Б.О: Технологии · 8/10
Интервью с руководителем направления цифровых продуктов BSS Юлией Саввиновой о развитии автоматизированной упрощенной системы налогообложения (АУСН) в банковском секторе. Компания BSS взялась за разработку модуля АУСН в 2022 году, когда регулятор только начинал пилотирование режима в четырех регионах, и стала первопроходцем на этом рынке. За четыре года количество компаний на АУСН выросло с 20 тыс. (2022) до около 500 тыс. (2026), что заставило банки включиться в гонку за получением статуса уполномоченных кредитных организаций. Сейчас на рынке работают четыре вендора, контролирующие 80% внедрений; BSS имеет установку у десяти банков, включая системообразующие. Основные вызовы при разработке — необходимость глубокой экспертизы в налогообложении и банковской автоматизации, правильная разметка транзакций, соответствие требованиям ФНС. Ключевое преимущество BSS — встроенность модуля в собственную ДБО и внимание к UX/CX, а также система администрирования на стороне банка, разрабатываемая компанией.
Выводы автора:
- Первопроходцы в нише устанавливают стандарты: BSS долгое время был единственным вендором, что позволило сформировать эталонный подход к решениям АУСН и выиграть в конкурентной борьбе.
- Рынок АУСН вырос экспоненциально: доля вендорских решений изменилась с 20% на старте пилота до 80% в 2026 году, что отражает масштаб государственной инициативы и её влияние на банковский сектор.
- Интеграция с базовым функционалом ДБО критична для качества: обычные ошибки в разметке транзакций связаны с неточными настройками алгоритмов, а решение BSS минимизирует их через встроенную автоматизацию и возможность ручной настройки.
Начиная с нуля, можно устанавливать правила — и тот, кто начинает первым и долго остаётся единственным вендором в нише, отчасти формирует подходы и задаёт вектор реализации продукта.
AI-модель андеррайтинга Affirm работает лучше для заёмщиков без FICO
Финтех и финансы · Linas from Linas's Newsletter · 7/10
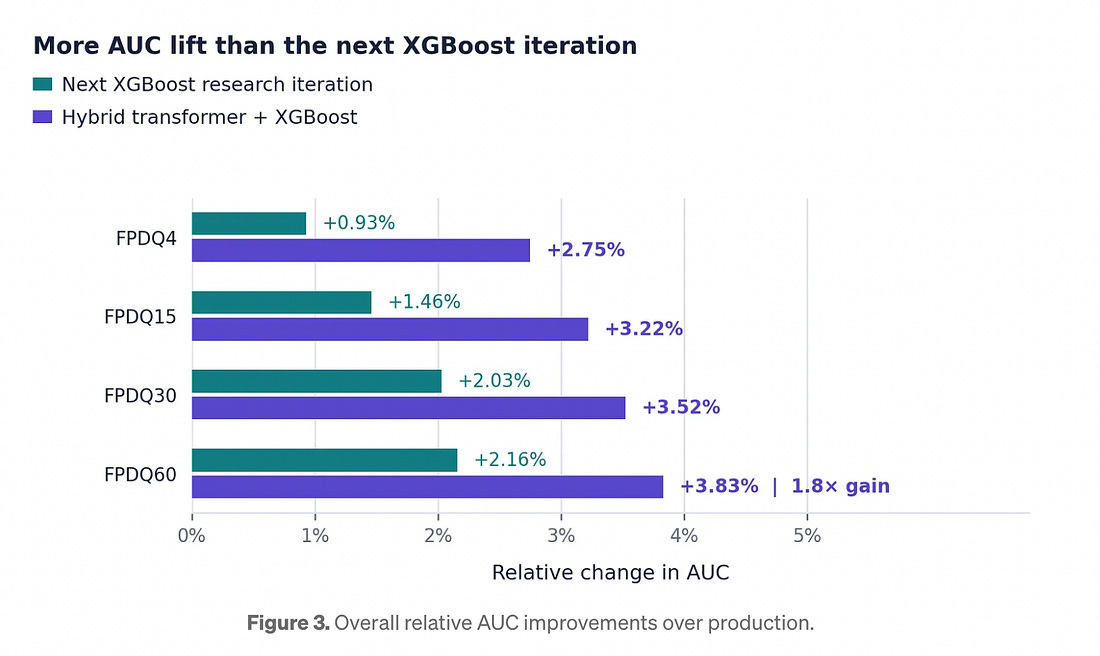
Материал разбирает новую AI-модель андеррайтинга Affirm на основе трансформера, которая внедрена на этапе checkout и показывает наибольший прирост среди заёмщиков без FICO-скора. Модель использует кредитные данные, которые уже есть у Affirm, и обеспечивает 3,4% увеличения завершённых покупок, однако это число получено при более узком тесте, чем заявлено в пресс-релизе. Автор обещает разобраться, как модель интегрируется в кредитный стек Affirm, откуда берётся конкурентное преимущество и какие показатели действительно подтверждены. Также обещаны бонус-разборы финансовых результатов Affirm, платформы Revolut PRAGMA и построения агентной ОС на Claude Fable 5. Отдельный блок посвящён тому, почему Apple и Google нанимают специалистов по стейблкоинам с разных концов платёжного стека: Apple ищет стратега платежей, Google — архитектора Web3 в Гонконге, оба интересуются токенизированными депозитами.
Выводы автора:
- Новая AI-модель Affirm показывает максимальный прирост именно на заёмщиках без FICO-скора, используя собственную кредитную историю платформы
- Apple и Google активно нанимают специалистов по стейблкоинам, но не планируют выпускать собственные валюты вроде iCoin или Google Dollar
Трансформер теперь работает на американском checkout и добивается наибольших успехов у заёмщиков без FICO-скора, используя кредитные данные Affirm
Оригиналы:Основная статья про AI-модель Affirm и стейблкоины · Последние финансовые результаты Affirm · Как Google создаёт интерфейс между AI и деньгами
Банковский форум АБР: консенсус оптимистов несмотря на вызовы
Финтех и финансы · Б.О: Экономика · 7/10
На банковском форуме АБР в Санкт-Петербурге регулятор и крупнейшие банкиры озвучили оптимистичную позицию относительно состояния российского банковского сектора, несмотря на внешние давления и регуляторные ужесточения. Председатель комитета Госдумы Анатолий Аксаков указал на рост просрочки в розничном, корпоративном сегментах и особенно в МСП, однако главы Альфа-Банка и ВТБ не согласились с этой оценкой — малый бизнес, по их мнению, улучшил качество обслуживания долга. Председатель Банка России Эльвира Набиуллина отметила, что прибыль в экономике относительно ВВП находится на уровне 2017–2019 годов, а банковский сектор может показать по итогам года прибыль, близкую к рекордным уровням. По вопросу ликвидности участники форума единодушно заявили об отсутствии кризиса — речь идёт о структурных изменениях в источниках фондирования, а не о реальных проблемах с исполнением обязательств. Набиуллина подчеркнула, что регуляторные ужесточения обеспечивают банковский сектор капиталом и оказывают сдерживающее, но не охлаждающее влияние на кредитование, которое продолжает расти и служит залогом финансовой устойчивости.
Выводы автора:
- Несмотря на внешние давления и регуляторные ужесточения, российский банковский сектор демонстрирует устойчивость с адекватным капиталом и растущим кредитованием.
- Текущие проблемы с ликвидностью — это структурные движения по источникам фондирования, а не признак системного кризиса.
- Экономика показывает хороший финансовый результат на уровне докризисного периода 2017–2019 годов с потенциалом для расширения кредитования без избыточных рисков.
Кредитование продолжает расти, несмотря на ужесточения. Оно оказывает сдерживающее влияние, но не охлаждающее до того уровня, при котором кредитование перестает показывать положительную динамику.
Оригиналы:Осенний консенсус оптимистов
От нефтяной иглы до китайской розетки: энергетическая зависимость
Экономика · РЭШ · 7/10
Подкаст «Экономики на слух» разбирает глобальную энергетику с экспертом Татьяной Митровой из Центра глобальной энергетической политики Колумбийского университета. На мировые энергорынки обрушился критический шторм: ситуация в Ормузском проливе и другие кризисы становятся реальностью, однако мировая экономика удивительно хорошо переносит потрясения. В эпизоде анализируется поведение ключевых игроков энергорынка, включая Россию, и противостояние между традиционной нефтегегемонией и электрической мощью. Особое внимание уделено растущему влиянию Китая: страна уже выступает регулировщиком спроса на нефть, расширяет позиции на газовом рынке и доминирует в секторе зеленой энергетики. Обсуждаются технологии, способные радикально переформатировать мировую энергетику и экономику в целом. Дополнительно рассматривается методология контрфактических исследований в экономике на примере работ профессора Ивана Королева из Бингемтонского университета.

Выводы автора:
- Китай трансформировался из потребителя энергии в регулировщика спроса на нефть и мощного игрока на газовом и возобновляемом энергетических рынках
- Современная мировая экономика демонстрирует устойчивость к энергетическим кризисам, включая угрозы в Ормузском проливе
- Контрфактические исследования являются важным инструментом для экономистов при анализе причинно-следственных связей в истории и экономике
Мировую энергетику обрушился идеальный шторм: сценарии, еще недавно казавшиеся апокалиптическими, становятся реальностью
Политика ЦБ: баланс ужесточения регулирования и поддержки экономики
Экономика · Б.О: Экономика · 7/10
Эльвира Набиуллина, глава Банка России, представила на XXIII Международном банковском форуме АБР комплекс мер регулирования, сочетающих ужесточение надзора с поддержкой кредитования. На стороне ужесточения: возврат надбавок к капиталу (отмененных в 2022 году), введение вычетов из капитала для банков с повышенными рисками и переход к риск-чувствительным лимитам концентрации на уровне 25–30% от капитала. На стороне поддержки: использование официального дохода при оценке кредитоспособности заемщиков, льготные коэффициенты для суверенных проектов (объем линий 4 трлн рублей, выдано 1,6 трлн), возможность реструктуризации кредитов. Значимым результатом стало импортозамещение программного обеспечения в банковском секторе, которое сэкономило около 300 млрд рублей. Все переходные процессы реализуются постепенно с согласованием графиков.
Выводы автора:
- ЦБ восстанавливает требования к капиталу банков, отмененные во время кризиса 2022 года, с целью укрепления устойчивости системы к будущим потрясениям.
- Регулятор балансирует между ужесточением надзора и поддержкой кредитования реальной экономики через льготы для суверенных проектов и упрощенную оценку заемщиков по официальному доходу.
Восстановление надбавок необходимо для подушки безопасности и готовности к кризисным ситуациям.
Оригиналы:Политика ЦБ: ужесточение и поддержка
ИИ, полезное трение и потеря суждения в product-разработке
Продукт и карьера · John Cutler from The Beautiful Mess · 9/10
Джон Катлер рассуждает о том, как ИИ автоматизация в product-разработке устраняет «положительное трение» — процессы, которые заставляют думать, обсуждать и принимать осознанные решения. До ИИ каждый шаг (от анализа звонков до шипа фичей) требовал активного участия: синтезирования идей, обсуждения вариантов, выборочного подхода. Теперь можно автоматизировать всё — от обработки тысячи слов обратной связи до генерации спецификаций и кода агентами. Но эта полная автоматизация создаёт проблемы: теряется контекст, оригинальная информация превращается в указатели, возникают сотни «возможностей», которые ни вы, ни клиенты не можете отследить, и вся система становится всё дальше от реальности.
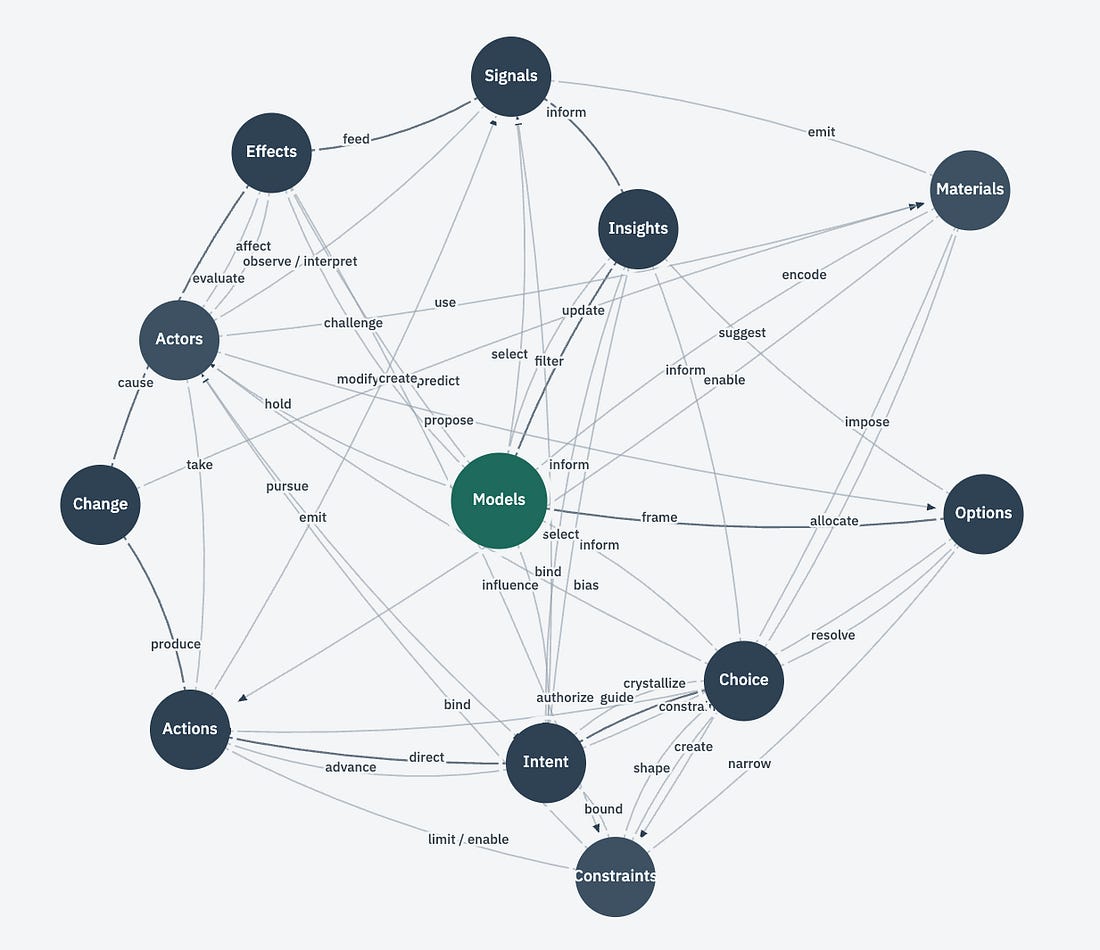
Автор предлагает десять принципов борьбы с этой проблемой: сохранять атомарность исходной обратной связи с линками на источники, добавлять трение при преобразовании контента, разделять подлинную задачу от её представления разным аудиториям, маркировать AI-контент, избегать многоуровневой AI-обработки, не превращать инструменты в свалки, рассматривать анализ кода как один из источников свидетельств, использовать Linear для ясного командного намерения, предпочитать глубину широте улучшений, и признать двойственность инструментов планирования.
Выводы автора:
- Полная автоматизация product-работы с ИИ может привести к потере критического суждения, контекста и связи с реальной обратной связью клиентов
- Нужно сохранять намеренное трение на ключевых переходах информации и маркировать AI-сгенерированный контент, чтобы не потерять атомарность и прослеживаемость
- Успешная работа требует баланса между использованием ИИ и активным участием людей в синтезе, выборе и углубленном анализе проблем вместо распыления на сотни поверхностных улучшений
Если вы не можете связать что-то с реальностью, прекратите это делать.
Оригиналы:TBM 441: AI, the Loss of Positive Friction, and What to Do About It
Почему продакт-менеджер тратит больше времени на согласования, чем на разработку
Продукт и карьера · Б.О: Технологии · 8/10
Материал разбирает проблему, почему внедрение новых продуктов в банках отнимает более половины времени на организационные и управленческие процессы, а не на фактическую разработку и исследования. Автор Алексей Павленко, эксперт в платёжных системах, показывает, что команды работают в спринтах 2–4 недели, но их взаимодействие с юридическими, комплаенс-, ИБ- и IT-подразделениями, живущими по собственному таймлайну, создаёт узкие «горлышки» согласования. В крупных банках из топ-10 сталкиваются сотни приоритетов, включая регуляторные требования с жёсткими сроками и задачи по доходности, что усугубляет затор. На Западе применяют три ключевых подхода: сдвиг влево (shift left) — внедрение комплаенс- и security-проверок на ранних стадиях разработки, что сокращает ИБ-инциденты на 70% и ускоряет выход на рынок на 30%; Compliance by Design — встраивание регуляторных требований (GDPR, PCI-DSS, PSD2, SOX) в брифинг до написания кода; разделение обучения и производства — использование синтетических данных для тестирования идей без полного согласования. Автор предлагает три решения для российских банков: вовлечь согласующие структуры в продуктовые направления с персональной мотивацией (например, премии, зависящие от реализованных продуктов), или передать часть процессов вендорам, хотя это несёт риски для безопасности данных.
Выводы автора:
- Более половины времени при внедрении продуктов в банках тратится на согласования с юридическими, комплаенс-, ИБ- и IT-подразделениями, а не на разработку и исследования
- Западные банки решают проблему узких мест через сдвиг влево (ранние проверки), встраивание комплаенса в дизайн и разделение фазы экспериментов от промышленного внедрения
- Российские банки должны вовлечь согласующие структуры в продуктовые команды и мотивировать их премиями, зависящими от успеха продуктовых внедрений
Самый сложный этап в запуске пилота — не сама идея, а получение разрешения на то, чтобы начать его прорабатывать
Оригиналы:Рождение продуктов на спринтé
Как работается в AI-native компании: опыт Lovable
Продукт и карьера · Elena's Growth Scoop · 7/10
Статья основана на личном опыте автора (Elena Verna) более года работы в Lovable — компании, которую она описывает как действительно AI-native, а не просто компанию, использующую AI как инструмент. В отличие от традиционных компаний, где AI — это производительные надстройки к неизменной оргструктуре, Lovable кардинально переосмысляет саму организацию: что такое работа, как люди сотрудничают, кто принимает решения и как движется информация. Компания отказалась от традиционных иерархических титулов (используются только IC, Lead и Head), что устранило политику, привязанную к статусу и доступу к информации. Большинство Slack-каналов открыты, информация не ограничивается цепочкой управления, люди сами выбирают, в какие беседы включаться.
Исследование автора показало, что 71% людей (включая менеджеров) хотят тратить минимум половину времени на индивидуальную работу (IC), а не на управление — и в Lovable это норма: многие очень опытные люди остаются индивидуальными контрибьюторами и счастливы этим.
В компании низкий уровень встреч (менее 20% времени автора), так как контекст легко передаётся через документы, а высокая автономность позволяет двигаться быстро и исправлять ошибки дешевле, чем совещаться о идеальном решении. Одновременно темп работы экстремален — люди переживают полные переорганизации каждые несколько месяцев, роли расплывчаты (людям нравится залезать в чужую работу, но это создаёт дублирование и неясность ответственности), и компания культивирует «ковбойский» менталитет высокоавтономных обобщенцев, готовых делать что угодно в условиях неопределённости. Людей даже вдохновляет автоматизировать собственную работу с помощью AI.
Выводы автора:
- AI-native компании переосмысляют не просто инструменты, но саму организационную структуру: иерархию, управление, потоки информации и определение работы
- Высокая автономность и низкие бюрократические барьеры позволяют быстро двигаться и адаптироваться, но создают стресс от постоянных изменений и размытой ответственности
- Модель, где опытные люди остаются индивидуальными контрибьюторами вместо продвижения в менеджмент, становится нормой и отражает фундаментальное переосмысление карьерных путей в эпоху AI
«Не то что мы используем AI много. Это то, что происходит, когда допущение, что AI — часть всего, начинает менять саму организацию»
Коротко
Разработка и архитектура
- Apple припаяла накопитель Mac mini M6 и M5 Pro, теперь его нельзя менять – Apple закрыла возможность самостоятельной замены накопителя в новых Mac mini с процессорами M6 и M5 Pro, припаяв NAND-память прямо на системную плату вместо съёмного модуля.
Финтех и финансы
- Банк России определил порядок предоставления кредитных отчётов коллекторским органам – Указание Банка России № 7370-У от 15 июня 2026 года устанавливает процедуру передачи кредитных отчётов из бюро кредитных историй в уполномоченный государственный орган, ведающий ре
- Указание Банка России о изменениях в отчётности микрофинансовых организаций – Банк России выпустил указание 29 июня 2026 года (№ 7401-У) о внесении изменений в порядок составления отчётности микрофинансовых и микрокредитных компаний.
Экономика
- Набиуллина: экономика стабильна, но главные риски — кадры и инвестклимат – Председатель Банка России Эльвира Набиуллина на Международном банковском форуме дала анализ состояния отечественной экономики и финансовой системы.
Продукт и карьера
- Минобрнауки изменит требования к вступительным экзаменам в технические вузы с 2027 года – Минобрнауки РФ предложило изменить правила вступительных испытаний в технические вузы с 2027 года.