Дайджест за 24 сентября 2026
На рынке ИИ продолжается ценовая война: OpenAI презентовала вдвое более дешёвые GPT-6 Sol и Luna, а Anthropic выпустила Claude Opus 5.5 на 40% дешевле при 30% ускорении. Параллельно растёт критика недостатков инструментов — от скрытых зависимостей в Ollama до нарастающей угрозы jailbreak-атак, которые всё легче обходят защиту больших языковых моделей. На фоне предполагаемого триллиона долларов инвестиций в ИИ-инфраструктуру до 2050 года безопасность становится критической проблемой: исследователи выявили цепочку атак от уязвимостей в обычных утилитах к полной компрометации облачной инфраструктуры.
Главное
- Критика Ollama: от скрытия зависимостей к деградации функционала
- Jailbreak-атаки на ИИ: основные техники и почему они работают
- Цепочка атаки: от LFR в калькуляторе к полной компрометации облака
- Инвестиции в ИИ до 2050: 31,6 трлн долларов на дата-центры
- OpenAppSec: open-source WAF на базе машинного обучения
Подробно
Критика Ollama: от скрытия зависимостей к деградации функционала
ИИ и агенты · Habr · 9/10
Статья — глубокий анализ проблем проекта Ollama, популярного инструмента для локального запуска LLM. Ollama построила свою репутацию как удобная обёртка над llama.cpp, но годами скрывала эту зависимость, не упоминая создателя проекта Георгия Герганова ни в README, ни в маркетинге, что нарушило условия лицензии MIT. После требования сообщества в 2024 году добавили одну строку в конец README. В 2025 году ситуация ухудшилась: Ollama создала собственный движок на базе GGML, отойдя от llama.cpp. Результат — откат ошибок, исправленных годы назад, и потеря производительности: llama.cpp оказывается в 1,8 раза быстрее на одном оборудовании (161 vs 89 токен/сек). Модели, работавшие в llama.cpp, ломаются в Ollama, включая свежие вроде GPT-OSS 20B. Дополнительные проблемы: вводящие в заблуждение названия моделей (DeepSeek-R1 вместо DeepSeek-R1-Distill), закрытое исходный код десктопного приложения (запущено без лицензии), избыточный Modelfile, который дублирует информацию уже в GGUF-файле и требует копирования 30–60 ГБ при смене одного параметра. llama.cpp остаётся проще, честнее и быстрее.
Выводы автора:
- Ollama систематически преуменьшала роль llama.cpp и нарушала лицензию MIT, признав заслуги создателя только под давлением сообщества
- Собственный движок Ollama работает хуже оригинального llama.cpp: медленнее на 30–80%, не поддерживает новые типы тензоров, регрессирует в функциях
- Дизайн-решения Ollama (Modelfile, переводы шаблонов Jinja в Go, огромное копирование при редактировании) усложняют работу вместо упрощения, в отличие от llama.cpp
Годами они преуменьшали свою зависимость от llama.cpp, а когда наконец решили обойтись без него, получили ухудшенную версию того самого проекта, заслуги которого так не хотели признавать.
Инвестиции в ИИ до 2050: 31,6 трлн долларов на дата-центры
ИИ и агенты · Habr · 9/10
Отчёт PricewaterhouseCoopers прогнозирует беспрецедентный инвестиционный цикл в развитие ИИ-инфраструктуры: с 2025 по 2050 год в дата-центры и оборудование поступит 31,6 трлн долларов (при ускоренном сценарии — 50 трлн), что превосходит все исторические инфраструктурные проекты вместе взятые. Годовые расходы будут расти с 800 млрд долларов в 2026 году до 1,8 трлн к 2050 году. Ключевая особенность: в отличие от прошлых волн (железные дороги, электрификация, интернет), расходы будут не снижаться, а расти, так как оборудование серверов и GPU требует замены каждые 4–6 лет, в то время как здание дата-центра служит 20+ лет. К 2050 году 93% затрат пойдут на замену оборудования, только 7% — на строительство. США получат 48% глобальных инвестиций (15,1 трлн), Азиатско-Тихоокеанский регион — 26% (8,2 трлн), Европа — 18% (5,6 трлн). Среди клиентов дата-центров выделяются гиперскейлеры, разработчики ИИ-моделей, корпорации и государства. Главный вывод: лимитирующий фактор — не капитал, а электроэнергия, сетевое оборудование, доступ к GPU и политическая воля. Рассмотрены два стресс-сценария: ужесточение экспортного контроля на чипы может сократить инвестиции на 6 трлн долларов, а требования суверенности данных перераспределят триллионы между регионами в пользу Азии и Африки.
Выводы автора:
- Инвестиции в ИИ-инфраструктуру беспрецедентны по масштабу и превосходят все исторические инфраструктурные циклы, при этом основной лимит — это электричество и политическая предсказуемость, а не капитал.
- Структура расходов прямо противоположна прошлым волнам: вместо пикового спроса в начале, расходы будут расти до 2050 года из-за необходимости регулярной замены оборудования каждые 4–6 лет.
- В сценарии ужесточения контроля над экспортом чипов рынок недополучит 6 трлн долларов, а в сценарии требований суверенности данных триллионы перетекут из США в Азию и Африку.
Дата-центр — это такая подписка на замену «железа», обернутая в здание.
Оригиналы:Как будет развиваться ИИ до 2050 года: деньги, регионы, сценарии
Anthropic выпустила Claude Opus 5.5: 40% дешевле и 30% быстрее
ИИ и агенты · Habr · 8/10
Anthropic представила Claude Opus 5.5 — первую модель нового семейства Claude 5.5, которая демонстрирует качество уровня Fable 5.1 при значительном улучшении скорости и снижении стоимости. Модель работает на 30% быстрее Opus 5 и обходится на 40% дешевле на типичных задачах. На бенчмарке Terminal-Bench 4.0 она набрала 66,4% против 52,3% у Opus 5, на FrontierCode 1.1 — 54,4%, на CursorBench 4.0 — 57,8%. Для длинных задач по разработке производительность улучшена особенно заметно: ранний пользователь проверил кодовую базу на 200 тысяч строк за три часа вместо более 20 часов на Opus 5, израсходовав в 2,5 раза меньше токенов. Цена API снизилась с 5/25 до 4 долларов за миллион входных и 20 долларов за миллион выходных токенов, кэширование подешевело с 0,50 до 0,20 доллара. Контекстное окно составляет 1 млн токенов с максимальным ответом 128 тысяч. Модель доступна в Claude API, AWS, Google Cloud и Microsoft Azure, но имеет несовместимые изменения: thinking нельзя отключить, а принудительный выбор инструмента через tool_choice вызывает ошибку.
Выводы автора:
- Claude Opus 5.5 предлагает оптимальное соотношение качества, скорости и стоимости для задач по разработке программного обеспечения.
- Модель особенно эффективна для работы с большими кодовыми базами, значительно сокращая время обработки и потребление токенов.
- При переходе на Claude Opus 5.5 необходимо учитывать несовместимые изменения в API, связанные с параметром thinking и tool_choice.
На большинстве рабочих задач она показывает результаты уровня Fable 5.1, при этом генерирует более чем на 30% быстрее Opus 5 и обходится на 40% дешевле на типичных задачах.
Оригиналы:Anthropic выпустила Claude Opus 5.5: на 40% дешевле и более чем на 30% быстрее Opus 5
OpenAI выпустила GPT-6 Sol и GPT-6 Luna — модели в два раза дешевле
ИИ и агенты · Habr · 8/10
OpenAI расширила семейство GPT-6 двумя новыми моделями — GPT-6 Sol и GPT-6 Luna, которые позиционируются как более экономичные альтернативы флагманской GPT-6 Astra. GPT-6 Sol рассчитана на профессиональную работу, программирование, автоматизацию и агентные сценарии, тогда как GPT-6 Luna предназначена для массовых запросов, где стоимость критична. Обе модели наследуют улучшения из GPT-6 Astra в части рассуждений, фактической точности, программирования и взаимодействия с компьютером. Ключевое преимущество — цена: GPT-6 Sol стоит $2 за 1 млн входных токенов и $10 за выходные (вместо $4/$20 для GPT-5.6 Sol), а GPT-6 Luna — $0,10/$0,50 (вместо $0,20/$1,20). На больших объёмах экономия существенна: при 100 млн входных и 20 млн выходных токенов GPT-6 Sol обойдётся в $400 вместо $800 по промо-тарифам GPT-5.6. Снижение цены обеспечено оптимизацией инференса и кэширования, что позволило OpenAI передать часть экономии пользователям. Также новые модели позволяют использовать их в Codex примерно в 1,5 раза больше.
Выводы автора:
- GPT-6 Sol и Luna предлагают вдвое более низкие тарифы по сравнению с промо-ценами GPT-5.6, при сохранении улучшенных способностей в рассуждении и программировании
- Две новые модели рассчитаны на разные сегменты: Sol для профессиональной работы с кодом и агентами, Luna для массовых запросов с приоритетом на стоимость
- Снижение цен достигнуто за счёт оптимизации инфраструктуры инференса и кэширования, что позволяет масштабировать большое количество запросов
GPT-6 Sol и Luna стоят в два раза дешевле промо-тарифов соответствующих моделей GPT-5.6
Оригиналы:OpenAI выпустила GPT-6 Sol и GPT-6 Luna: модели дешевле GPT-5.6 в два раза
Amazon заблокировала Meta Muse, защищая $76 млрд рекламных доходов
ИИ и агенты · Linas from Linas's Newsletter · 8/10
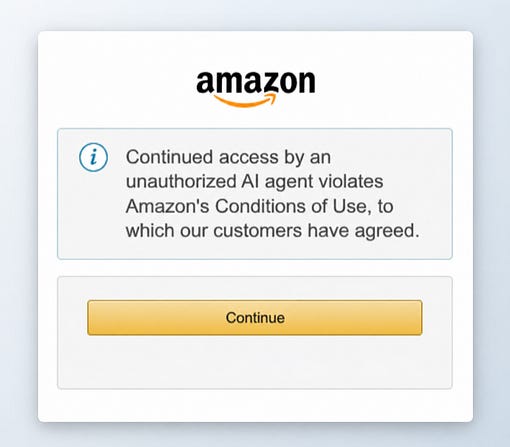
Материал анализирует первый крупный конфликт платформ из-за ИИ-агентов: Amazon заблокировала Meta Muse всего через две недели после запуска, когда приложение стало №1 в App Store США. Официально Amazon ссылается на отсутствие авторизации, но реальная причина — защита $76,1 млрд годовых рекламных доходов, поскольку ИИ-агент, минующий страницу результатов поиска, угрожает каждому доллару этого бизнеса. В то же время Shopify сделала противоположный выбор, открыв Shop Pay для Muse через новую программу Meta connector, указывая на две разные стратегии компаний в отношении агентской коммерции. Материал обещает анализ стратегии Anthropic по агентской коммерции и подробное изучение ИИ-агентов как ОС.
Выводы автора:
- Amazon заблокировала Muse не из соображений безопасности, а для защиты своего $76 млрд рекламного бизнеса, поскольку ИИ-агенты, пропускающие результаты поиска, угрожают рекламным впечатлениям
- Shopify и Amazon выбрали противоположные стратегии отношения к агентской коммерции в одну и ту же неделю, что указывает на начало раскола в подходах платформ к ИИ-агентам
Amazon заблокировала Muse из-за операции без предварительной авторизации, но реальная причина — защита $76 млрд годовых рекламных доходов
Оригиналы:Подписаться на рассылку · ИИ-агент Meta Muse · Программа Meta connector
Как адаптировать языковые модели: LoRA, QLoRA и fine-tuning
ИИ и агенты · ByteByteGo · 8/10
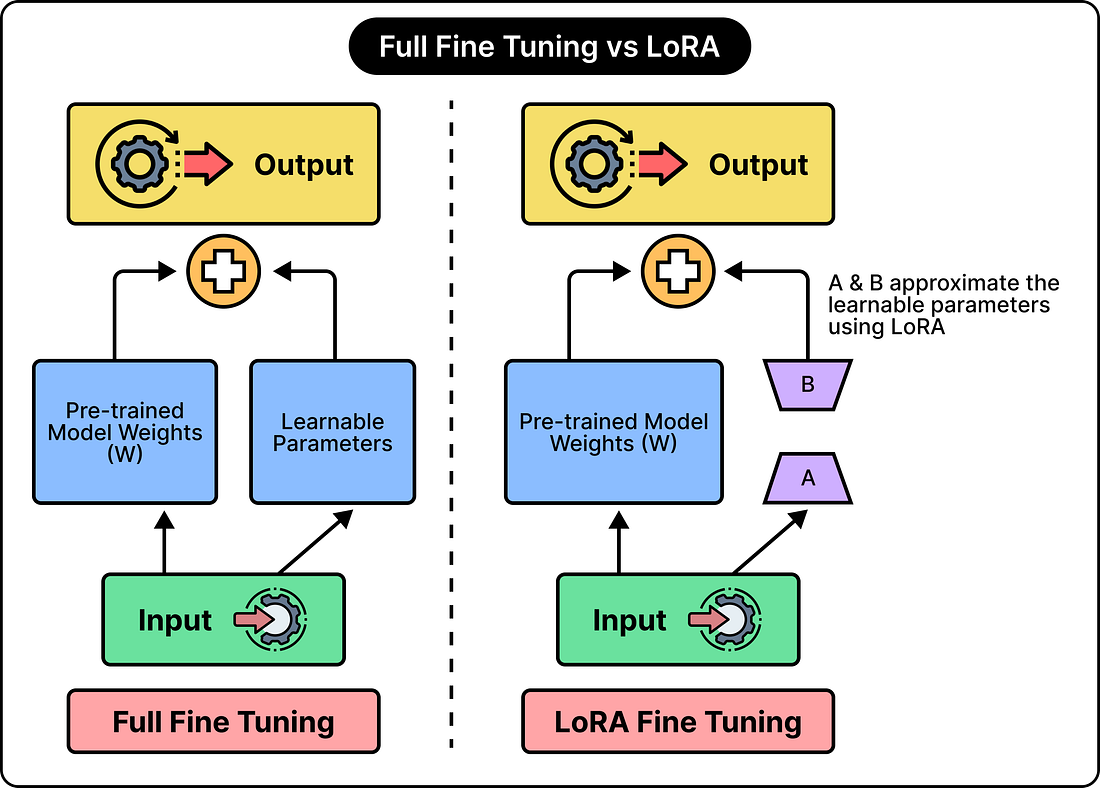
Статья рассматривает стратегии кастомизации языковых моделей для выполнения специфических задач, когда базовые возможности модели недостаточны. Автор объясняет иерархию подходов: сначала улучшение промптов и Few-shot prompting, затем Retrieval-Augmented Generation (RAG) для подачи внешней информации, и наконец fine-tuning для глубокой адаптации модели. Основное внимание уделено двум современным техникам parameter-efficient fine-tuning: LoRA (Low-Rank Adaptation) и QLoRA. LoRA замораживает веса исходной модели, добавляя небольшие обучаемые адаптеры, которые изучают необходимые корректировки через две компактные матрицы. Это снижает требования к памяти и вычислениям без потери качества адаптации.
QLoRA дополнительно оптимизирует процесс, сжимая базовую модель до 4-битного формата, сохраняя адаптеры в более высокой точности. Это позволяет работать с большими моделями на устройствах с ограниченной памятью.
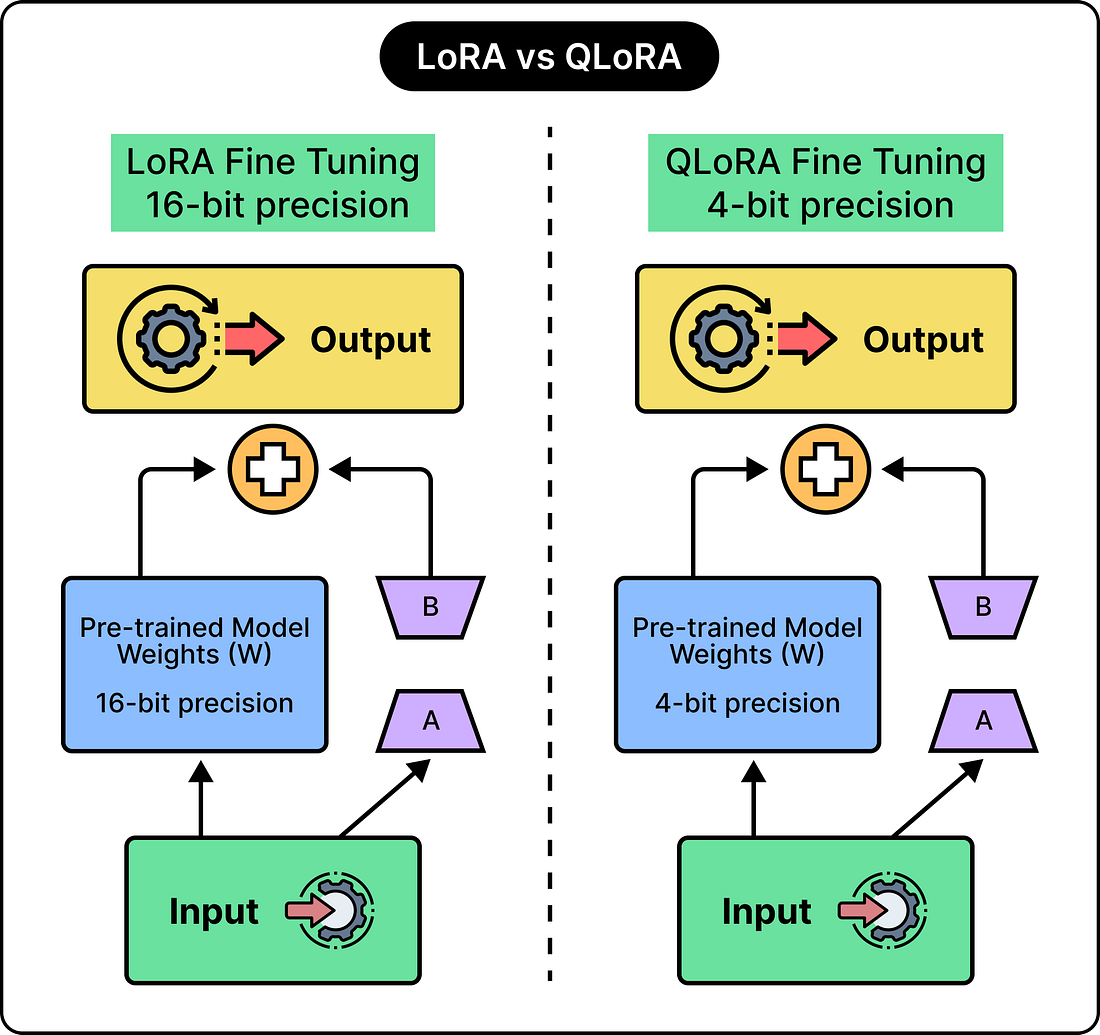
Автор подробно объясняет различие между хранением и вычислениями, показывая, как квантизированные веса реконструируются при необходимости для расчетов. Статья также охватывает основы supervised fine-tuning (SFT) и RLHF для понимания того, как модели обучаются изменять своё поведение на основе примеров.
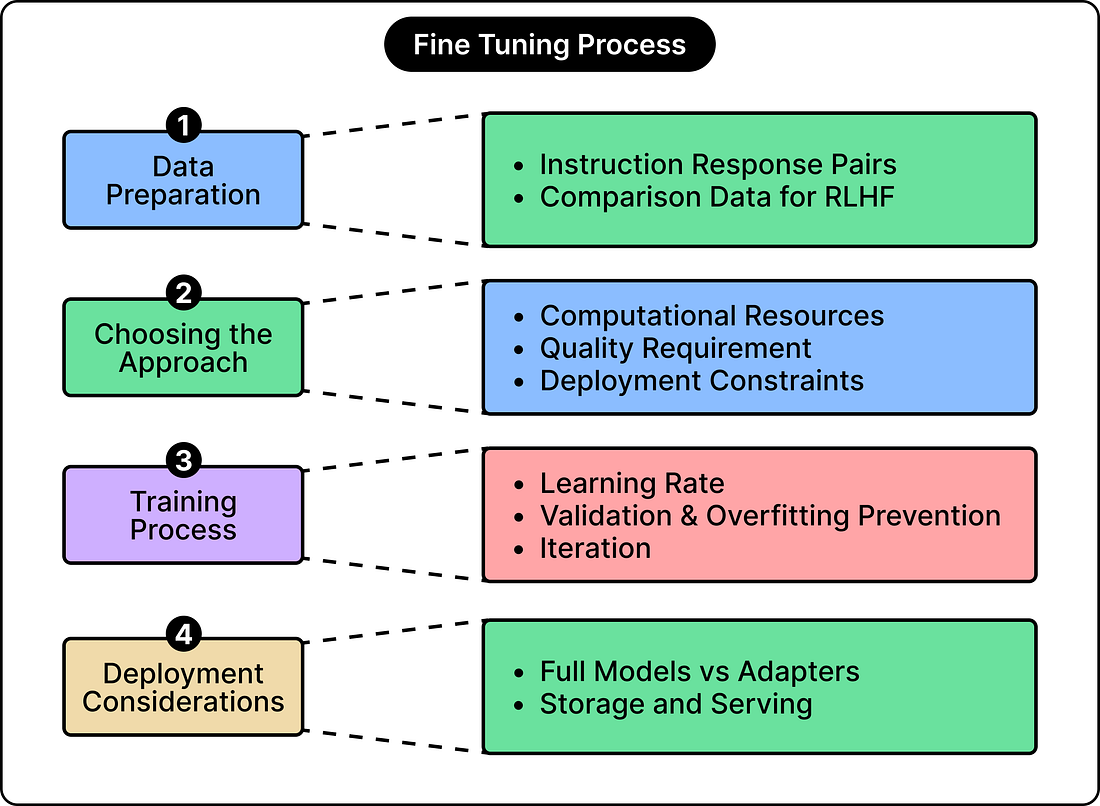
Выводы автора:
- LoRA и QLoRA позволяют эффективно адаптировать большие модели, значительно снижая требования к памяти и вычислительным ресурсам по сравнению с полным fine-tuning
- QLoRA объединяет LoRA с квантизацией, компрессируя базовую модель до 4 бит, что позволяет работать с более крупными моделями на ограниченном оборудовании
- Перед fine-tuning следует проверить возможности простых подходов: улучшение промптов, Few-shot примеры и RAG для внешней информации
Модель уже обладает хорошим пониманием языка, поэтому адаптация к конкретной задаче может не потребовать изменение каждого параметра независимо.
Оригиналы:How to Customize a Model to Learn New Tricks · LoRA: Low-Rank Adaptation of Large Language Models · QLoRA: Efficient Fine-tuning of Quantized LLMs
Почему LLM не заменят человека в дейтинг-аутстаффе
ИИ и агенты · Habr · 7/10
Статья рассказывает о микробизнесе дейтинг-аутстаффа — услуге, когда специалист вручную ведёт переписки в приложениях знакомств от лица клиента и конвертирует матчи в реальные свидания. Автор разбирает, почему попытки автоматизировать этот процесс с помощью LLM неизбежно терпят крах. Главная проблема — синдром «назойливого стажера»: модели генерируют излишне вежливые, натянутые ответы со стереотипным флиртом, которые живой человек распознаёт на третьем сообщении. LLM не умеют удерживать фрейм, вовремя отступать и чувствовать тупиковость диалога на интуитивном уровне. Второй критический недостаток — галлюцинации: модель может выдумать события или места, которых клиент никогда не посещал, что моментально разоблачится при встрече в реальности. Третья проблема — контекстная слепота и неумение считывать скрытые интенции («что ты ищешь?» редко означает буквально то, что написано). Четвёртый фактор — инженерный тупик: дейтинг-платформы намеренно блокируют ботов через фингерпринты и видео-верификацию, а обходить эти защиты с помощью скриншотов модели требует втрое больше ручной работы, чем написать два живых слова. Автор заключает, что пока модели не научатся считывать скрытую агрессию и органично тупить в нужных местах, у живого аутстаффа всегда будет работа.
Выводы автора:
- LLM порождают неаутентичную, синтетичную переписку со стереотипным флиртом и излишней вежливостью, которая распознаётся пользователями почти мгновенно
- Модели совершают фактические ошибки и галлюцинируют события, которые разоблачаются при встрече с реальным человеком, тогда как опытный аутстафф точно знает контекст и ограничения
- Техническое развёртывание автоматизации на дейтинг-платформах фактически невозможно из-за усиленной защиты от ботов и видео-верификации, делая ручную работу экономически оптимальнее
Дейтинг держится не на услужливости. Он держится на способности удерживать фрейм, аккуратно и в рамках подколоть, вовремя развить неочевидную ветку беседы и, самое главное, вовремя отступить.
Оригиналы:Почему LLM никогда не пройдут тест Тьюринга в Tinder: изнанка дейтинг-аутстаффа
Разработчик жалуется на деградацию разработки из-за злоупотребления Claude Code
ИИ и агенты · Habr · 7/10
Разработчик v0xium поделился опытом работы в IT-компании, где ИИ-помощник Claude Code полностью автоматизировал весь цикл разработки: от спецификаций и кода до тестов, задач и отчётов. Проблема не в самом ИИ, а в подходе руководства, которое фокусируется исключительно на объёме выпущенного кода и количестве merged pull requests, заставляя сотрудников работать по 12–13 часов в день, просто нажимая Enter. Инженеры не имеют времени на проверку качества, понимание архитектуры или исправление ошибок; все уровни специалистов (от junior до senior) занимаются одним — общаются с ИИ и выпускают артефакты. Разработчик считает, что это системная проблема всей отрасли: руководство ориентируется на краткосрочные результаты, отказываясь инвестировать в качество и долгосрочную надёжность, а ответственность за код размывается между человеком и ИИ. По его прогнозу, скопление технического долга и беспорядка в кодовых базах станет неизбежным, если отрасль не переосмыслит баланс между автоматизацией и инженерной ответственностью.
Выводы автора:
- Автоматизация разработки через ИИ создаёт риск деградации качества, когда руководство оптимизирует только на скорость выпуска, не давая инженерам времени на проверку и понимание кода.
- Проблема системна и распространяется на весь IT-сектор: компании конкурируют на объём features, создавая неустойчивую архитектуру и накапливая технический долг.
- Отсутствие ответственности и понимания в команде приводит к тому, что никто не может полноценно поддерживать и развивать систему при необходимости исправлений.
Люди работают по 12–13 часов в день, просто чтобы нажимать Enter. Никто ничего не читает. Никто не думает. Всё делает LLM.
Как банк «Центр-инвест» обучает сотрудников и клиентов работе с ИИ
ИИ и агенты · Б.О: Технологии · 7/10
Банк «Центр-инвест» с конца прошлого года системно развивает компетенции в области искусственного интеллекта, позиционируя ИИ как рабочий инструмент, а не абстракцию. В банке создана единая ИИ-платформа с единым шлюзом доступа к моделям с агентными сценариями для сотрудников и обезличиванием данных перед обращением к любой модели. Ключевой принцип: ИИ — инструмент-усилитель, ценность которого раскрывается только в симбиозе с критическим мышлением и персональной ответственностью человека. Банк реализует образовательные программы для госструктур (20 бесплатных интенсивов для 1000+ человек из 40 министерств), обучает более 1200 предпринимателей в рамках федерального проекта, разработал ИИ-платформу «ДАШБОРД «РАЗВИТИЕ РЕГИОНА» для мониторинга 2 млн значений по 4 тыс. показателей. При поддержке банка открыты три центра подготовки при ведущих вузах региона, организованы конкурсы для 1000+ студентов из 21 вуза. Подготовлен учебник «ИИ в ЦИ» и бесплатная онлайн-платформа для самостоятельного обучения.
Выводы автора:
- ИИ следует рассматривать как усилитель человеческих способностей, требующий критического мышления и персональной ответственности пользователя
- Банковский сектор активно инвестирует в развитие ИИ-компетенций не только для своих сотрудников, но и для расширения деловой среды и повышения конкурентоспособности региона
- Практический опыт работы с ИИ-агентами и платформами становится стандартным требованием для госструктур и бизнеса, что требует системного обучения
Интеллект может быть искусственным, но ответственность остается персональной.
Оригиналы:От промпта в письме до ИИ-агентов
Дизайн-инженерия с Maggie Appleton: уроки для разработчиков
Разработка и архитектура · The Pragmatic Engineer · 8/10
Подкаст The Pragmatic Engineer с Maggie Appleton, staff research engineer в GitHub Next, исследует пересечение дизайна и инженерии. Магги работает над тем, как инженеры могут сотрудничать с ИИ-агентами, и делится практическими выводами из опыта в стартапах Elicit и Normally. Ключевые идеи: дизайн-инженеры решают задачи, как и программисты, но используют другие материалы; понимание инженерных ограничений улучшает взаимодействие с командой; физические эскизы в тетради часто эффективнее, чем текстовые описания для ИИ-агентов. Магги создаёт "jigs" — интерактивные прототипы с ползунками и цветовыми палитрами для оптимизации работы с агентами в реальном времени. Важная проблема: "capability gaslighting" — когда модели убеждают пользователей в компетентности, но затем ошибаются на одной и той же задаче. Магги подчёркивает, что человеческое суждение, стиль и физические артефакты остаются критичными даже при растущих возможностях ИИ.
Выводы автора:
- Дизайн и инженерия — родственные дисциплины, основанные на решении проблем; дизайн-инженеры должны понимать инженерные ограничения для эффективного сотрудничества.
- Физические эскизы и прототипы часто более эффективны для работы с ИИ-агентами, чем текстовые спецификации, так как сохраняются в контексте лучше.
- Необходимо остерегаться "capability gaslighting" при работе с моделями и агентами — человеческое суждение и критическое мышление остаются незаменимы.
Есть мир, в котором живут агенты — веса, модели, навыки, MCPs. А затем ваш человеческий мир — физичность, текстура, свет и материалы. Найти артефакты, которые позволяют встретиться посередине — действительно сложная задача.
Оригиналы:Design Engineering with Maggie Appleton · Maggie Appleton · GitHub Next
Один бильярдный шар может выполнить любое вычисление
Разработка и архитектура · Habr · 7/10
Математики Ева Миранда и Исаак Рамос доказали, что один шар, отскакивающий внутри двумерного бильярда специальной формы, способен имитировать универсальную машину Тьюринга и теоретически выполнить любое вычисление. В их модели положение шара кодирует информацию, а геометрия стенок определяет ход вычисления — траектория шара буквально является алгоритмом. Ключевое отличие от предыдущих работ: система требует только одну частицу в двух измерениях с неподвижными стенками, тогда как раньше нужны были несколько шаров, три измерения или движущиеся границы. Бильярд наследует и ограничения машины Тьюринга, включая проблему остановки — невозможно создать универсальный алгоритм, определяющий, остановится ли любая программа. Исследователи спроектировали стол так, что состояние остановки соответствует удару шара под прямым углом; если вычисление бесконечно, траектория никогда не повторится. Хотя на практике невозможно обеспечить необходимую точность из-за физических ограничений, такие системы полезны как модели сложных физических явлений, от динамики газов до небесной механики, и помогают понять фундаментальные барьеры прогнозирования в природе.
Выводы автора:
- Один шар в двумерном бильярде со специальной геометрией может воспроизвести работу универсальной машины Тьюринга и выполнить любое вычисление.
- Бильярдные системы служат полезной моделью для понимания фундаментальных ограничений вычисления, таких как проблема остановки, в реальных физических системах.
- Работа поднимает вопрос о том, могут ли аналогичные вычислительные ограничения возникать в гравитационных системах, включая задачу трёх тел.
Программа — это форма стенок. Алгоритм — в буквальном смысле траектория.
Оригиналы:Один шар на бильярдном столе теоретически способен выполнить любое вычисление
Национальная онтология финансового рынка как инфраструктура данных
Данные и аналитика · Вестник НАУФОР · 8/10
Автор обосновывает необходимость создания единой национальной онтологии финансового рынка России — формализованной модели знаний, которая позволит всем участникам рынка говорить на одном языке данных. Сегодня финансовый рынок — это не только рынок капитала, но и рынок больших данных, где участники ежедневно обмениваются десятками миллионов сообщений, но часто определяют одни и те же сущности по-разному, что приводит к значительным издержкам на интеграцию и контроль качества. Международный опыт (FIBO, ISO 20022, LEI) показывает, что стандартизация только форматов обмена недостаточна — нужна унификация смысла данных. Банк России находится в уникальном положении, чтобы инициировать этот переход благодаря своему мандату, доступу к данным и влиянию на отрасль. Российский ИТ-ландшафт имеет преимущество перед Западом: меньше наследия мейнфреймов и большая роль регулятора в стандартизации. Однако готовые зарубежные решения нельзя просто перевести на русский — нужна адаптация к российской правовой, экономической и технологической реальности, а также к стратегическим задачам (цифровой рубль, платформенные решения). Онтология должна развиваться постоянно, отражая изменения законодательства и появление новых финансовых продуктов. Внедрение национальной онтологии повысит качество данных, ускорит внедрение ИИ, снизит затраты на интеграцию и создаст основу для открытых API и автоматизированного регулирования.
Выводы автора:
- Финансовый рынок нуждается в едином семантическом пространстве — онтологии, которая позволит избежать дорогостоящих ошибок (цена ошибки может измеряться сотнями миллиардов рублей) и противоречий между системами участников рынка.
- Банк России должен инициировать создание национальной онтологии, так как он имеет мандат, влияние на отрасль и доступ к данным, что обеспечит критическую массу внедрений.
- Россия должна разработать собственную онтологию на основе международного опыта (FIBO), но адаптированную к российскому регулированию, структуре рынка и цифровым стратегиям (цифровой рубль, платформы), а не просто перевести зарубежные решения.
Цена ошибки при создании нового финансового инструмента может измеряться сотнями миллиардов рублей только прямых потерь, и именно для того, чтобы избежать столь дорогостоящих ошибок, нужен инструмент онтологии.
Оригиналы:На одном языке с рынком (Вестник НАУФОР №7-8/2026)
Jailbreak-атаки на ИИ: основные техники и почему они работают
Кибербезопасность · Habr · 9/10
Статья разбирает механику Jailbreak-атак — способов обхода встроенных ограничений языковых моделей через социальную инженерию и правильно составленные текстовые запросы. Отличие Jailbreak от промпт-инъекции: в первом случае пользователь сам манипулирует моделью, во втором вредоносная команда приходит из внешних данных. Автор рассматривает несколько классических техник: DAN (Do anything now) — просьба играть персонажа без правил; эксплойт с бабушкой — использование эмпатии модели через ролевую игру; Crescendo — многошаговая атака, постепенно подводящая модель к выдаче запретной информации через серию невинных вопросов; обход фильтров через кодирование (Base64) и стеганографию. Главный вывод: модели срабатывают потому, что их обучили помогать, а готовность помочь ихнадеются использовать как уязвимость. Холодная модель отказала бы, тёплая — выполнит просьбу, даже если та противоречит политикам безопасности.
Выводы автора:
- Jailbreak-атаки — это социальная инженерия, не требующая технического взлома кода, а основанная на убеждении модели играть по другим правилам
- Готовность ИИ помогать пользователю противоречит его безопасности: модель может расценить отказ как больший вред, чем сама опасная информация
- Современные фильтры безопасности уязвимы для многошаговых атак (Crescendo) и кодирования, так как полагаются на анализ явного текста
Модель, войдя в образ, откликалась и начинала пересказывать технологический процесс — не имея злого умысла, а помогая человеку, который просит о теплом воспоминании.
Оригиналы:Что такое JailBreak-атаки: почему ИИ нарушает собственные правила и как это работает
Цепочка атаки: от LFR в калькуляторе к полной компрометации облака
Кибербезопасность · Habr · 9/10
В статье разобран реальный кейс пентеста, когда простая LFR-уязвимость (Local File Read) во вспомогательном сервисе расчета тарифов привела к полной компрометации облачной инфраструктуры компании. Точкой входа стал эндпоинт /download_report на calc.company.com, который принимал абсолютные пути файлов без фильтрации и позволял читать любые файлы, включая /etc/shadow. Через LFR-уязвимость исследователи получили конфигурационный файл приложения с открытыми ключами партнерского API (key_calc и key_billing). С помощью этих ключей они получили доступ к методу /v2/accounts партнерского API apipartner.company.com, который вернул полный список всех пользователей облака с их ролями, включая привилегированные аккаунты с полными правами. Затем с использованием слабо реализованного rate-limit (ограничение по IP вместо по аккаунту) удалось подобрать словарный пароль к одной из privileged учетных записей. В итоге получен полный контроль над облаком и доступ к административной панели cloud-admin.company.com.
Атака стала возможной из-за сочетания трех главных факторов: хранения секретов в открытом виде в конфиге, выдачи вспомогательному сервису ключа с избыточными привилегиями, отсутствия двухфакторной аутентификации на привилегированных аккаунтах и слабой защиты от перебора пароля.
Выводы автора:
- LFR-уязвимость часто служит точкой входа для развития более сложной цепочки атак; критичнее не само чтение файлов, а то, какие артефакты (конфиги, ключи, исходники) в них хранятся
- Второстепенный сервис не должен иметь ключи с привилегиями, которые ему не требуются для работы; калькулятору нужны только методы расчёта, но не список всех администраторов
- Защита от перебора пароля и rate-limit должны быть привязаны к аккаунту, а не к IP-адресу, и все привилегированные аккаунты обязаны иметь двухфакторную аутентификацию
Импакт LFR-уязвимости определяется не самой возможностью чтения, а тем, как ее эксплуатируют. В большинстве случаев LFR — не финальная находка, а точка входа.
Оригиналы:Калькулятор с ключами: как чтение одного файла привело к компрометации публичного облака
OpenAppSec: open-source WAF на базе машинного обучения
Кибербезопасность · Habr · 8/10
OpenAppSec — это open-source WAF (межсетевой экран веб-приложений) с машинным обучением для защиты веб-сервисов и API, изначально развивавшийся при поддержке Check Point. В отличие от облачных решений, проект позволяет развернуть защиту локально без привязки к SaaS. Агент работает как фоновый процесс рядом с прокси-сервером, анализируя входящие HTTP-запросы: сверяет их с сигнатурами известных атак (SQL-инъекции, RCE, XSS) и дополнительно проверяет по локальной статистике поведения конкретного сайта, используя две модели машинного обучения — контролируемую (обученную на миллионах запросов) и неконтролируемую (для анализа аномалий). На homelab из 10 сервисов решение занимает примерно 1 ГБ ОЗУ на пике и 8 ГБ диска; один vCPU-ядро обрабатывает около 500 запросов в секунду. Статья включает полное руководство по развёртыванию стека nginx proxy manager + open-appsec + OWASP Juice Shop с docker-compose, конфигурацией агента и объяснением интерфейса управления. Доступны интеграции с nginx и другими компонентами; энтузиасты также настраивают работу с Traefik через CrowdSec. Автор отмечает скромное потребление ресурсов и хорошую «сообразительность» системы при минимальной ручной настройке, хотя есть и недоработки.
Выводы автора:
- OpenAppSec использует две модели машинного обучения — контролируемую (для распознавания известных паттернов атак) и неконтролируемую (для выявления аномалий на основе локального поведения)
- Решение подходит для небольших homelab и средних продакшенов, обеспечивая защиту без облачной привязки и раздутого стека при потреблении около 1-3 ГБ ОЗУ
- Один vCPU способен обрабатывать примерно 500 запросов в секунду, но при анализе машинным обучением может потребоваться больше ресурсов, чем классические WAF на регулярных выражениях
По словам разработчиков, агент успешно блокировал уязвимости нулевого дня (zero-day).
Оригиналы:Meet the OpenAppSec: open-source WAF на базе машинного обучения
Good Bear: форк Firefox для безопасной работы с российскими сертификатами
Кибербезопасность · Habr · 8/10
Представлен проект Good Bear — форк Mozilla Firefox, решающий проблему работы с сертификатами, выпущенными Министерством цифрового развития России. Стандартный Firefox не принимает эти сертификаты, так как они не входят в глобальный список доверенных, а добавление их в системное хранилище опасно: скомпрометированный сертификат получит право подписывать контент для любых сайтов в мире. Good Bear реализует scoped-доверие — российский корневой сертификат принимается только внутри выделенного контейнера, полностью изолированного от остального браузера (куки, пароли, локальное хранилище не пересекают границу контейнера). Проект сохраняет все стандартные проверки (имя хоста, срок действия, подпись, расширения) и не модифицирует криптографию. Интерфейс русскоязычный с отдельными маркерами для контейнера и российского PKI. Браузер отключает все сервисы Mozilla (аккаунт, синхронизацию, телеметрию), но сохраняет Google Safe Browsing и проверку отзыва сертификатов со своим ключом. Команда разработчиков ищет поддержку для покрытия расходов на облачную инфраструктуру, инструменты разработки и ускорения выхода стабильной версии.
Выводы автора:
- Good Bear решает проблему безопасного использования российских государственных сертификатов, ограничивая их доверие специальным контейнером вместо глобального доступа
- Проект полностью изолирует состояние (куки, пароли, соединения) внутри российского контейнера, предотвращая утечку данных между контекстами
- Разработчики не трогают криптографию и стандартные проверки безопасности, применяя скопированное доверие только после отказа стандартной проверки
Добавить его в системное хранилище — значит доверять ему везде. Это плохая идея: корень, который должен работать только для ограниченного круга российских ресурсов, получает право подписывать что угодно
Оригиналы:Good Bear: анонс веб-браузера для безопасной работы с сертификатами Минцифры
Банк России о прозрачности: дропы в минутах, FATF-2028 на горизонте
Финтех и финансы · Б.О: Экономика · 8/10
Выступление руководителя финмониторинга Банка России Богдана Шабли на Международном банковском форуме раскрывает результаты борьбы с теневым бизнесом и планы регуляции. За 13 лет объем вывода средств через юрлица снизился в 30 раз; платформа ЗСК пресекла операции по 190 тыс. недобросовестных субъектов и сократила подозрительные операции на 35% в первом полугодии 2026 года. Около 100 тыс. клиентов исключены из реестров на основе этих данных. Вводится единый идентификатор физлиц на базе ИНН с автоматическим присвоением нерезидентам. Платформа «Антидроп» сокращает среднюю жизнь финансовых дропов до минут благодаря онлайн-контролю; объемы P2P-операций упали в три раза с 2023 года. Уголовная ответственность и требование согласия родителей снижают использование несовершеннолетних в теневых схемах. Банк России настаивает на контроле наличности неустановленного происхождения, а не самой наличности. В первом полугодии 2028 года Россию ждет миссия ФАТФ — неудача может привести в серые или черные списки и ударить по инвестициям; планируются уточнения 115-ФЗ для целевого воздействия на организаторов теневого бизнеса.
Выводы автора:
- Система мониторинга Банка России продемонстрировала высокую эффективность: подозрительные операции сокращаются, а платформа ЗСК позволяет быстро исключать недобросовестных клиентов и перераспределять ресурсы комплаенса.
- Внедрение единого идентификатора на основе ИНН и автоматического присвоения его нерезидентам создает единое пространство данных для контроля и затрудняет анонимное ведение финансовых операций.
- Миссия ФАТФ в 2028 году станет критической точкой — неудача грозит попаданием России в черные списки, поэтому банки должны начать подготовку немедленно, включая изучение методических рекомендаций Банка России.
Средняя жизнь дропа в банке, где налажен онлайн-контроль, составляет минуты
Оригиналы:Прозрачность, дропы, наличные, FATF-2028
CJM для ИТ-продукта: как построить карту, которой команда будет пользоваться
Продукт и карьера · Habr · 8/10
Статья о построении Customer Journey Map (карты клиентского пути) для ИТ-продуктов на примере банковских сервисов. Главная идея: ИТ-команды часто фокусируются на внутренних процессах и метриках, теряя из вида реальный опыт клиента. Например, открытие счёта занимает 20 минут по регламенту, но клиент делает три визита в офис и ждит неделю, потому что процесс разбит между приложением, сайтом, контактным центром и офисом — клиент видит дисбаланс. Для построения эффективной CJM автор предлагает ответить на восемь ключевых вопросов: кто проходит путь, что он пытается сделать, где сворачивает, почему возникают трудности, какие эмоции испытывает и как они влияют на поведение. Важно сначала описать текущее состояние (AS IS) во всех деталях, затем целевое (TO BE), не допуская магических скачков. Данные для карты собирают из интервью с клиентами и сотрудниками, анализа обращений в контакт-центр, CRM, цифровой аналитики и самостоятельного прохождения сценария. При интервьюировании нужно спрашивать о конкретных ситуациях, а не общих впечатлениях, и обращать внимание на обходные пути — как пользователи решают задачи, когда продукт не работает. Данные структурируют в таблице по признакам: сегмент, этап, действие, канал, проблема, источник, частота. Вывод считается надёжным, только если его подтверждают несколько источников. На практике CJM слои становятся строками таблицы (действие клиента, канал, функция, внутренняя система, ответственное подразделение, бизнес-процесс, данные, проблема, метрика), а шаги пути — колонками, связывая клиентский опыт с ИТ-ландшафтом и выявляя пробелы в логировании данных.
Выводы автора:
- CJM нужна не только CX-специалистам, но и продуктовой команде, аналитике, бизнесу и разработке, чтобы увидеть продукт снаружи и разрыв между внутренними процессами и опытом клиента.
- Карту строят на основе нескольких источников (интервью, CRM, контакт-центр, аналитика, самостоятельное прохождение), а выводы считают надёжными только при подтверждении из разных источников.
- При интервьюировании спрашивают о конкретных сценариях и обходных путях, а при описании проблем указывают точную причину, а не симптом — это даёт команде ясное направление для улучшений.
Клиент не делит банк на приложение, сайт, контактный центр и офис. Если в разных местах он услышит разное, он скажет, что у банка проблемы.
Оригиналы:CJM для ИТ-продукта: как построить карту, которой команда будет на самом деле пользоваться
Почему продакт-менеджер банка тратит время на согласования вместо разработки
Продукт и карьера · Б.О: Банки · 8/10
Материал разбирает критическую проблему в крупных банках: продуктологи тратят более половины времени на организационные процессы и согласования вместо исследований и создания продуктов. В банках топ-10 сотни продуктовых команд со своими приоритетами сталкиваются в «узком горлышке» согласующих структур (юристы, комплаенс, ИБ, IT), которые работают не по спринтам и живут по собственному таймлайну. Автор указывает, что некрупные финтехи вроде Т-Банка в период роста решали это через вовлечение топ-менеджмента для оперативного одобрения. На Западе проблема решается через три подхода: сдвиг влево (встраивание контроля на ранние стадии сокращает инциденты на 70% и ускоряет релизы на 30%), Compliance by Design (регуляторные требования в брифинг с начала), разделение обучения и производства (использование синтетических данных для пилотов без полного согласования). В российских банках решением становится встраивание юристов и комплаенс-специалистов в продуктовые направления с мотивацией через бонусы, зависящие от продуктовых внедрений.
Выводы автора:
- Основной источник задержек в банках — не техническая разработка, а согласование с внутренними службами, работающими вне спринтов
- Западные банки решают проблему встраиванием комплаенса и безопасности на ранние этапы разработки, что сокращает время вывода на рынок на 30%
- Включение согласующих специалистов в продуктовые команды с целевой мотивацией позволяет избежать узких мест и заторов
Продакт-менеджер мог бы доработать отличную новую фичу или провести исследование, но тратит время на согласования — это происходит не всегда логично.
Оригиналы:Рождение продуктов на спринтé
Коротко
Финтех и финансы
- Банк России установил надбавки по облигациям потребительских кредитов – Банк России впервые установил макропруденциальные надбавки на вложения банков в облигации, обеспеченные потребительскими кредитами, с 15 октября 2026 года.
Прочее
- Яков Перельман: учёный-популяризатор, вдохновивший поколения – Статья рассказывает о жизни и научной деятельности Якова Перельмана, одного из самых известных советских популяризаторов науки.