Дайджест за 23 сентября 2026
Яндекс запустил собственную 80-миллиардную языковую модель AliceAI-Foundation, а OpenAI активно превращает ИИ в рекламную машину и строит полнодуплексные голосовые системы — индустрия явно входит в фазу боевого развертывания агентов. Параллельно Windows интегрирует ИИ-помощников на уровень ОС, и даже no-code платформы типа VibeCraft начинают упрощать создание приложений для масс. При всей суматохе вокруг моделей главное понимание смещается с технологии на людей: дефицит переместился из кода в идеи, а значит, скоро будет видно, кто придумает что-то действительно нужное.
Главное
- Яндекс открыл AliceAI-Foundation-80B — новую ЛЛМ с нуля на 80 млрд параметров
- Откуда берётся сложность в разработке игр
- Jev: новый подход к управлению решениями в AI-системах
- OpenAI строит рекламную машину: от поисковых ссылок к агентам
- Как найти и исправить скрытые ошибки ИИ-продукта: гайд по error discovery
Подробно
Яндекс открыл AliceAI-Foundation-80B — новую ЛЛМ с нуля на 80 млрд параметров
ИИ и агенты · Habr · 9/10
Яндекс опубликовал новую языковую модель AliceAI-Foundation-80B-A3B-Base под лицензией Apache 2.0, обученную полностью с нуля без использования весов сторонних моделей. Модель содержит 80 млрд параметров с 3 млрд активных (A3B) и показывает сильные результаты на множестве бенчмарков, превосходя более крупные DeepSeek-V4-Flash-Base и Nemotron-3-Super на фактологических вопросах, математике и коде, при этом оставаясь компактнее предыдущей закрытой модели Alice AI LLM 235B. На сложных задачах IMO AnswerBench и LiveCodeBench модель лидирует среди открытых претрейнов. Вместе с весами компания публикует детальный технический отчёт (81 минуту чтения) с описанием пайплайнов подготовки данных, протоколов оценки, стабилизации обучения и scaling laws, включая абляционные эксперименты. Также открываются два новых фактологических бенчмарка — WikiWebFacts и HardMultiQA с акцентом на русскоязычный контекст. Особенно хорошо модель справляется с задачами о российской культуре, русском языке, литературе, истории, медицине и праве. В отчёте подробно разобраны неожиданные результаты: loss на отложенной части корпуса плохо предсказывал производительность на целевых бенчмарках, понадобилась переработка аугментаций и добавление инструментальных взаимодействий уже на этапе претрейна для развития агентских способностей.
Выводы автора:
- AliceAI-Foundation-80B обучена с нуля без использования чужих весов и превосходит более крупные модели на множестве задач, при этом имея меньше параметров, чем конкуренты (кроме Qwen)
- Для развития агентских навыков недостаточно обучения только рассуждениям — необходимо добавлять взаимодействия с инструментами уже на этапе претрейна
- Яндекс открывает две новые фактологические бенчмарки и детальный технический отчёт с методологией оценки и абляционными экспериментами для воспроизведения результатов
Loss на отложенной части корпуса плохо предсказывал, какая модель будет сильнее на целевых бенчмарках
Jev: новый подход к управлению решениями в AI-системах
ИИ и агенты · Linas from Linas's Newsletter · 9/10
Diogo Almeida, один из создателей ChatGPT, запустил через TypeSafe AI модель Jev, которая кардинально отличается от генеративных моделей тем, что не пишет текст, а принимает решения. Jev работает как интеллектуальный switch statement: получает ограниченный набор вариантов и возвращает выбор с калибированной уверенностью.
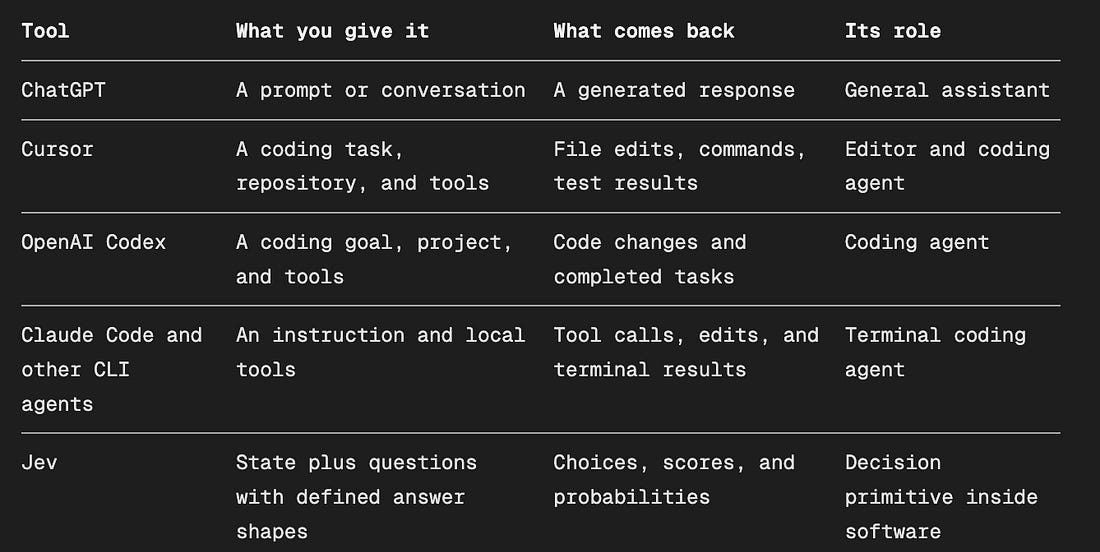
Вместо того чтобы генерировать ответ, Jev решает, что должна сделать система дальше. За неделю после запуска модель интегрирована в Vercel, OpenRouter и Cloudflare Workers AI с сотнями готовых решений. Примеры показывают практическую ценность: Matthew Berman проанализировал 724 объявления за 40 секунд и 9 центов; Vechen снизил стоимость GPT-6 Astra на 50% благодаря динамическому управлению уровнем рассуждений; Jarrod Watts создал торговый бот, принимающий решения каждые 300 миллисекунд.
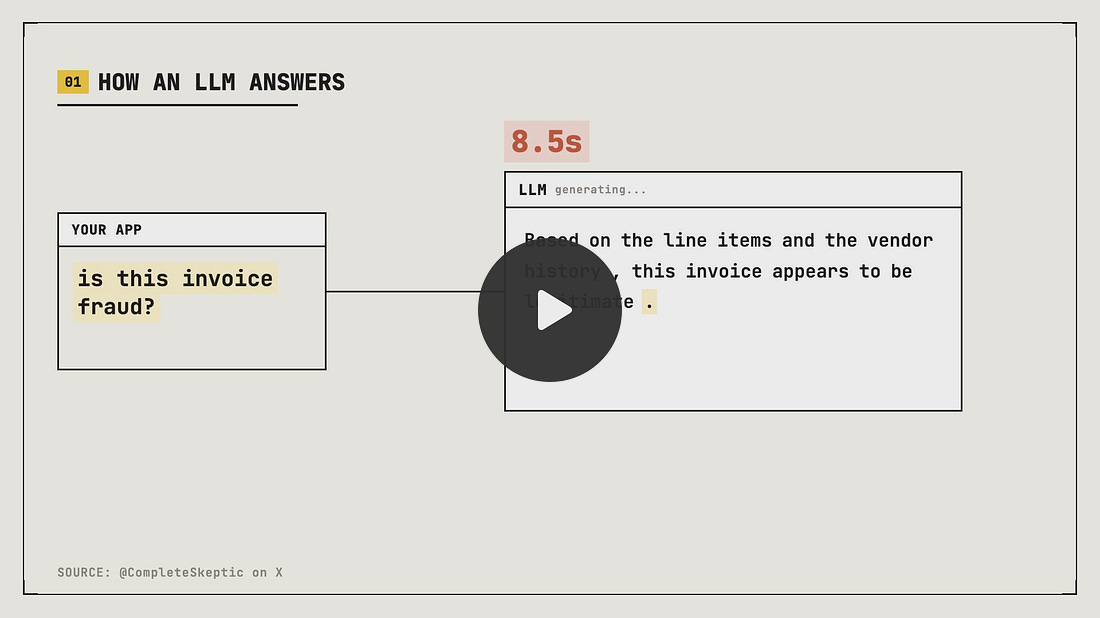
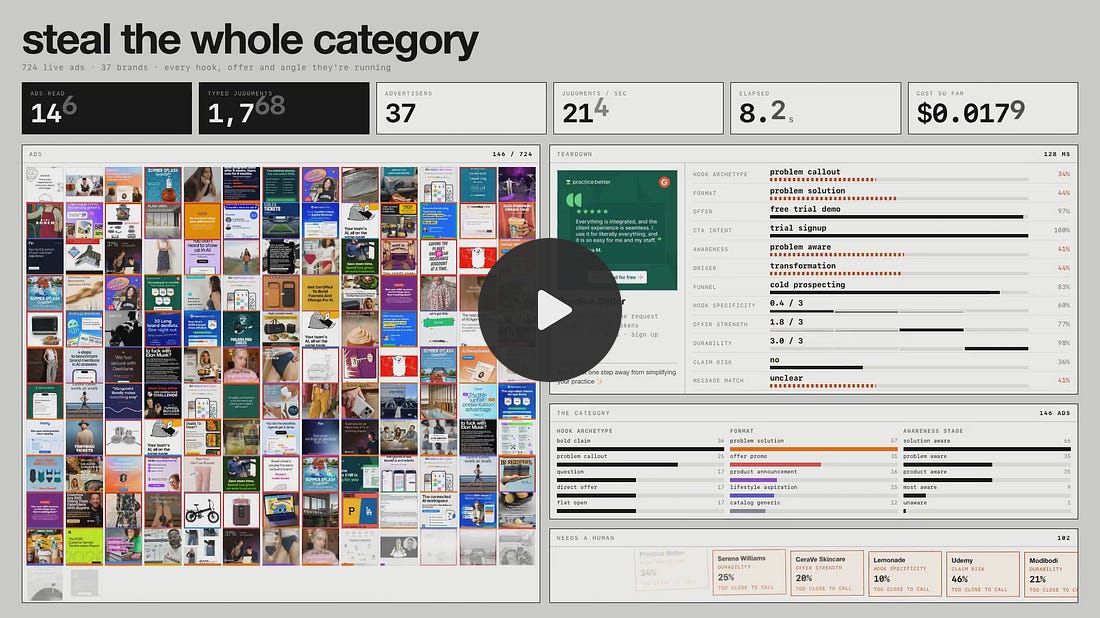
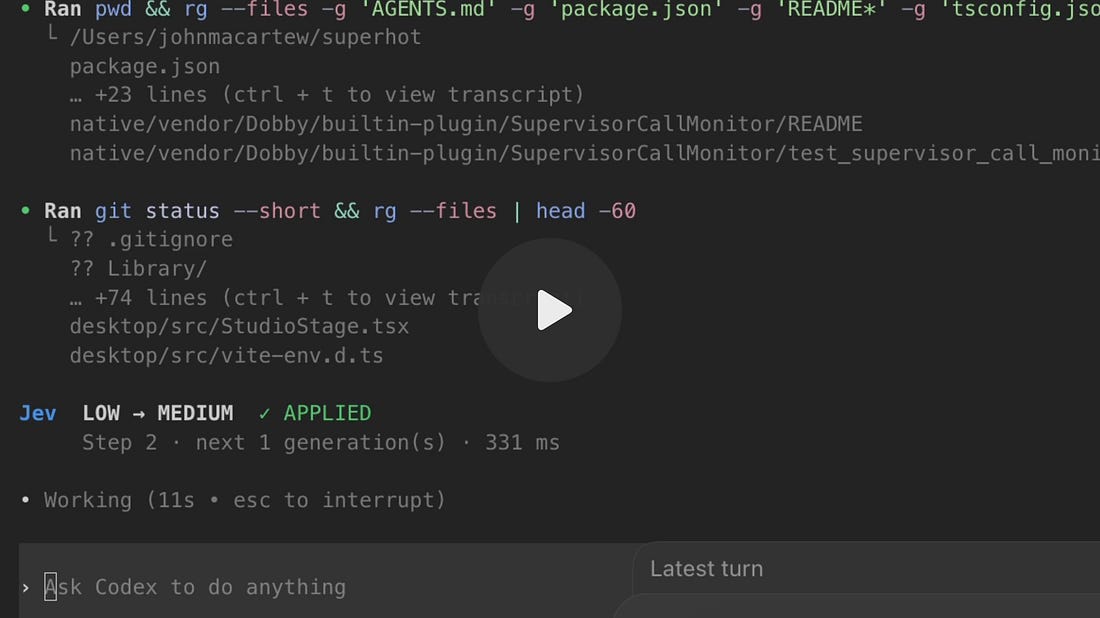
Эти примеры демонстрируют одну архитектуру: система создаёт состояние, передаёт Jev ограниченный вопрос, модель возвращает типизированное решение с вероятностями. Современные AI-системы переполнены микроскопическими семантическими решениями, которые слишком сложны для обычных правил, но слишком частые для отдельного вызова большой моделью. Jev становится семантическим уровнем управления между детерминированным кодом и дорогостоящим интеллектом. При стоимости $0.042 за миллион входящих токенов это делает суждения доступными в точках решений, где раньше вызов LLM был экономически неоправдан. Модель эффективна при чётких решениях и ограниченном наборе вариантов, но менее надёжна при скрытых зависимостях и долгосрочном рассуждении. Путь от демо к production требует правильного проектирования состояния, вопросов, локальной оценки, порогов срабатывания и fallback-стратегий.
Выводы автора:
- Jev — это не генеративная модель, а система для принятия ограниченных, типизированных решений с калибированной уверенностью, которая может работать в критичных по задержкам циклах системы.
- Архитектурная ценность Jev в том, чтобы стать семантическим контроллером между детерминированным кодом и дорогостоящим ИИ, управляя когда и как использовать более мощные модели и переходит границы экономики микрорешений.
- Jev требует тщательного проектирования состояния, вопросов, локальной оценки и fallback-механизмов для перехода из прототипа в production-систему, которую можно надёжно использовать в бизнесе.
Jev предлагает другой примитив: вместо того чтобы просить модель объяснить, что должно произойти, программа просит ограниченное решение, которое она может немедленно использовать.
OpenAI строит рекламную машину: от поисковых ссылок к агентам
ИИ и агенты · App Economy Insights · 9/10
Материал анализирует фундаментальные изменения в монетизации ИИ-продуктов на примере OpenAI, Meta и Salesforce. OpenAI за менее чем 200 дней построила рекламный бизнес с годовым темпом в $1 млрд, привлекши десятки тысяч рекламодателей и достигнув $1 прибыли на пользователя при 1 млрд еженедельных пользователей ChatGPT. Для сравнения, Meta генерирует около $57 на одного ежедневного активного пользователя, что показывает огромный потенциал роста OpenAI. Ключевое преимущество ChatGPT перед поиском Google: платформа видит глубже в процесс принятия решения, включая бюджет, текущие инструменты, требования и компромиссы, обсуждаемые в диалоге. Amazon уже валидирует эту гипотезу, разрешив рекламодателям размещаться в ChatGPT Ads при управлении кампаниями через Amazon Ads.
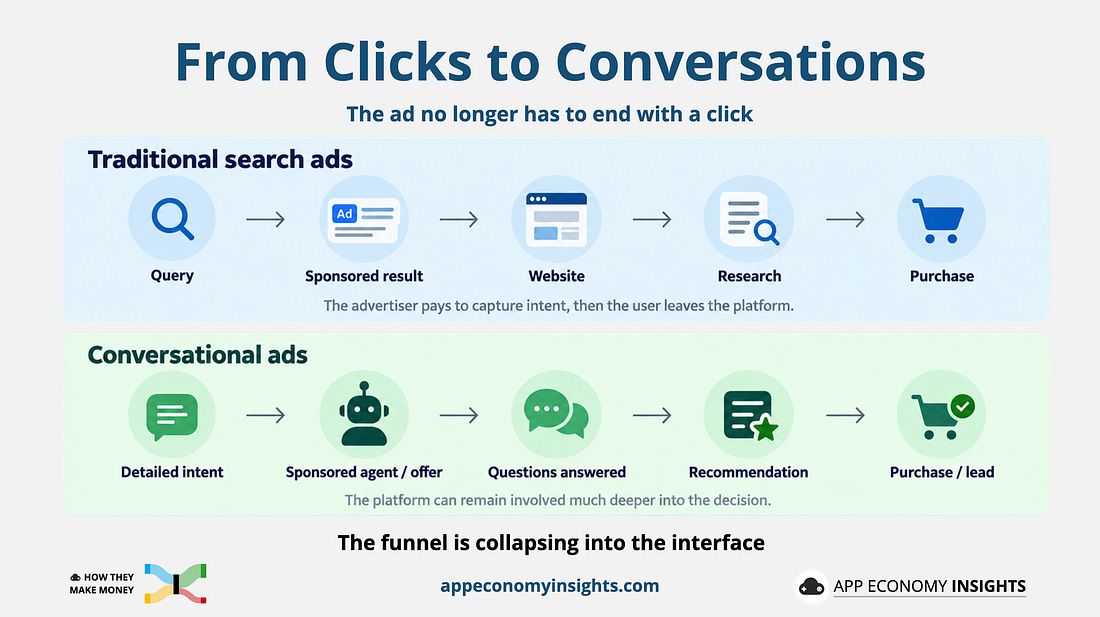
OpenAI движется дальше с Sponsored Agents — вместо клика по объявлению пользователи начинают диалог с ИИ-представителем бренда, который помогает квалифицировать клиента ещё до перехода на сайт рекламодателя. Это означает эволюцию монетизации: от запросов (поисковые ссылки) через внимание (бесконечная лента) к монетизации самого процесса принятия решения через ИИ-агентов. Легче всего это работает в категориях, требующих персонализированных исследований: ПО, путешествия, финансовые услуги, образование, ремонт, дорогие товары. OpenAI интегрируется с Shopify и HubSpot для упрощения доступа рекламодателей. Основное напряжение: ChatGPT ценен именно потому, что пользователи доверяют рекомендациям как объективным, а не как оплаченным.
Выводы автора:
- OpenAI монетизирует не внимание, а саму покупку — видя весь процесс принятия решения в диалоге, реклама становится качественнее и дороже, чем в поиске или социальных сетях.
- Спонсируемые агенты трансформируют саму природу объявлений: вместо кликов они теперь квалифицируют потенциальных клиентов прямо в диалоге перед отправкой на сайт продавца.
- Главное препятствие для OpenAI — сохранить доверие пользователей к объективности рекомендаций ChatGPT, не скатываясь в скрытую рекламу.
Диалог может поглотить работу, которая сейчас распределена по поисковым результатам, сайтам сравнения, страницам товаров и звонкам менеджерам.
Оригиналы:OpenAI's Advertising Machine
Как найти и исправить скрытые ошибки ИИ-продукта: гайд по error discovery
ИИ и агенты · Lenny's Newsletter · 9/10
Статья обсуждает критическую практику error discovery — этап разработки ИИ-продуктов, который большинство команд пропускают. Авторы Hamel Husain и Shreya Shankar на основе работы с 50+ компаниями выяснили, что команды часто прыгают сразу к написанию метрик, не проведя анализ реальных ошибок. Error discovery — это аналог product discovery: выявляет, какие AI-сбои действительно стоит измерять. Без этого этапа команды измеряют не то или измеряют неправильно. Авторы показывают трёхшаговый процесс эффективного error discovery с помощью coding agents: сначала вручную изучить разнообразную выборку traces (записи сессий), выявить паттерны ошибок, а потом дать агенту аннотировать остальные примеры. Ключевая проблема — criteria drift: определение успеха часто становится понятно только после просмотра реальных данных. Примеры компаний (Shopify, Cursor, Ramp, Harvey) показывают, что инвестирование в evals снижает затраты на 41-68% и улучшает метрики качества в 2+ раза.
Авторы подготовили бесплатный eval skills plugin и промокод LENNYSLIST для 25% скидки на курс.
Выводы автора:
- Error discovery, где вручную рассматриваются примеры для понимания критериев успеха, важнее автоматического написания метрик и должен быть приоритетом, если времени недостаточно.
- Критерии оценки AI-ответов часто открываются только при анализе реальных данных (criteria drift), поэтому нужно сначала учиться на человеческих примерах, а потом давать задачи агентам.
- Coding agents лучше всего работают вместе с человеческим суждением: они ловят очевидные ошибки и масштабируют процесс, но пропускают контекстные ошибки, требующие понимания бизнес-логики продукта.
Если у вас есть время только на одну часть процесса evals, приоритизируйте error discovery.
Оригиналы:Advanced evals: How to find (and fix) hidden AI failures in your product
Как OpenAI построила GPT-Live: полнодуплексные голосовые модели нового поколения
ИИ и агенты · ByteByteGo · 9/10
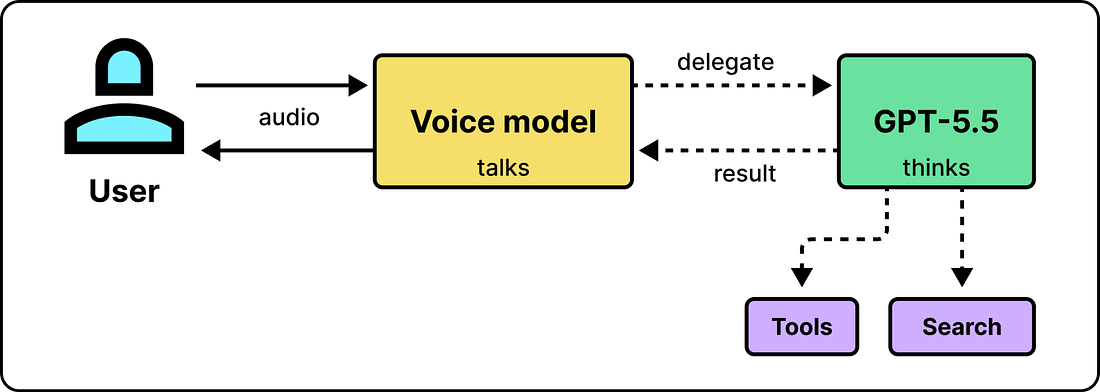
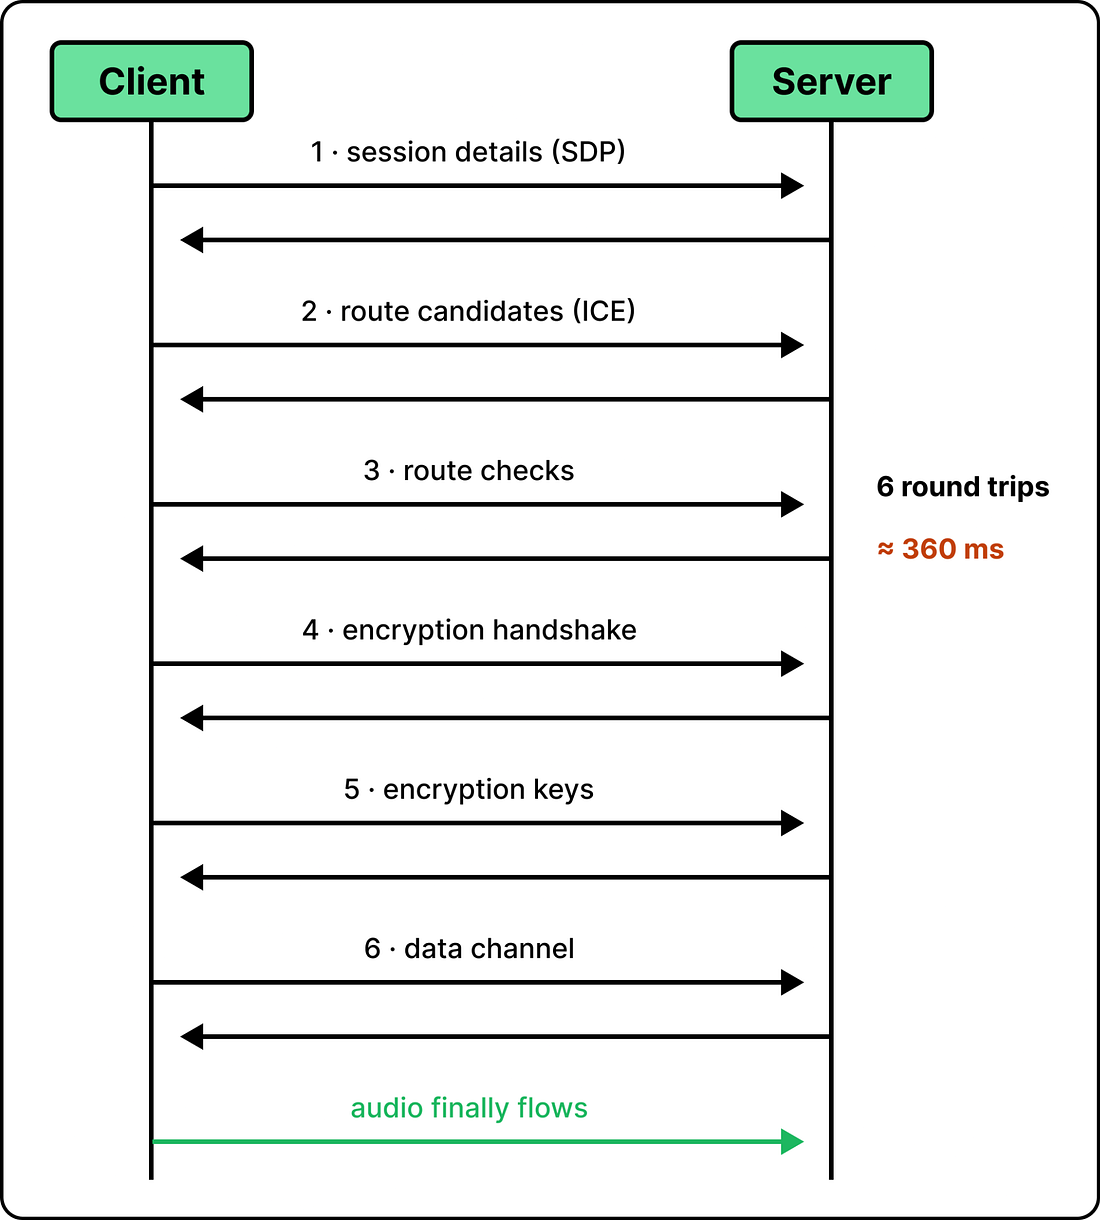
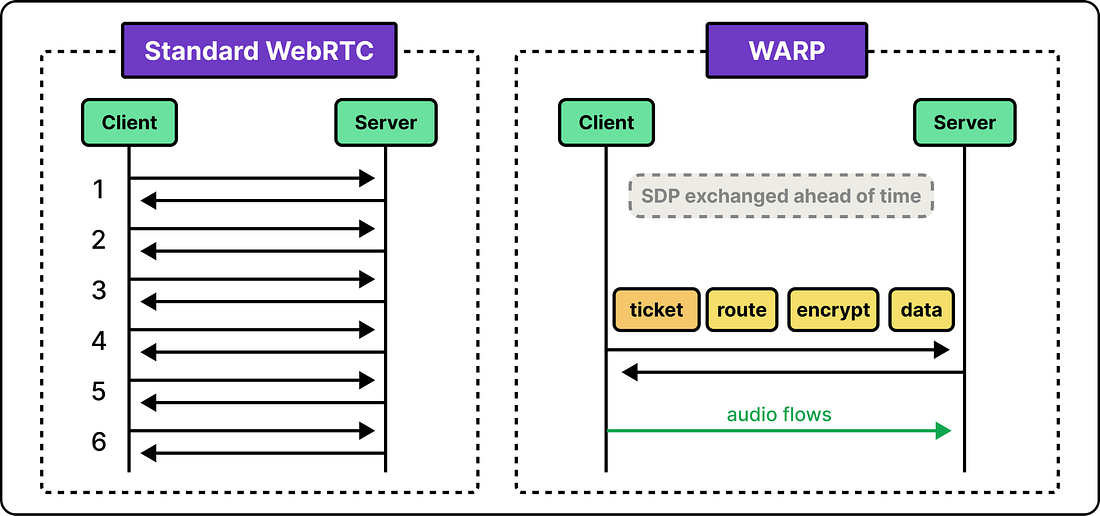
Статья разбирает архитектуру GPT-Live-1 — полнодуплексной голосовой модели OpenAI, которая может одновременно слушать и говорить, избегая неестественных пауз и перебиваний. Автор проходит три поколения голосовых систем: каскадные конвейеры (ASR → LLM → TTS), имеющие потери информации и высокую задержку; пошаговые речевые модели со сложным детектором очерёдности; и новые полнодуплексные архитектуры, обрабатывающие токены молчания наравне с речью. Ключевая инновация GPT-Live — разделение "говорения" и "думания": небольшая голосовая модель ведёт диалог с пользователем в реальном времени, а мощная модель (GPT-5.5) параллельно выполняет вычисления, поиск и инструменты. Это позволяет избежать многосекундных пауз при сложных запросах. Для реализации OpenAI разработала двухпутевую систему обслуживания: быстрый live-путь для аудиофреймов (каждые ~80 мс) и асинхронный путь для медленных операций. Оптимизации включают установку WebRTC-сессии за один раунд (вместо шести), непрерывный дешёвый инфренс и передачу диалогов между экземплярами модели без разрыва.
Выводы автора:
- Полнодуплексные голосовые модели решают проблему неестественности в диалогах, позволяя системе непрерывно слушать и говорить одновременно, вместо ожидания завершения фразы пользователя
- Разделение функций между лёгкой голосовой моделью для диалога и мощной моделью для мышления позволяет достичь баланса между скоростью отклика и качеством ответов
- Инженерные решения для низкой задержки (однораундовое установление соединения, непрерывный инфренс, двухпутевая архитектура обслуживания) критичны для практической реализации полнодуплексных систем в production
Модель просто должна научиться поведению во время обучения и неявно понять, когда слушать и когда говорить, из данных обучения.
Оригиналы:How OpenAI Built GPT-Live на Substack
Как Windows интегрирует ИИ-агентов на уровне ОС
ИИ и агенты · The Pragmatic Engineer · 9/10
Microsoft готовит фундаментальные изменения в Windows для поддержки ИИ-агентов на уровне операционной системы, стремясь вернуть доверие разработчиков, которые предпочитают macOS и Linux. Материал основан на интервью с руководством Windows-команды и раскрывает конкретные технологии: идентификация агентов через Entra ID, централизованный реестр MCP-серверов (ODR), механизм изоляции инструментов агентов (MXC), поддержку локальных моделей через новый слой абстракции WindowsML.
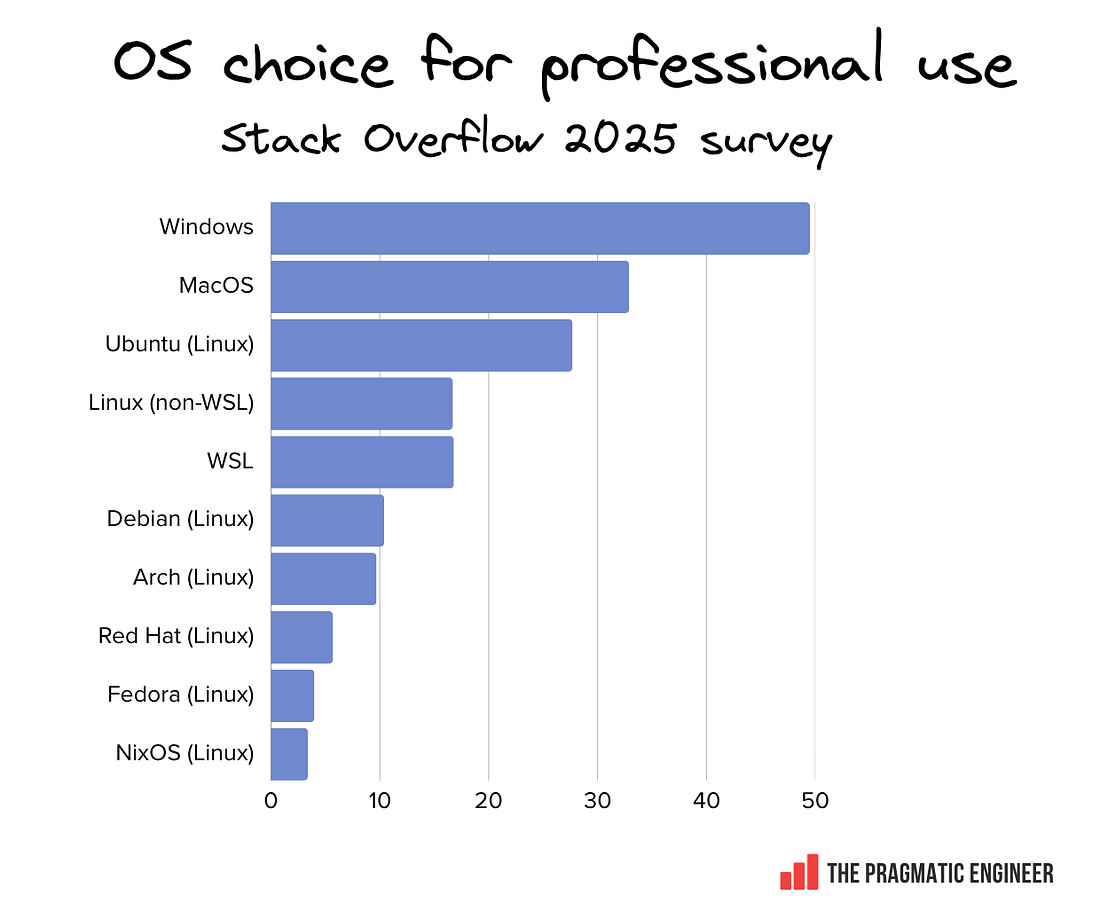
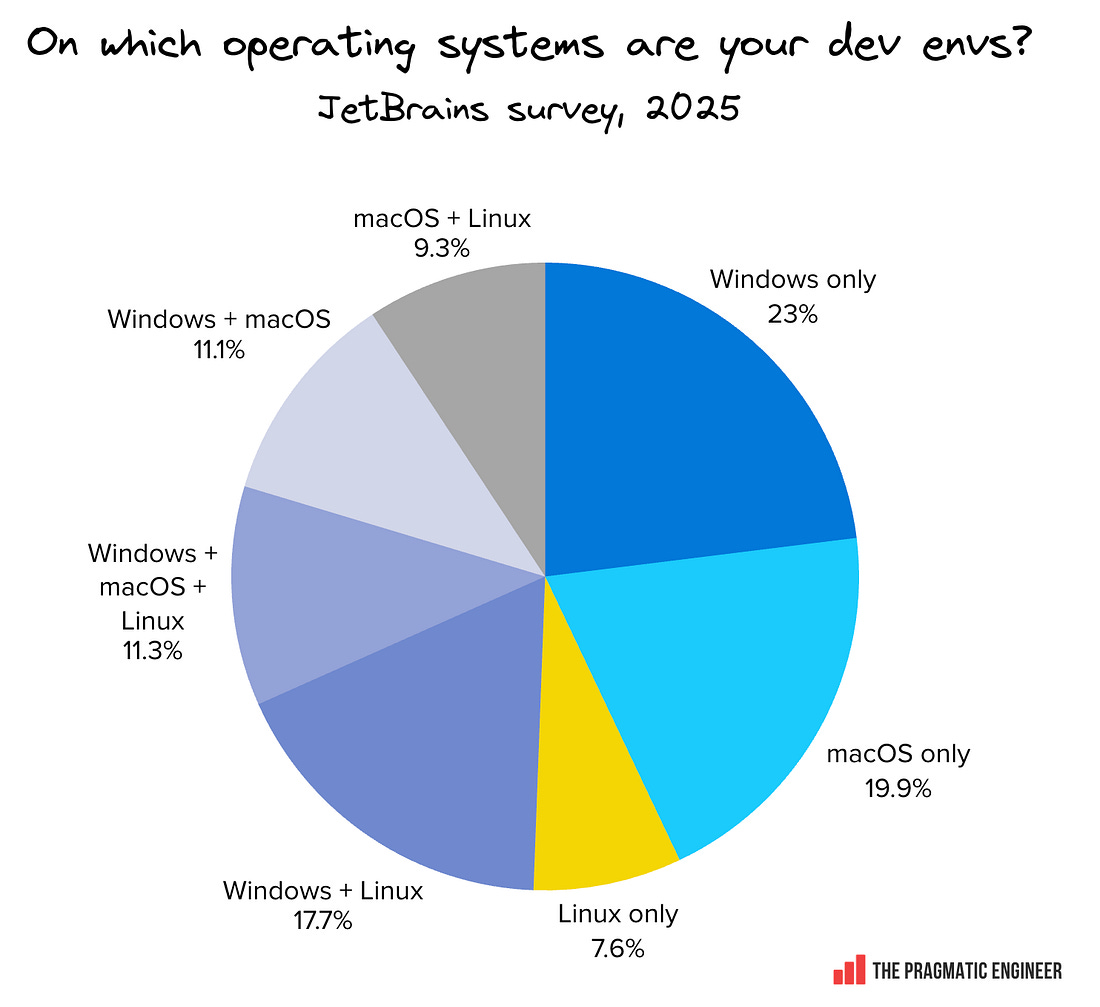
Исследования показывают снижение популярности Windows среди разработчиков: Stack Overflow 2025 и JetBrains опросы демонстрируют, что macOS и Linux набирают долю рынка.
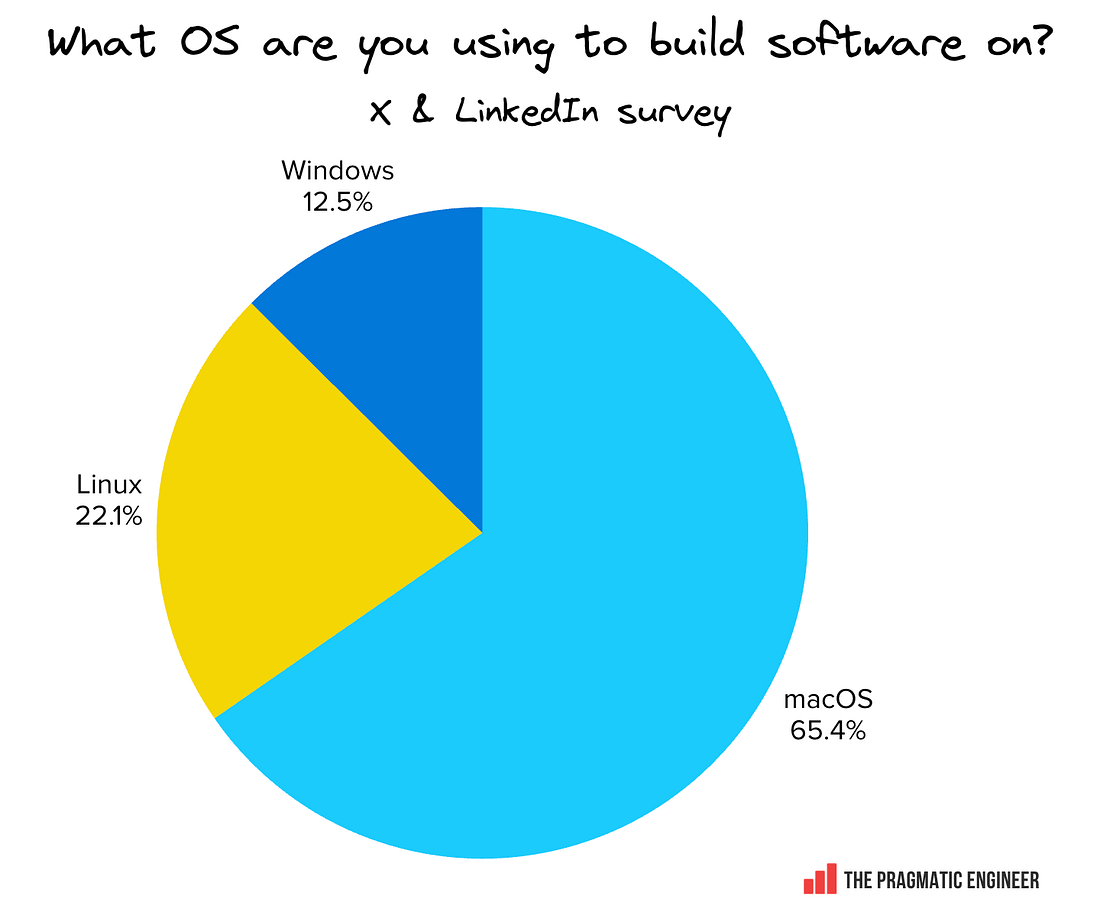
В собственном опросе авторов среди 9,937 ответивших Linux и macOS заняли более высокие позиции, чем Windows. Отдельное внимание уделено улучшению WSL (Windows Subsystem for Linux), контролю безопасности через Defender, ставший «agent-aware», и поддержке ARM-архитектуры. Microsoft пытается решить давние претензии разработчиков к загромождённому интерфейсу Windows.
Выводы автора:
- Windows внедряет встроенную поддержку ИИ-агентов на уровне ОС с механизмами идентификации, обнаружения и изоляции инструментов для безопасного выполнения
- Популярность Windows среди разработчиков снижается в пользу macOS и Linux, и Microsoft активно работает над возвращением доверия через новые технологии и исправление накопленных ошибок проектирования
- Стратегия Microsoft включает усиление WSL, поддержку локальных моделей через WindowsML и обеспечение работы с GPU/NPU без требования специализированного оборудования
Агенты всё чаще выглядят как обычные пользователи на уровне операционной системы, их сеансы могут длиться часы и использовать ресурсы ОС, поэтому Windows позволяет разработчикам создавать отличимые от пользователей программы.
Оригиналы:How will AI change operating systems? Part 2: Windows · The Pragmatic Engineer · Stack Overflow 2025 survey
VibeCraft: платформа для создания приложений без знания кода
ИИ и агенты · Habr · 8/10
Яндекс представил VibeCraft — платформу, позволяющую людям без опыта разработки создавать рабочие приложения через чат с ИИ-агентом. В отличие от обычных кодовых ассистентов, VibeCraft решает полный набор задач: генерирует код, разворачивает приложение, настраивает окружение и инфраструктуру, включая базы данных и сервисы. Платформа использует двухагентную систему (менеджер и программист), работает с Node.js и TypeScript, хранит данные в бессерверной YDB Яндекса. Простой прототип собирается за 7–10 минут, более сложные приложения (таск-трекеры, CRM, финансовые трекеры) — за 20–40 минут. Команда решила критические задачи: научила модели честно декларировать свои ограничения, управлять поведением агентов через инструменты и контекст, а также внедрила механизмы защиты от зацикливания и несогласованности между агентами. Сервис уже доступен для регистрации с подарочной квотой; в планах загрузка картинок, шаблоны и интеграции с внешними сервисами.
Выводы автора:
- VibeCraft автоматизирует не только написание кода, но и развёртывание, настройку инфраструктуры и поддержку приложения, позволяя непрограммистам создавать полноценные продукты
- Платформа использует специально обученные модели Яндекса с двухагентной архитектурой вместо универсальных кодовых ассистентов, что обеспечивает быстрое получение рабочего прототипа без глубокого понимания пользователем технических деталей
- Ключевые инженерные решения включают обучение моделей границам своих возможностей, управление поведением через доступные инструменты и контекст, а также механизмы защиты от нестабильности и зацикливания агентов
Пользователю важно заниматься продуктом: бизнес-логикой, интерфейсом, проверкой гипотез. Он не должен думать о том, как приложение разворачивается.
Оригиналы:Программирование для тех, кто не пишет код: как устроен VibeCraft
Локальный инференс LLM на мини-ПК Ryzen AI Max+ 395
ИИ и агенты · Habr · 8/10
Пошаговое руководство по настройке локального инференса больших языковых моделей на мини-ПК с процессором Ryzen AI Max+ 395, который интегрирует 128 ГБ DDR5 памяти, доступной как видеопамять. Автор описывает процесс установки Ubuntu Linux с конфигурацией памяти через TTM (Transparent Translation Mode), позволяющей использовать почти все 128 ГБ под VRAM вместо ограничения Windows в 96 ГБ. Рассмотрены две основные стратегии ускорения: ROCm (AMD-версия CUDA) и Vulkan, с инструкциями по компиляции и запуску llama.cpp. Представлены бенчмарки производительности: при загрузке всех слоёв в память Vulkan показывает 53.7 токена/сек (в 2.7 раза быстрее Nvidia RTX 5060 Ti с 16 ГБ памяти), ROCm — 30.3 токена/сек; при частичной загрузке слоёв разница нивелируется. Вывод: устройство конкурентоспособно как локальный ИИ-сервер для запуска моделей размером 7–30B при условии максимальной загрузки памяти.
Выводы автора:
- На Linux через TTM можно задействовать почти 128 ГБ памяти под VRAM, чего Windows не позволяет, значительно улучшив скорость инференса для больших моделей
- Vulkan показывает примерно на 60% лучшую производительность чем ROCm на одном и том же оборудовании, хотя не все модели на нём стабильны
- Полнофункциональная видеокарта всё ещё значительно превосходит встроенную по скорости при одинаковом условии загрузки моделей в VRAM, но Ryzen AI Max+ 395 работает как практичный локальный ИИ-сервер
На Vulkan показывает примерно на 60% лучшую скорость, чем на ROCm, значит, не зря я его компилировал!
Оригиналы:Локальный инференс на Ryzen AI Halo
Вышел Grok 4.7 – модель для программирования и AI-агентов
ИИ и агенты · Habr · 8/10
xAI представила Grok 4.7, новую флагманскую модель, ориентированную на многочасовые задачи программирования, разработку AI-агентов и интеллектуальную работу. Модель построена на крупной базовой модели с расширенным обучением с подкреплением, что позволяет ей планировать работу, использовать инструменты и проверять результаты самостоятельно. Ключевые характеристики: контекстное окно в 500 тысяч токенов, поддержка текста и изображений, четыре уровня рассуждения (Low, Medium, High, xHigh), встроенный поиск в интернете и X, запуск кода. На CursorBench 4.0 Grok 4.7 набрал 46,3%, обойдя Grok 4.6 (40,4%) и конкурируя с GPT-5.6 Sol Max (41,7%), но уступая Fable 5.1 Max (51,8%). На DeepSWE v1.1 результат составил 71%, что соответствует лидирующему GPT-5.6 Sol Max (72,7%). Стоимость сохранена на уровне Grok 4.6: $2 за миллион входных токенов и $6 за выходных, что значительно дешевле конкурентов. Доступна также версия Fast с двойной скоростью генерации за двойную цену. Модель доступна через xAI API, Cursor, OpenRouter, Vercel и Cloudflare. Компания переработала систему защитных ограничений: в HackerBench v0.3 пропущено только 3,3% опасных запросов. xAI предлагает сильную комбинацию из большого контекста, агентных инструментов и низкой цены, которая может быть привлекательнее для разработчиков, чем абсолютное первенство в бенчмарках.
Выводы автора:
- Grok 4.7 – это модель для долгих задач с планированием и самопроверкой, а не для быстрых ответов в чате
- По различным бенчмаркам модель конкурирует или лидирует, но не везде – на Terminal-Bench уступает Fable 5.1 Max
- Привлекательная цена ($2/$6 за токены) и 500K контекст делают Grok 4.7 практичным выбором для разработчиков несмотря на отсутствие абсолютного лидерства
xAI предлагает сильную комбинацию из большого контекста, агентных инструментов и сравнительно низкой цены. Для разработчиков это может оказаться важнее ещё одной золотой медали в бенчмарке.
Оригиналы:Вышел Grok 4.7
OpenAI закрывает Custom GPTs и переводит их в плагины
ИИ и агенты · Habr · 7/10
OpenAI прекращает поддержку Custom GPTs и предлагает пользователям мигрировать на новый формат плагинов до 11 декабря 2026 года. Плагины позиционируются как более универсальный формат, объединяющий инструкции, файлы и подключённые сервисы, работающие в ChatGPT и Codex. При миграции инструкции преобразуются в skills, файлы знаний – в reference files, подключённые приложения добавляются в плагин. Однако миграция не перенесёт историю разговоров, выбранную модель, настройки публикации, список пользователей и черновики – будет перенесена только последняя опубликованная версия. Критический момент: Custom Actions для обращения к внешним API (создание задач, получение данных из CRM) не перенесутся автоматически. Публичные GPT станут приватными и потребуют отдельной настройки доступа или повторной публикации в каталоге. Для Enterprise-пространств установлены три этапа: запуск миграции 22 сентября, прекращение создания новых GPT 26 октября, отключение существующих 11 декабря.
Выводы автора:
- Custom GPTs полностью заменяются на формат плагинов с датой отключения 11 декабря 2026 года
- При миграции не переносятся история, модель, интеграции через Custom Actions и публичный доступ – создателям нужно переделывать эти элементы вручную
- Публичные GPT после миграции останутся приватными и потребуют повторной публикации для восстановления аудитории
Custom GPTs уходят красиво. Переписки не забирают, аудиторию не перевозят, интеграции оставляют хозяину. Настоящий переезд, только коробки собирает юзер.
Оригиналы:OpenAI закрывает Custom GPTs
Как банк «Центр-инвест» обучает сотрудников и регион работе с ИИ
ИИ и агенты · Б.О: Банки · 7/10
Банк «Центр-инвест» системно обучает сотрудников, клиентов, партнеров и госструктуры работе с искусственным интеллектом, позиционируя его как рабочий инструмент, а не абстракцию. Внутри банка действует ИИ-платформа — единый шлюз доступа к моделям с функциями обезличивания данных и управлением затратами по отделам; ключевой принцип: ИИ усиливает человека при условии его критического мышления и персональной ответственности. Банк реализует масштабные образовательные программы: 20 бесплатных интенсивов для более чем 1000 человек из 40 министерств и ведомств Ростовской области, обучение свыше 1200 предпринимателей в рамках федерального проекта «Производительность труда». Разработана и внедрена ИИ-платформа «ДАШБОРД „РАЗВИТИЕ РЕГИОНА
Выводы автора:
- ИИ приносит ценность только при соединении с критическим мышлением человека и его персональной ответственностью
- Банк системно развивает ИИ-компетенции в регионе, обучая госструктуры, предпринимателей и студентов через интенсивы и конкурсы
- Развитие цифровой грамотности рассматривается как инвестиция в конкурентоспособность бизнеса и деловую среду региона
Интеллект может быть искусственным, но ответственность остается персональной
Оригиналы:От промпта в письме до ИИ-агентов
Откуда берётся сложность в разработке игр
Разработка и архитектура · Habr · 9/10
Статья разбирает природу архитектурной сложности в разработке игр, объясняя, почему простой и чистый код становится невозможен при наличии жёстких технических ограничений. Автор показывает, что сложность — это цена, которую программисты платят за достижение измеримых целей: укладку кадра в 16 мс, лимиты памяти (например, 5.5 ГБ на консоли), размер установки, время загрузки. На примере алгоритма поиска пересечений объектов (от O(n²) до BVH с SIMD-оптимизацией) демонстрируется, как каждый уровень оптимизации покупает производительность ценой понятности кода. Ограничения взаимодействуют и часто противоречат друг другу: например, быстрая последовательная загрузка конфликтует с дедупликацией ассетов. Это разрушает модульность — абстракции и виртуальные вызовы становятся слишком дорогими, и архитектура вынуждена адаптироваться к железу (data-oriented design, кеш-линии, структура памяти). Жёсткие пределы (крашующие превышение) отличаются от мягких и определяют все бюджеты подсистем. В конце обсуждается парадокс Джевонса: когда улучшения снимают ограничение, разработчики тут же используют освободившиеся ресурсы на новые сценарии, создавая ещё большую сложность (например, системы управления резидентностью виртуальных текстур вместо простого стриминга).
Выводы автора:
- Сложность кода в играх — это не случайность, а прямое следствие жёстких технических ограничений (время кадра, память, размер билда), за которые программисты платят потерей простоты и модульности.
- Когда нужно оптимизировать по нескольким противоречивым критериям одновременно, абстракции разрушаются и архитектура вынуждена строиться вокруг деталей железа (процессорный кеш, структура памяти).
- Улучшение одного ограничения часто порождает новые требования и ещё большую сложность, потому что освободившиеся ресурсы сразу используют для новых сценариев (парадокс Джевонса).
В основе любого инженерного искусства лежит великая иллюзия контроля над хаосом и открывая пустой файл, мы искренне верим, что в этот раз архитектура точно останется кристально чистой.
Оригиналы:Откуда берётся сложность
Три поколения голосовых систем: от каскадных к полнодуплексным
Разработка и архитектура · ByteByteGo · 9/10
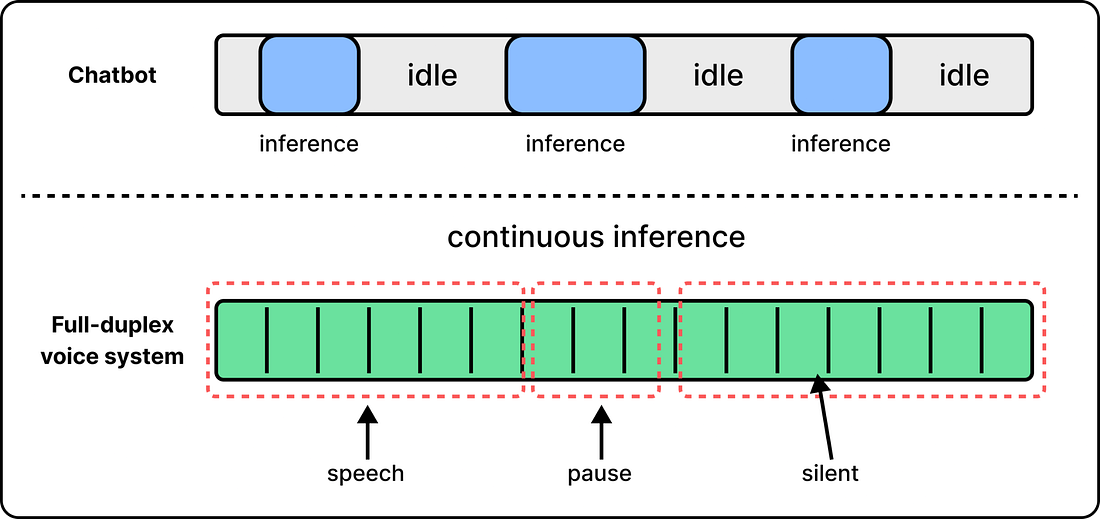
Материал разбирает эволюцию архитектуры голосовых ассистентов через три поколения: каскадные системы (ASR → LLM → TTS), разговорные речь-в-речь модели и полнодуплексные системы реального времени. Первое поколение страдает потерей информации (LLM видит только текст без тона) и медленностью (задержки складываются). Второе поколение обучает одну модель обрабатывать аудио напрямую, но требует детектора очередности, который часто срабатывает невовремя, создавая неестественность в общении. Третье поколение, представленное GPT-Live-1 (июль 2026), решает проблему через полнодуплексную архитектуру: модель одновременно слушает и говорит, генерируя токены на фиксированном цикле (примерно каждые 80 миллисекунд), где молчание — это просто токен молчания.
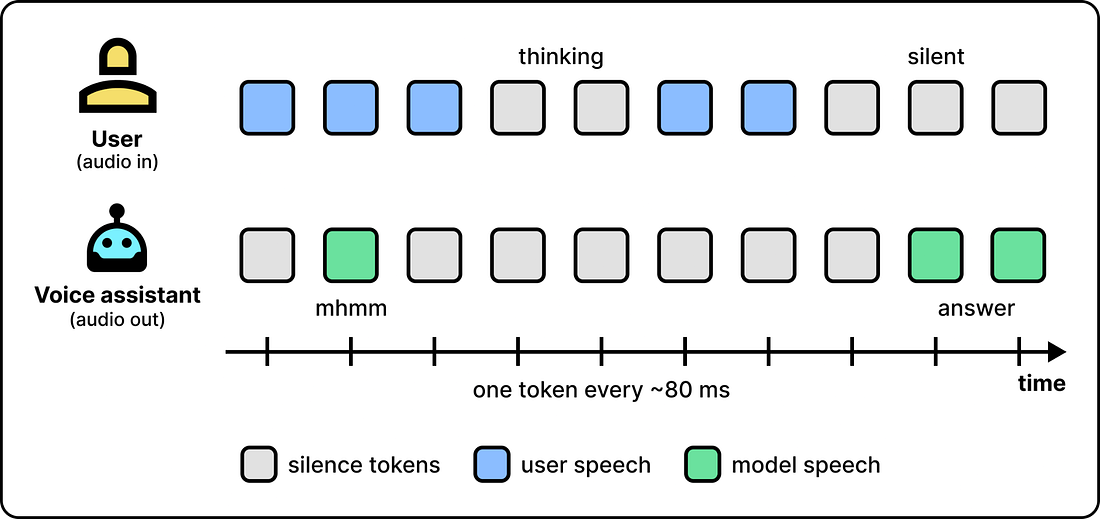
Ключевой инженерный подход GPT-Live — разделение говорения и думания: компактная голосовая модель ведёт диалог, а мощная модель (GPT-5.5) обрабатывает сложные запросы параллельно. Система использует два пути доставки: живой путь для аудиофреймов (каждые несколько миллисекунд) и асинхронный путь для остального. OpenAI разработала WARP (WebRTC Abridged Roundtrip Protocol) для ускорения установления соединения с одного раунда вместо шести. Для снижения стоимости непрерывного вывода каждую сессию держат загруженной на GPU, обрабатывая только новый фрейм вместо пересчёта всей истории.
Выводы автора:
- Полнодуплексная архитектура решает проблему неестественности разговора, убрав детектор очередности и позволив модели одновременно слушать и говорить в реальном времени.
- Разделение функций между компактной голосовой моделью и мощной рассуждающей моделью позволяет системе быстро отвечать, не теряя в качестве.
- Инженерные оптимизации (WARP для подключения, persistent GPU sessions, специализированные пути доставки) делают полнодуплексные системы практически масштабируемыми.
Полнодуплексная модель никогда не простаивает — аудио постоянно поступает в модель, и она непрерывно генерирует фреймы, даже когда пользователь говорит или делает паузу.
Автоматическое охлаждение данных в Tarantool Column Store: механизм и применение
Разработка и архитектура · Habr · 8/10
Статья разбирает механизм автоматического охлаждения данных в in-memory HTAP-системе Tarantool Column Store от VK Tech. In-memory системы держат активные данные в оперативной памяти для миллисекундного отклика, но RAM стоит дорого, а исторические данные часто нельзя удалять по регуляторным требованиям. Охлаждение решает эту проблему: автоматически переносит устаревшие записи на диск на основе политик TTL (Time-to-Live), освобождая память для горячих данных. Механизм работает фоновым процессом, который сканирует записи по возрасту, собирает их в крупные пакеты и атомарно записывает в формате Parquet. Текущая реализация рассчитана на append-only данные (логи, события) и предусматривает однонаправленное перемещение: записи на диске архивны и недоступны для изменения через SQL. Система гарантирует отказоустойчивость через снапшоты Iceberg и поддерживает работу в шардированных кластерах. Практически применяется в динамическом ценообразовании, рекомендательных системах, ERP и антифрод-системах банков, где нужна мгновенная обработка свежих данных при обязательном хранении многолетней истории.
Выводы автора:
- Охлаждение данных позволяет существенно снизить затраты на инфраструктуру, автоматически выгружая старые данные из дорогой оперативной памяти на дешевые диски без потери регуляторного соответствия.
- Механизм спроектирован для append-only сценариев (логи, события) и обеспечивает однонаправленное перемещение данных с поддержкой двух режимов доступа: только горячее хранилище для минимальных задержек или оба слоя параллельно для полной аналитики.
Охлаждение — это перемещение данных на более медленный, но всё ещё онлайн-доступный носитель в рамках активной системы, отличаясь от архивации выгрузкой данных в офлайн-хранилище с латентностью доступа в часы.
Как команда Битрикс24 интегрировала ICQ в корпоративный портал за хакатон
Разработка и архитектура · Habr · 7/10
Разработчики Битрикс24 создали прототип seek_you — частную ICQ-сеть поверх корпоративного портала, позволяющую использовать старый ICQ-клиент для общения с коллегами через Битрикс24 без промежуточных ботов. Главная идея: сотрудник запускает оригинальный ICQ Lite, его коллеги видят обычный чат в браузере или приложении Битрикс24, а сообщения синхронизируются через Python-мост, который переводит данные между устаревшим протоколом OSCAR и современным REST API Битрикс24. Архитектура состоит из трёх компонентов: open-oscar-server (GO-приложение, выступающее как ICQ-сервер на порту 5190), Python-мост (диспетчер сообщений и статусов), и облачный Битрикс24, подключаемый через вебхук. Система работает через WIM (внутренний HTTP-интерфейс сервера) и опрашивает Битрикс24 каждые три секунды на наличие новых сообщений. Ключевые технические решения: синтетические UIN вычисляются из ID сотрудников Битрикса (с смещением 10 млн для совместимости), кодировка кириллицы в CP1251 для старых клиентов, поддержка capabilities для отображения контактов в статусе онлайн. В прототипе также реализован демонстрационный контакт BitrIQ, который подключает ИИ-помощника BitrixGPT с ретро-стилем общения.
Выводы автора:
- Успешная интеграция несовместимых систем (старый ICQ и современный Битрикс24) достигнута через адаптер-мост, переводящий протоколы без использования промежуточных ботов.
- Архитектуру с отдельными прокси-сессиями для каждого контакта позволила добиться нативного отображения переписки от имени реальных сотрудников.
- Проект демонстрирует, что даже давно устаревшие системы можно интегрировать в современную инфраструктуру, но такие решения непригодны для production из-за отсутствия шифрования и использования костылей.
Один сотрудник запускает настоящий старый ICQ-клиент, его коллеги продолжают пользоваться обычным Битрикс24, и для них переписка выглядит как стандартный личный диалог — наше приложение работает за кадром.
XBRL-CSV 2.0: переход от агрегированной отчётности к детализированным данным
Данные и аналитика · Вестник НАУФОР · 7/10
Статья описывает новый подход Банка России к регуляторной отчётности профессиональных участников рынка ценных бумаг (ПУРЦБ) — формат XBRL-CSV 2.0, который позволяет представлять большие объёмы учётно-операционных данных в табличной форме с сохранением семантической строгости стандарта XBRL. Ключевая особенность заключается в сочетании компактного табличного представления с единой информационной моделью, регламентируемой таксономией Банка России (актуальная версия 6.1.0.10). В отличие от классической агрегированной отчётности, новая модель требует извлечения первичных операционных данных с максимальной детализацией и их структурирования в соответствии с требованиями регулятора. Процесс подготовки данных включает идентификацию источников, сопоставление внутренних объектов учёта с объектами таксономии, приведение значений к установленным типам и двухуровневую проверку — техническую валидацию (проверка корректности формирования пакета) и бизнес-валидацию (проверка согласованности данных и выполнения контрольных соотношений). Пакет XBRL-CSV 2.0 представляет собой ZIP-архив, включающий CSV-файлы с данными, сервисный файл mapping.json с метаданными и дополнительные материалы для валидации. Автор выделяет основные проблемы ПУРЦБ при внедрении: разрыв между внутренней и регуляторной моделями данных, большой объём учётно-операционной информации, требующий потокового подхода к обработке, и сложность файла mapping.json, который распределяет семантическую нагрузку между данными и метаданными.
Выводы автора:
- XBRL-CSV 2.0 — это технологический механизм представления структурированных данных, а не просто альтернативный формат CSV-файла; переход требует перестройки всего информационного процесса подготовки отчётности, а не замены одного формата другим.
- Успешное прохождение технической валидации не означает автоматической корректности отчётности; необходимо применять оба уровня контроля — техническую и бизнес-валидацию, включая проверку контрольных соотношений и логических связей между показателями.
- Регуляторная таксономия отличается от внутренних моделей данных организации, поэтому требуется построение слоя сопоставления, от качества которого зависит не только возможность технического формирования файла, но и достоверность представляемой информации.
XBRL-CSV 2.0 целесообразно рассматривать не как простой альтернативный формат CSV-файла, а как технологический механизм представления структурированных данных, в котором табличная форма является лишь внешним способом сериализации более сложной информ
А-ЦОД глазами инженера: что сертифицируют и как устроена защита
Кибербезопасность · Habr · 8/10
Статья разбирает устройство аттестованного сегмента дата-центра (А-ЦОД) с точки зрения инженера Selectel, развеивая миф о том, что сертифицируют сам ЦОД. На самом деле аттестуется объект информатизации — информационная система клиента, а не дата-центр как целое. А-ЦОД представляет собой выделенный сегмент (одна или несколько стоек) с собственным контуром защиты, сетевой архитектурой, системой контроля доступа и видеонаблюдением. ФСТЭК устанавливает требования к защите информации и сертифицирует конкретные средства защиты (межсетевые экраны, антивирусы, системы обнаружения вторжений), но не выдаёт сертификаты на дата-центры. Защита организуется многоуровневой системой: аппаратные файрволы, сетевая сегментация, многофакторная аутентификация, контроль действий администраторов, антивирусная защита, средства обнаружения атак, регистрация событий.
Доступ персонала в защищённый сегмент строго регламентирован — инженер должен пройти специальный курс и экзамен, а списки доступов регулярно проверяются. Аттестация проходит несколько этапов, включая физическую проверку оборудования с участием клиента и его аудитора, и не завершается получением аттестата — любое значительное изменение требует новых проверок. Сертификат на средство защиты не делает систему безопасной сам по себе; его эффективность зависит от правильной настройки и соблюдения регламента эксплуатации.
Выводы автора:
- Сертифицируются не дата-центры, а конкретные средства защиты информации и объекты информатизации; аттестованный сегмент требует многоуровневой защиты, а не просто одного файрвола.
- Для государственных и критичных систем аттестованный защищённый сегмент является не просто требованием регулятора, но реальным конкурентным преимуществом на рынке дата-центров.
Сертификат не делает систему безопасной. Идеальный сертификат у межсетевого экрана никак не помешает администратору открыть все порты и отключить логирование.
Оригиналы:А-ЦОД глазами инженера: зачем это дата-центру и что вообще там сертифицируют
Испания заблокировала Archive.today по требованию правообладателей
Кибербезопасность · Habr · 7/10
Комиссия по интеллектуальной собственности Министерства культуры Испании распорядилась заблокировать сервис Archive.today и его зеркала (Archive.is, Archive.ph, Archive.li) на основе жалобы неназванного правообладателя. При попытке доступа испанские пользователи видят государственное уведомление об «нелегальном» характере сайта с обвинением в содействии незаконному доступу к защищённому авторским правом контенту. Блокировка началась в середине августа с крупных операторов (Telefónica, Vodafone, Orange) и распространилась на других провайдеров согласно протоколу 2021 года, требующему блокировать зеркала в течение 24 часов. Archive.today – полезный инструмент для исследователей и журналистов, сохраняющий скриншоты страниц, удалённого или изменённого контента. Власти заявляют, что легальные источники контента способствуют развитию культуры и экономики, но в стране отмечают аналогичные блокировки спортивных сайтов, вызывавшие масштабные сбои интернета.
Выводы автора:
- Испанские власти применили блокировку к сервису архивирования веб-страниц Archive.today и его зеркалам на основании жалобы о нарушении авторских прав
- Блокировка осуществляется согласно протоколу 2021 года с участием правообладателей и крупных интернет-провайдеров, требующему удалить зеркала в течение суток
Archive.today сохраняет скриншоты веб-страниц, позволяя просматривать сайты и статьи, которые были удалены, изменены или находятся за платным доступом – полезный сервис для исследователей и журналистов
Оригиналы:Власти Испании распорядились заблокировать Archive.today и его зеркала
Северокорейские IT-специалисты устраиваются на удалёнку через посредников
Кибербезопасность · Habr · 7/10
Исследователи компании Silent Push обнаружили схему, позволяющую IT-специалистам из КНДР устраиваться в американские и европейские компании в обход санкций. Схема работает через посредников из США, ЕС и Латинской Америки, которые проходят собеседования от имени северокорейских кандидатов. Посредник общается с работодателем, проходит видеоинтервью и демонстрирует навыки, а задачи за него решает организатор через ПО удалённого доступа (AnyDesk, TeamViewer, Chrome Remote Desktop). Посредник получает зарплату и оставляет себе 35%, остаток переводит организатору схемы. Схема обнаружена благодаря объявлению пользователя tecguru113 на Discord-сервере Mouse Review, ищущего людей для роли «публичного лица» кандидата. Хотя прямого подтверждения североркорейского происхождения нет, на это указывают косвенные признаки: рекомендация использовать VPN Astrill (связан с северокорейскими хакерами), резкое прекращение диалога при упоминании КНДР, а также инфраструктурные, технические и финансовые данные.
Выводы автора:
- Северокорейские специалисты используют посредников для прохождения собеседований и выполнения работы через удалённый доступ, обходя географические санкции.
- Схема финансируется путём передачи 65% зарплаты организатору через посредника, оставляющего себе комиссию 35%.
- Такие атаки на рынок труда представляют угрозу для компаний, нанимающих удалённых сотрудников без надлежащей проверки личности.
Посредник получает зарплату и оставляет себе 35%, а остаток переводит организатору.
Как устроены платёжные сети Visa и Mastercard
Финтех и финансы · Habr · 8/10
Материал объясняет, чем на самом деле занимаются Visa и Mastercard — это не банки и не эмитенты карт, а карточные платёжные сети, обеспечивающие транзакции между держателями карт, эмитентами, мерчантами и эквайрерами. Visa и Mastercard отвечают за четыре ключевые функции: поддержание телекоммуникационной сети (дата-центров и оптоволоконных кабелей), координацию банковской сети для расчётов, установку комиссий и правил. Флагманский дата-центр Visa (Operations Center East в Ашберне, Виргиния) размером 13 тысяч квадратных метров защищён как золотой запас США — с гидравлическими преградами и биометрией. При типичной транзакции в 100 долларов мерчант платит торговую комиссию 2,5%, из которых 2% идёт банку-эмитенту (наибольшая доля из-за высокого кредитного риска), 0,15% — самой сети Visa, остальное — платёжному оператору. Visa выполняет роль адаптера между национальными банковскими системами, обеспечивая международные расчёты и конвертацию валют; на 30 сентября 2024 года компания держала ликвидность 11,2 миллиарда долларов для финансирования ежедневных расчётов, при этом максимальный дневной объём расчётных обязательств достигал 137,4 миллиарда долларов.
Выводы автора:
- Visa и Mastercard — это не банки и не эмитенты карт, а сетевые компании, управляющие коммуникационной и финансовой инфраструктурой для карточных платежей.
- При карточной транзакции основная комиссия (2%) идёт банку-эмитенту за взятие на себя кредитного и мошеннического риска, сама же сетевая компания получает лишь 0,15%.
- Visa действует как адаптер между национальными банковскими системами, обеспечивая международные расчёты и снижая необходимость прямых банковских связей для каждого участника сети.
Visa — это не только телекоммуникационная сеть, но и финансовая сеть банков, направляющая средства для расчёта благодаря финансовым связям со всеми сторонами.
Оригиналы:Чем занимаются Visa и Mastercard?
Скорость кода перестала быть узким местом: дефицит переместился в идеи
Продукт и карьера · Habr · 8/10
Статья анализирует парадигмальный сдвиг в IT-индустрии: если раньше компании оптимизировали дорогие человеко-часы разработчиков, то появление ИИ сделало написание кода дешевым и быстрым, обнажив настоящее узкое место — отсутствие денежных идей. За 30–40 лет менеджмент фокусировался на утилизации разработчиков; теперь MVP собираются за недели вместо кварталов, но большинство из них никому не нужны. ИИ позволил одному человеку снова выполнять роль лида или юнит-лида благодаря агентам и артефактам (вроде файла handoff), вместо пирамиды менеджеров. По данным Sensor Tower, в 2025 году в App Store вышло 600 тысяч новых приложений (+30% год к году), но загрузки выросли всего на 3% — это показывает, что все, кто хотел реализовать идеи, смогли это сделать, и оказалось, что большинство идей пустые. Статья указывает, что эта проблема не нова: COVID-волна запускала десятки сервисов на синергию суперприложений, NFT-цикл расходовал тысячи команд на бредовые проекты, которые закрывались; ИИ-волна повторяет паттерн на другом материале. С появлением ИИ легко скопируемые SaaS-продукты теряют конкурентное преимущество: клиент просто генерирует нужный инструмент промптом вместо того, чтобы покупать софт. IT-компании сокращают разработчиков не потому, что ИИ их заменяет, а потому что большую часть идей удалось проверить, и они оказались невостребованы и убыточны.
Выводы автора:
- Узким местом в IT стали не разработчик и не скорость кода, а генерация денежных идей и способность их валидировать.
- ИИ позволяет одному человеку работать как лид или юнит-лид с помощью агентов, что меняет организационную структуру с пирамиды менеджеров на модель «один человек + кольцо агентов».
- Легко копируемые продукты теряют ценность перед лицом ИИ; клиент предпочтёт сгенерировать нужный инструмент самостоятельно вместо покупки готового ПО.
Проблема не в том, что ИИ заменяет разработчиков. Проблема в том, что можно проверить все идеи, и стало видно, что денежных просто нет.
Оригиналы:Скорость разработки кода перестала быть дефицитом. Дефицитом стали денежные идеи
Ценовая конституция: как избежать бесконечных споров о монетизации
Продукт и карьера · Elena's Growth Scoop · 8/10
Статья посвящена необходимости создания единого документа – ценовой конституции – который устанавливает философию и правила компании по вопросам прайсинга и упаковки продуктов. С ускорением темпов разработки ПО растёт число решений о монетизации новых функций, и без согласованной политики каждый запуск становится отдельным конфликтом между отделами. Автор предлагает пять основных принципов конституции: взимать плату за добавленную ценность, а не за устранение созданных компанией проблем; монетизировать результаты, а не входные данные; сознательно оставлять часть ценности немонетизированной (инвестируя в рост); максимально упростить модель прайсинга и установить четкие правила взаимодействия каналов продаж (self-serve и Sales).
Компании также нужен Совет по монетизации, который будет следить за соблюдением принципов как высший суд. Хорошая конституция должна быть ограничивающей и предусматривать жесткие компромиссы, тогда она действительно обеспечит согласованное и быстрое принятие решений по всей организации.
Выводы автора:
- Компания должна установить единую ценовую и упаковочную философию, зафиксировав её в документе, чтобы избежать повторяющихся конфликтов между отделами при каждом запуске новой функции.
- Четыре основных принципа: не взимать плату за устранение самостоятельно созданных препятствий, монетизировать результаты, а не процесс, стратегически оставлять часть ценности свободной для роста и максимально упростить модель прайсинга.
- Хорошая конституция должна быть ограничивающей и требовать реальных жертв; если она ничего не стоит организации, значит, она не работает правильно.
Если вы предоставите клиентам несколько способов покупки, они выберут тот, который предпочитают. Это не должно быть неожиданностью, но мы всё ещё ведём себя так, словно личность оскорблена.
Коротко
Прочее
- Compositor — открытый фоторедактор от разработчика Google и Apple – Бывший дизайнер и разработчик Google Glass и Apple Vision Pro Робби Тилтон представил Compositor — бесплатный открытый фоторедактор для macOS как альтернативу дорогому Photoshop.