Дайджест за 22 сентября 2026
ИИ-агенты окончательно меняют правила разработки — от того, как мы пишем код, до архитектуры всех систем, а Meta и Warp уже показывают, что это работает в боевых условиях. Параллельно взлетают технологии для работы с данными и новые генеративные модели, включая Qwen с поддержкой прозрачности, но главное — разработчикам становится всё проще запускать мощные системы на скромном железе. Если ты занимаешься tech-стеком, в дайджесте сегодня почти всё про то, как не отстать от трансформации, которая происходит прямо сейчас.
Главное
- Номерные радиостанции: криптографическая битва СССР и Запада в годы ВМВ
- Как ИИ-агенты изменили разработку: от кода к спецификации
- Apache Iceberg и Polaris: как работает каталог в современном озере данных
- Meta Muse: персональный AI-агент с правильным UX для обычных пользователей
- Как Warp доставляет 2000 PR в месяц с помощью ИИ-фабрик
Подробно
Meta Muse: персональный AI-агент с правильным UX для обычных пользователей
ИИ и агенты · Lenny's Newsletter · 9/10
В подкасте Claire детально тестирует Meta Muse — персональный AI-агент, разработанный для повседневных пользователей без технического бэкграунда. Материал показывает, как Muse управляет семейным календарём, создаёт красивые утренние информационные письма, отслеживает личные цели и запрашивает разрешение перед действиями с чувствительными данными. Ключевая особенность — Meta привнесла опыт разработки Facebook и Instagram в создание доверия к AI: интерфейс избегает терминалов и ошибок, запросы на разрешение приходят в нужный момент, а не оперативно. Muse произвёл лучший вариант семейной новостной рассылки с первой попытки, включив полезные детали, которые пользователь не просил. Прозрачный лог активности показывает все вызовы инструментов и шаги агента — это даёт пользователям необходимый уровень доверия. Однако использование браузера остаётся слабым местом: агент испытывал сложности с поиском конкретных товаров и покупками. Дизайн включает анимированный аватар, который визуализирует состояние агента (поднимает ноутбук при выполнении задач, сферу при создании медиа). Словарь продукта (лента, идеи, цели, библиотека) специально избегает технических терминов вроде «cron» и «плагины», что делает агента доступным для широкой аудитории.

Выводы автора:
- Meta использовала свой опыт в создании доверительного UX у непрофессиональных пользователей, что выделяет Muse среди других агентов на рынке и создаёт бесшовный опыт без трения.
- Дизайн запросов разрешений критически важен: Muse спрашивает в нужный момент, подтверждает найденную информацию и проверяет перед действием, что является образцом для обработки личных данных.
- Персональные цели требуют иной продуктовой модели, чем одноразовые задачи: Muse отслеживает прогресс через несколько итераций и поддерживает тёплый, специфичный тон без навязчивости.
Это то, как выглядит работа на вершине мастерства — не просто отполированные углы и чистые иконки, а использование возможностей генерации изображений и анимации для решения проблем UX, которые раньше невозможно было решить.
Оригиналы:Подкаст: Meta Muse review + Как Warp отправляет 2000 PR в месяц с AI factories · Meta Muse Review: персональный AI-агент для семейной жизни · Прослушать на YouTube
Как Warp доставляет 2000 PR в месяц с помощью ИИ-фабрик
ИИ и агенты · Lenny's Newsletter · 9/10
Материал рассказывает о программной фабрике Wilson от Warp – платформе агентной разработки, которая автоматизирует весь цикл разработки: от запроса в Slack через создание тикета, реализацию, code review до merge-а PR. Ключевая идея: ИИ-фабрика – это не просто быстрый кодирующий агент, а полный конвейер производства, координирующий весь процесс разработки, первый PR готов за 35 минут.
Зач Ллойд (CEO Warp) выделяет главные метрики успеха: количество человеческих взаимодействий на PR (чем их меньше, тем выше реальная пропускная способность) и система оценки каждого запуска агента через AI-судью по нескольким параметрам. Узким местом сейчас остаётся человеческий code review: агент справляется за 35 минут, но первый ревью приходит через 3,5 часа. Компания нашла лучший способ бенчмаркинга: вместо публичных лидербордов (SWE-bench, Terminal-Bench) они проигрывают реальные задачи фабрики с разными конфигурациями моделей и строят собственные кривые Парето цена-качество. Выбор модели оказался главным рычагом стоимости. Фабрика может улучшать себя сама, потому что её конфигурация хранится как код: собирая около 20-25 примеров неудач, агент-наблюдатель анализирует проблемы и предлагает изменения в определения агентов. За пределами инженерии ИИ становится ценнее, когда подключен к реальным бизнес-данным (анализ транскриптов продаж, создание листов переобращения). Однако фабрика не решает, что строить – это остаётся делом традиционных пользовательских интервью, дизайна и вкуса продакт-менеджера.
Выводы автора:
- Программная фабрика – это полный облачный конвейер разработки, а не просто быстрый кодирующий агент; она координирует весь цикл от заявки до merge без участия человека.
- Метрика «человеческие взаимодействия на PR» лучше всего показывает реальную эффективность фабрики, так как человек остаётся узким местом в цепочке.
- Компания должна бенчмаркировать агентов на своих реальных задачах и собственных метриках качества, а не на публичных лидербордах, подстраивая выбор модели под кривую цена-качество.
Разница между фабрикой и кодирующим агентом – это разница между конвейером и одним станочником. Один завершает задачу. Другой координирует весь производственный процесс.
Оригиналы:Подкаст на YouTube, Spotify, Apple Podcasts · Подробный разбор фабрики Warp · Как построить автоматизированную фабрику разработки
Единый граф зависимостей: как предотвратить разрушение архитектуры ИИ
ИИ и агенты · Modern Data 101 · 9/10
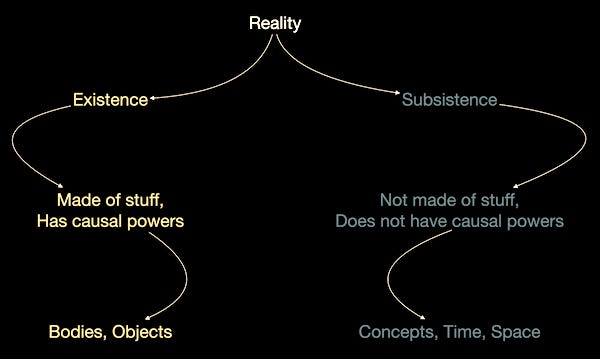
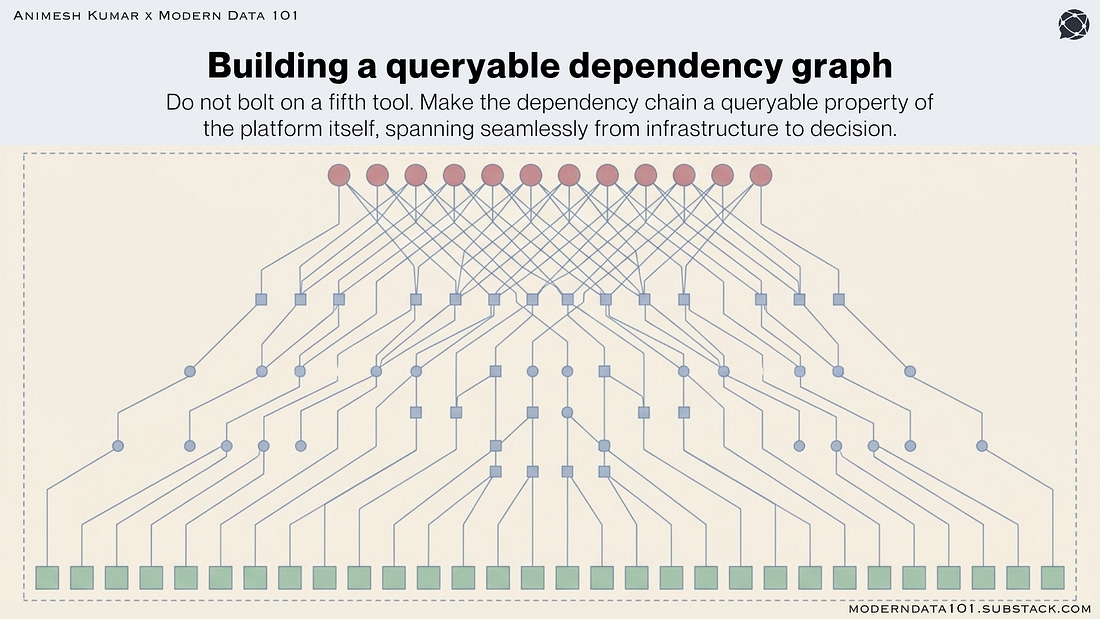
Материал предлагает применить древнестоическое различие между существованием и субсистенцией для проектирования современных платформ данных. Автор указывает, что каждая платформа имеет две части: инфраструктурную (физические данные в хранилище) и производную (метрики, фичи, предсказания моделей), которые полностью зависят от инфраструктуры, но к ней не сводятся. Проблема в том, что большинство организаций проектируют только первую часть, оставляя вторую архитектурно недисциплинированной.
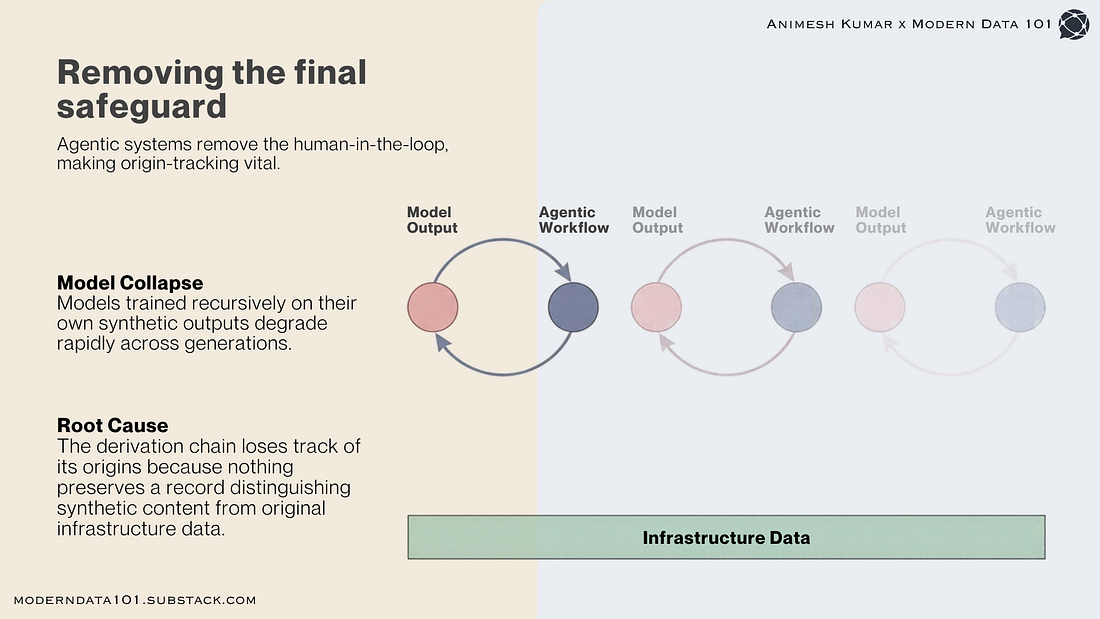
Текущие инструменты (каталоги, семантические слои, governance, ML-слои) не взаимодействуют: каталог индексирует таблицы, но не метрики; семантический слой определяет смысл метрики, но не может отследить исходные колонки три преобразования выше; слой управления скрывает персональные данные, но не видит, кодируют ли производные фичи тот же сигнал в другом виде. Масштабирование ИИ-систем усложняет проблему: каждая добавленная модель создаёт новый уровень зависимостей, что рождает явление CACE (changing anything changes everything) — изменение одного входа меняет поведение всей системы без обнаружения. Агентные системы усугубляют ситуацию: когда выход одной системы становится входом другой и вновь используется для обучения, цепь зависимостей теряет человеческую проверку, что приводит к моделям-коллапсам (как показано в исследовании Shumailov et al., 2024).
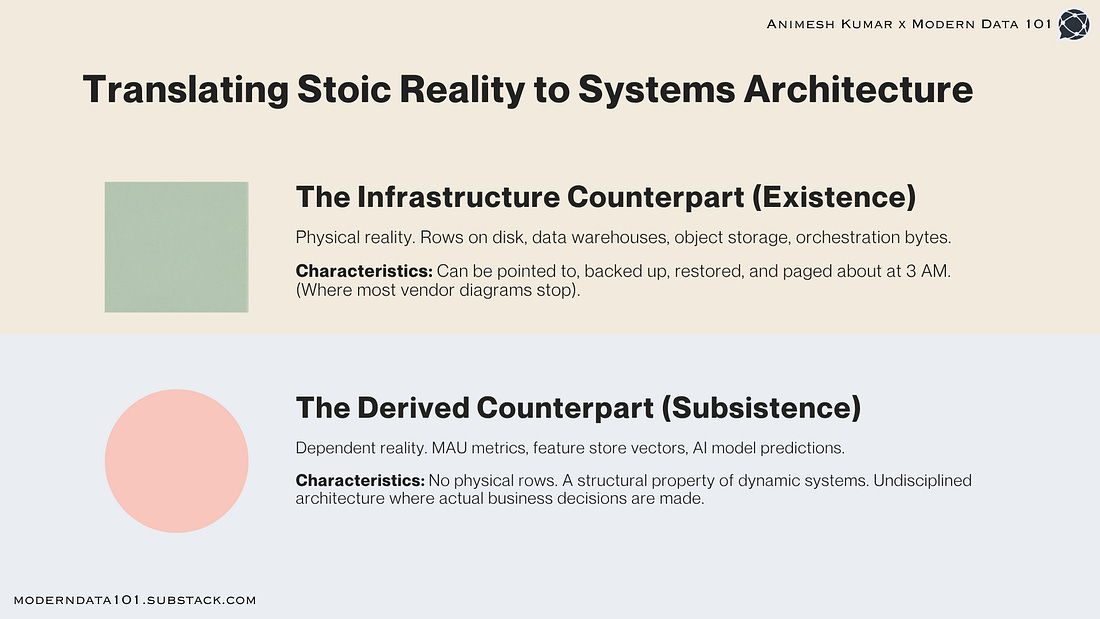
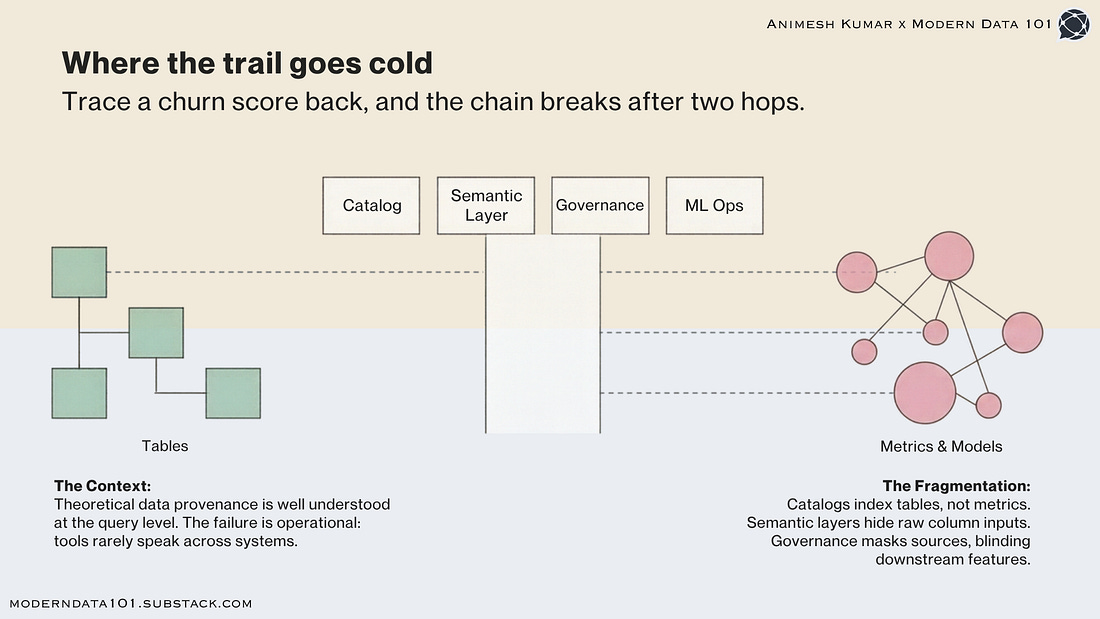
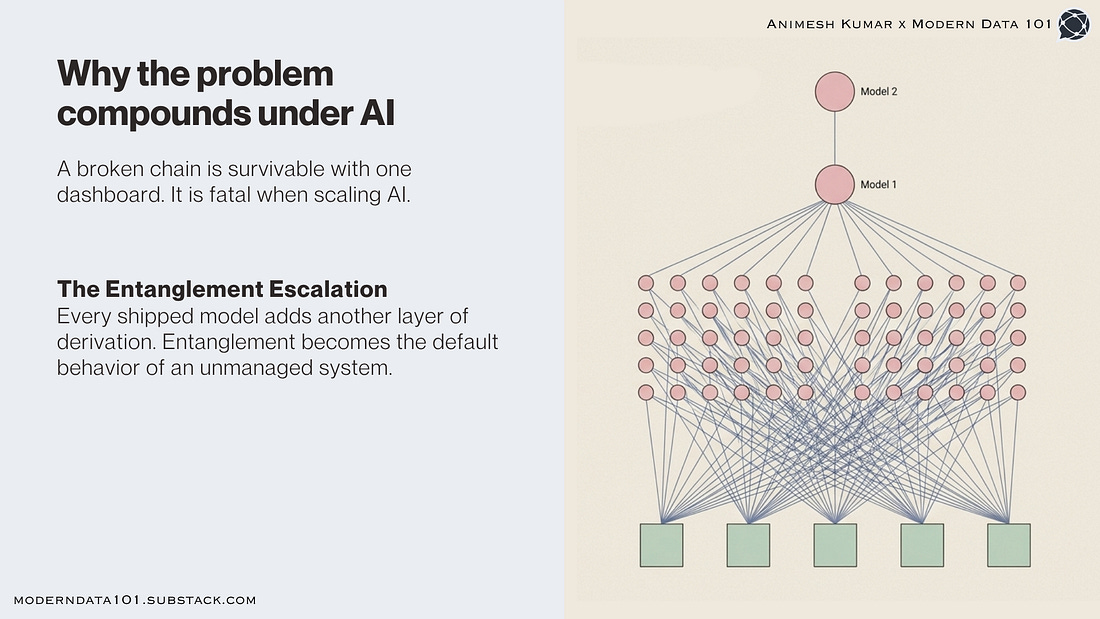
Решение не требует пятого инструмента: нужно сделать цепь зависимостей опрашиваемым свойством самой платформы, от инфраструктуры до решений. Это означает: линейность на уровне колонок (не таблиц), семантический слой как опрашиваемый объект (не SQL-строка в дашборде), автоматическое отслеживание зависимостей в feature store и model registry, где каждый выход ИИ носит машиночитаемый указатель на точные входы и версию модели. Эти возможности уже существуют в промышленности, но обычно закупаются как разрозненные решения вместо единого графа зависимостей.
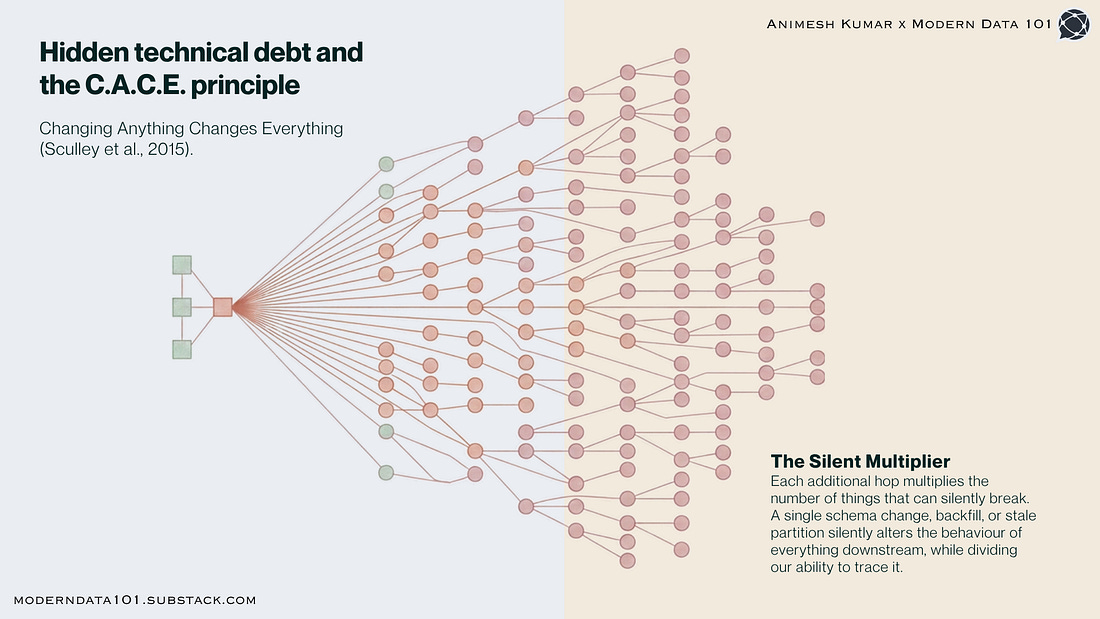
Выводы автора:
- Платформа данных должна проектироваться как единый граф зависимостей от инфраструктуры (физических данных) до решений (метрик и предсказаний), а не как две отдельные системы.
- Отсутствие полной трассировки зависимостей приводит к явлению CACE и опасности model collapse, когда системы теряют контроль над своими источниками в результате масштабирования ИИ.
- Решение архитектурное, а не технологическое: необходимо объединить существующие инструменты (column lineage, semantic layers, feature store metadata, model registries) в единую связанную систему.
Платформа, которая не может отследить свою производную часть, не просто сложна в отладке — при компенсировании она в конце концов не может быть уверена в том, на что она смотрит.
Оригиналы:The Unified Dependency Graph: Stop Agentic AI From Outrunning Its Own Architecture
Как LLM помогли разработать эмулятор ZX Spectrum: от архитектуры к защитам от копирования
ИИ и агенты · Habr · 8/10
Третья часть серии о разработке эмулятора ZX Spectrum с помощью различных LLM (Qwen, GLM, Sol, DeepSeek, Claude). Автор рассказывает о практическом применении языковых моделей в сложном проекте эмуляции ретро-компьютера, их сильных и слабых сторонах. На основе доступа к исходникам других эмуляторов модели сумели спроектировать архитектуру, переписать код Z80 и ULA, реализовать дисковые контроллеры (WD1793 и NEC μPD765). Автор отмечает, что LLM достигли уровня junior-разработчиков и обладают широтой знаний, превосходящей обычного человека. Однако они показали полный ноль при работе с незнакомыми форматами данных (дисковые образы DSK/EDSK) и требовали постоянного наведения на правильный путь. Особенно сложной оказалась работа с различными защитами от копирования дисков: слабые сектора, нестандартные размеры данных в заголовках, контрольные суммы и другие хитрости. Модели требовали явного указания смотреть в другие эмуляторы, затем парсить и сравнивать их код пошагово. В итоге эмулятор смог загружать подавляющее большинство классических игр, включая защищённые от копирования.
Выводы автора:
- LLM за год развития достигли уровня junior-разработчиков, способных к реализации сложных архитектурных решений и самостоятельному дизассемблированию кода, но нуждаются в явных указаниях при работе с нестандартными данными
- Модели показали критическое слабое место при решении нетипичных задач без референсного кода – практически полную неспособность справиться самостоятельно, даже если необходимая информация есть в их обучающем наборе
- Эффективный метод работы с LLM в сложном проекте – это предоставление примеров из готовых решений (других эмуляторов) и пошаговое сравнение поведения реальной системы с модельной реализацией
За год БЯМки сильно подросли в своих умениях. Сегодня я смело могу утверждать, что по своему уровню они достигли джунов. Если убрать скорость и стоимость за скобки, то это почти настоящие кожаные мешки.
Оригиналы:LLM против ZX Spectrum. Часть 3
Техдиректор Microsoft портировал утилиту на macOS с помощью ИИ за два дня
ИИ и агенты · Habr · 8/10
Марк Руссинович, технический директор Microsoft Azure, использовал ИИ для портирования своей утилиты ZoomIt с Windows на macOS всего за выходные. ZoomIt — это инструмент для масштабирования экрана, рисования аннотаций, записи и редактирования видео, который Руссинович поддерживает более 20 лет и который часто запрашивали демонстраторы продуктов Microsoft на Mac. Главное преимущество ZoomIt перед стандартными инструментами скриншотов заключается в том, что он работает в реальном времени поверх приложений и может записывать видео, звук и экран одновременно. Руссинович потратил около получаса и дюжину запросов к ИИ на создание базовой версии, затем добавлял функции в течение выходных, включая таймеры перерывов, панорамные скриншоты и редактирование видео. Ключевая роль ИИ была в том, что он не только портировал исходный код, но и самостоятельно разобрался в специфике macOS для реализации захвата экрана и звука, избавив разработчика от необходимости изучать новую платформу. Программа выпущена как бесплатное ПО с открытым исходным кодом, требует macOS 14 Sonoma или новее, весит 1,4 МБ и доступна на GitHub Microsoft.
Выводы автора:
- ИИ позволил опытному разработчику за два дня портировать сложное приложение на незнакомую платформу, минуя необходимость глубокого изучения её особенностей.
- Генеративные модели оказались особенно эффективны в задачах трансляции кода и функциональности между платформами благодаря доступу к исходному коду как справочному материалу.
Мне не пришлось ничего изучать — система сделала всё сама, говоря о специфических для платформы механизмах, с которыми я ожидал столкнуться при разработке.
Оригиналы:Техдиректор Microsoft Azure портировал ZoomIt на macOS с помощью ИИ за два дня
Alibaba выпустила Qwen-Image 2.1 с генерацией прозрачных изображений
ИИ и агенты · Habr · 8/10
Alibaba опубликовала веса модели Qwen-Image 2.1, которая объединяет генерацию и редактирование изображений с поддержкой прозрачных фонов. Генеративный компонент построен на 32-слойном диффузионном трансформере DiT с 7 млрд параметров и дополнен визуально-языковой моделью Qwen3-VL 8B для обработки текста. Модель работает в нативном разрешении 2K (до 2752×1536) и поддерживает ряд инновационных возможностей: одновременная обработка до десяти референсных изображений, редактирование через маски и локальные области, генерация объектов с прозрачностью в формате RGBA. Архитектура включает KV-кеш для ускорения работы с несколькими изображениями и автоэнкодер с 16-кратным пространственным сжатием. По заявлениям Alibaba на собственном бенчмарке Qwen-Image-Bench модель превосходит большинство закрытых конкурентов по качеству текста, портретной подсветки и деталей, однако независимые тесты ещё отсутствуют. Веса доступны на Hugging Face и ModelScope с лицензией Qwen Research License, позволяющей использование только в некоммерческих целях; коммерческое применение требует отдельного соглашения с Alibaba. Модель уже поддерживается Diffusers, ComfyUI, vLLM-Omni и SGLang.
Выводы автора:
- Qwen-Image 2.1 — это первая открытая модель, объединяющая генерацию и редактирование изображений с нативной поддержкой прозрачности (RGBA) и работой с десятью референсами одновременно.
- Архитектура с KV-кешем и 32-слойным трансформером DiT позволяет эффективно обрабатывать сложные сценарии редактирования, но коммерческое использование ограничено специальной лицензией Alibaba.
Семимиллиардный генератор, нативная прозрачность и работа сразу с десятью референсами делают её хорошим вариантом для локальных экспериментов.
Оригиналы:Alibaba выпустила Qwen-Image 2.1 с генерацией прозрачных изображений
Как запустить большую LanguageModel на дешёвом оборудовании
ИИ и агенты · ByteByteGo · 8/10
Статья разбирает техники запуска крупных AI-моделей на скромном оборудовании — фундаментальную проблему локальной разработки. Большая модель занимает значительный объём памяти: 8-миллиардная модель с 16-битной точностью требует ~16 ГБ только для весов, плюс дополнительная память на временные вычисления и промежуточные результаты. Память распределена между RAM, VRAM графического ускорителя и SSD, и они работают с разной скоростью — это создаёт узкие места. Чтение весов из памяти (пропускная способность) часто становится критическим ограничением, особенно на этапе декодирования, когда модель генерирует выходные токены по очереди. Автор подробно описывает пять основных техник оптимизации. Квантизация снижает точность представления весов (например, с 16 до 4 бит), что сокращает объём памяти с 16 ГБ до 4 ГБ, но может снизить качество ответов. Послойная разгрузка (layer-wise offloading) держит веса в RAM и загружает их на GPU по мере надобности, снижая требования к VRAM ценой замедления из-за перемещения данных. Mixture of Experts использует архитектурный подход: вместо обработки каждого токена всеми слоями модель направляет токены только через выбранные подсети-эксперты, экономя вычисления, но требуя хранить все эксперты в памяти. Дистилляция учит меньшую модель на основе большой, а прунинг удаляет менее важные нейроны. Спекулятивное декодирование предлагает несколько токенов перед проверкой. Локальное выполнение имеет смысл для экспериментов, работы с приватными данными и офлайн-доступа, но не всегда дешевле облачных сервисов — это зависит от частоты использования и времени отклика.
Выводы автора:
- Запуск крупной модели локально требует выбора между тремя компромиссами: снижение объёма памяти (квантизация, дистилляция, прунинг), снижение вычислений (Mixture of Experts, спекулятивное декодирование) или смещение нагрузки на медленнее хранилище (layer-wise offloading).
- Пропускная способность памяти часто является узким местом — даже если модель физически помещается в памяти, её медленная передача между хранилищами может сделать инференс непригодным для интерактивного использования.
- Локальное выполнение экономически целесообразно для проектов с высокой частотой использования, приватными данными или требованиями к офлайн-доступу, но для редкого использования облачные сервисы могут быть дешевле.
Большая модель может работать на скромном оборудовании только путём снижения занимаемой памяти, уменьшения выполняемых вычислений или перемещения части работы на более медленное хранилище.
Claude Code теперь поддерживает AGENTS.md для унифицированных инструкций агентам
ИИ и агенты · Habr · 7/10
Anthropic добавили в Claude Code 2.1.277 поддержку стандартного формата AGENTS.md — файла с инструкциями для работы с проектом, который используют более 60 тысяч open source проектов и поддерживают другие инструменты вроде GitHub Copilot, Cursor и Devin. Раньше Claude Code ориентировался только на собственный формат CLAUDE.md, что заставляло команды дублировать правила в разных файлах, что приводило к рассинхронизации инструкций между агентами. Теперь Claude Code сначала ищет CLAUDE.md (и его варианты), а если его нет — загружает AGENTS.md. Через команду /config можно настроить режим работы: загружать только один тип, использовать оба или только корпоративные инструкции. Поддерживаются и вложенные AGENTS.md в подпапках, что позволяет хранить общие правила в корне, а специфичные для каждого сервиса — отдельно. Однако важно помнить, что загруженный AGENTS.md не отображается в списке Memory files, а сам файл не заменяет настройки безопасности — для реальной защиты нужны ограничения разрешений и sandbox. На момент релиза фича не работает через Amazon Bedrock, Google Vertex AI и Microsoft Foundry.
Выводы автора:
- Claude Code теперь использует стандартный AGENTS.md вместо собственного CLAUDE.md, позволяя командам хранить инструкции в одном месте и избежать проблем с дублированием и рассинхронизацией.
- Файл AGENTS.md поддерживает вложенную иерархию, что удобно для проектов с несколькими сервисами с разными правилами.
- AGENTS.md — это просьба, а не обязательное ограничение; для реальной безопасности нужны технические меры типа sandbox и разграничения прав.
Команду тестирования обновили в одном файле, во втором забыли, и агенты получили разные инструкции. Теперь базовые правила можно хранить в одном месте.
Оригиналы:Claude Code научился читать AGENTS.md
Как ИИ-агенты изменили разработку: от кода к спецификации
Разработка и архитектура · Habr · 9/10
Статья исследует, как генерация кода с помощью ИИ-агентов трансформирует процесс разработки. Автор создал прототип приложения за два месяца и обнаружил парадокс: написание самого кода заняло минимум времени, но вся сложность переместилась на другие аспекты — продуктовую стратегию, обработку ошибок, контроль качества. По аналогии с экономикой инфраструктуры (сервер как скот), генерация делает дешевой саму реализацию, но делает дорогой проверку и замену кода без риска потерять накопленное системой знание. Вместо того чтобы оставаться источником знания о системе, код превращается в одноразовый артефакт, а знание мигрирует в спецификацию. Главный вывод: разработка переходит от задачи «написать код» к задаче «описать, что система должна делать и что она обязана сохранять при любых изменениях». Спецификация становится главным артефактом, код — производной от неё. Это возвращает разработку к идеям Фреда Брукса о том, что сущностная сложность задачи куда выше ручного труда её реализации. Автор предостерегает от смешивания режимов: проверка гипотезы (быстрое генерирование) хороша для прототипов, но превращение её в основу production-системы оборачивается счётом на третий месяц.
Выводы автора:
- Генерация кода дешевеет, но проверка её результатов дорожает: выигрыш в скорости создаёт счёт за валидацию и риск управления техдолгом
- Спецификация должна стать единственным местом хранения системного знания, иначе при частых регенерациях система теряет накопленную мудрость и инварианты, выученные на реальных сбоях
- Пропала привязанность к языкам и стекам — они теперь выбираются на неделю, а не на годы, но зато критичным стало понимание границ компонентов и то, какие проверки доказывают корректность замены
Проблема уже не в том, чтобы произвести код, а в том, чтобы безопасно его заменить. Раньше нас берегла дороговизна, теперь не подумаешь ни разу, потому что дёшево. А риск никуда не делся.
Tatarnetes: Kubernetes по-татарски с чаем и классикой
Разработка и архитектура · Habr · 8/10
Разработчики создали Tatarnetes — национальную обёртку над Kubernetes с полной локализацией на татарский язык. Проект включает три компонента: сам Tatarnetes (командная обёртка), TatarOS Linux (система для развёртывания кластера) и Tatarnetes UI (графический интерфейс). Реализация выполнена на чистом bash 3.2 без внешних зависимостей, поддерживает три системы письма (кириллица, латиница, арабское письмо), включает первый черновик татарской IT-терминологии для облачных технологий. Архитектура представляет собой тонкую безопасную обёртку над kubectl, обрабатывающую перевод команд, выполнение и оформление ответов национальными декорациями. Система реализует детерминированный график чайных перерывов (три окна по 7 минут в сутки), когда кластер вежливо прерывается на чай с молоком. Интересные инженерные решения: локализация через сгенерированную из .po файлов bash case-функцию без gettext-зависимостей, автоматическое согласование множественного числа по гармонии гласных, трансформация между письменностями без дополнительных словарей, обработка ошибок kubectl с татарскими подсказками. Культурный контент (стихи Габдуллы Тукая, пословицы) внесён в корпус с проверкой источников для борьбы с галлюцинациями. Проект выпущен под лицензией Tatarch 2.0 (эквивалент Apache 2.0 с татарской эпической преамбулой) и посвящён развитию цифровизации татарского языка.
Выводы автора:
- Tatarnetes демонстрирует возможность реализации сложной локализации на чистом bash без внешних зависимостей, с поддержкой множественного числа через гармонию гласных и трансформацией между тремя письменностями.
- Проект вносит практический вклад в цифровизацию татарского языка, создав первый черновик IT-терминологии для облачных технологий, который может развиваться через pull request сообществом носителей языка.
- Детерминированные чайные перерывы (выход 42) и национальный характер (бережливость, гостеприимство) интегрированы как полезные фичи, а не декоративные элементы.
Туган тел (родной язык) заслуживает того, чтобы жить не только в стихах, но и в терминале!
Оригиналы:Tatarnetes на Habr
Почему аналоговые компьютеры проиграли цифровым: арифметика точности
Разработка и архитектура · Habr · 8/10
Статья разбирает историю аналоговых компьютеров и объясняет, почему они в 1950–70-х годах были вытеснены цифровыми машинами, несмотря на кажущиеся преимущества. Аналоговые компьютеры (например, EAI PACE 231R, использовавшиеся в 1956 году для тренажёра ракетоплана X-15) решали дифференциальные уравнения в реальном времени, собирая из операционных усилителей, резисторов и конденсаторов физическую модель системы. Однако решающая проблема — точность. Если точность цифровой машины растёт линейно с добавлением разрядов (один бит = один триггер), то у аналога она определяется качеством деталей: резистор на 0,1% даёт ровно 0,1% точности и ничего не даст ниже.
Реальные аналоговые машины редко превышали 0,01% точности (примерно 13 бит), тогда как калькулятор 1974 года считал с 27–33 битами. Улучшить аналоговую машину на один бит требует деталей вдвое точнее; цена масштабируется экспоненциально. Кроме того, температурные колебания и дрейф деталей быстро «съедают» весь бюджет точности — даже открытая форточка могла вывести машину из строя. К 1970-м годам цифровые компьютеры научились обрабатывать полёты самолётов в реальном времени, и последнее преимущество аналога исчезло. Параллельно развивались гибридные системы, где аналоговая часть выполняла расчёты, а цифровая управляла процессом. К 1992 году практически все аналоговые машины вышли из употребления везде одновременно — не из-за заговора, а из-за фундаментальной разницы в экономике масштабирования точности. Современный ренессанс аналога касается лишь специальных применений: матричного умножения в памяти для нейросетей, где точность 4–8 бит достаточна и аналоговые вычисления экономят энергию на передаче данных.
Выводы автора:
- Точность аналоговых машин в 0,1–1% была непреодолимым потолком, так как улучшение требует экспоненциально дорогих компонентов, тогда как цифра масштабируется линейно.
- К 1970-м годам цифровые компьютеры достаточно ускорились, чтобы обрабатывать задачи реального времени, и единственное настоящее преимущество аналога исчезло.
- Современный возврат аналоговых вычислений ограничен специализированными задачами низкой точности (нейросети на 4–8 битах), а не универсальными машинами.
Аналоговой машине нужны не транзисторы. Ей нужны точные резисторы, точные конденсаторы и усилители с маленьким дрейфом нуля. Каждый следующий бит точности стоит в четыре раза больше кремния.
Оригиналы:Аналоговые компьютеры решали уравнения мгновенно. Почему это их не спасло
Бюро 1440 протестировало спутниковый интернет в Арктике
Разработка и архитектура · Habr · 7/10
Российская аэрокосмическая компания «Бюро 1440» провела практическое тестирование своей низкоорбитальной спутниковой системы связи в заполярном посёлке Нельмин-Нос, используя её для организации дистанционного электронного голосования. Испытание выполнено совместно с Центральной избирательной комиссией в рамках подготовки сервиса к эксплуатации и демонстрирует применение спутниковой связи в регионах без устойчивого наземного покрытия. Компания развёртывает низкоорбитальную группировку «Рассвет» и планирует запустить 292 спутника к 2030 году с финансированием 102,8 млрд рублей из федбюджета и 329 млрд рублей собственных средств в рамках нацпроекта «Экономика данных». Абонентские терминалы «Бюро 1440» имеют габариты 60×60 см, вес менее 15 кг, пропускную способность до 1 Гбит/с и работают в диапазоне -40 до +40 °С. Компания разрабатывает специализированные версии терминалов для авиации (включая сотрудничество с «Аэрофлотом») и железных дорог, используя технологию активных фазированных антенных решёток для автоматического поиска и удержания связи со спутником.
Выводы автора:
- Бюро 1440 переходит от экспериментальных испытаний к созданию операционного сервиса спутниковой связи, развёртывая группировку из 292 аппаратов к 2030 году
- Практические тесты на железной дороге и в удалённых населённых пунктах позволяют компании проверить готовность технологии к реальным применениям перед массовым развёртыванием
- Российские производители авиации (Sukhoi, МС-21, Ту-214) и транспорта активно вовлечены в адаптацию спутниковых терминалов к специфическим отраслевым требованиям и стандартам безопасности
Запуск первых аппаратов целевой группировки означает переход от экспериментов к созданию сервиса связи. Команда Бюро 1440 прошла этот путь за 1000 дней.
Оригиналы:В «Бюро 1440» протестировали спутниковый интернет в Нельмин-Носе
Apache Iceberg и Polaris: как работает каталог в современном озере данных
Данные и аналитика · Habr · 9/10
Статья разбирает архитектуру Apache Iceberg — открытого формата для работы с таблицами поверх файлов в объектном хранилище (S3). Iceberg решает проблему голых Parquet-файлов, добавляя слой метаданных, который позволяет работать с ними как с единой таблицей: поддерживает транзакции, историю версий (путешествие во времени), эволюцию схемы и одновременное чтение-запись разными движками (Spark, Trino, ClickHouse, DuckDB). Критический компонент Iceberg — это каталог, который хранит указатель на актуальную версию таблицы. Именно каталог обеспечивает атомарность коммитов через compare-and-swap операцию, предотвращая потерю данных при одновременной записи. На S3 без каталога два писателя могут затереть друг друга данные, и ошибка не будет заметна в логах. Polaris (изначально от Snowflake, теперь проект Apache) — главный претендент на роль универсального каталога для Iceberg, хранящий метаданные в обычной реляционной БД (PostgreSQL). Контроль над каталогом означает контроль над данными, правами доступа и решением, какие движки вообще увидят таблицы, поэтому борьба вендоров переместилась с формата данных на уровень каталога.
Выводы автора:
- Iceberg решает проблему работы с озёрами данных, превращая набор файлов в полноценную таблицу с транзакциями и историей версий, но данные остаются в открытом формате на дешёвом S3.
- Каталог — это не вспомогательный компонент, а ключевая система, которая атомарно переключает указатель на актуальную версию таблицы и без него неизбежна потеря данных при одновременной записи на S3.
- Контроль над каталогом означает контроль над доступом к данным и решением, какие движки вообще будут видеть таблицы, поэтому вендорская зависимость переместилась с формата на уровень каталога.
Кто держит каталог, тот решает, какие движки вообще увидят ваши данные, а какие останутся снаружи.
Оригиналы:Apache Iceberg: Индиана Джонс и Каталог судьбы в Lakehouse
Номерные радиостанции: криптографическая битва СССР и Запада в годы ВМВ
Кибербезопасность · Habr · 9/10
Статья рассказывает об одной из первых шпионско-криптографических операций Холодной войны — противостоянии советской и западной разведок в сфере защиты секретной информации в годы Второй мировой войны. Центральная фигура — советский криптограф Владимир Котельников, который в 1939 году создал шифровальную аппаратуру «Москва» на основе шифров Вернама, а в 1942 году разработал революционную систему «Соболь-П» для автоматического шифрования телефонной радиосвязи в реальном времени. Котельников независимо (за четыре года до американцев) доказал математически абсолютную невзламываемость шифра Вернама при строгом соблюдении процедур. Система «Соболь-П» обеспечивала неуязвимую связь советского командования со Ставкой во время Великой Отечественной войны, включая Курскую битву и переговоры о капитуляции Германии; немецкие дешифровщики так и не смогли понять её принцип. Параллельно в Британии произошли ключевые открытия в ядерной физике (работы Пайерлса и Фриша о критической массе урана-235), которые запустили проект «Tube Alloys». Советская разведка получала сведения через членов «Кембриджской пятёрки» (включая Джона Кернкросса в Блетчли-Парке), используя аппаратуру «Москва» для защиты этих критически важных данных. К 1944 году сбор информации об американском Манхэттенском проекте стал главной задачей советской разведки в США, получив кодовое имя «Энормоз». Среди советских агентов были британский физик Клаус Фукс и члены семьи Зарубиных, работавшие в США и Британии; многие учёные сотрудничали добровольно, вдохновляясь идеалами коммунизма и стремлением помочь СССР в борьбе с нацизмом.
Выводы автора:
- Владимир Котельников создал серию советских криптографических систем ("Москва", "Соболь-П"), обеспечивших абсолютно защищённую связь и опередивших западные разработки на годы.
- Советская разведка успешно вербовала западных учёных, в том числе членов "Кембриджской пятёрки", получая критически важные данные о британском ядерном проекте и американском Манхэттенском проекте.
- Противостояние в сфере криптографии и шпионажа между СССР и Западом во время Второй мировой войны стало первым крупным конфликтом эпохи Холодной войны, определившим развитие ядерного паритета и международных отношений.
Немецкие дешифровщики до конца войны так и не смогли понять принцип работы «Соболя»
Revolut планирует двойной листинг на Nasdaq и LSE; Meta Muse как App Store для агентов
Финтех и финансы · Linas from Linas's Newsletter · 7/10
Материал разбирает два крупных события в финтехе и ИИ. Во-первых, Revolut подтвердила планы двойного IPO на Nasdaq и Лондонской бирже при оценке компании $115 млрд в приватном статусе с целевыми $150-200 млрд при листинге. По словам CEO Ника Стороненского, именно Nasdaq, а не LSE, будет определять итоговую оценку компании — это показывает реальную иерархию рынков. Во-вторых, Meta запустила Muse Connectors, позиционируя себя как App Store для эпохи агентного коммерса, позволяя агентам взаимодействовать с различными сервисами. Приобретение Stilla дало Meta агентов с обеих сторон транзакций. Ключевой вывод: зазор между амбициями Meta и её реальной платформой для разработчиков остаётся критической проблемой в экосистеме агентов.
Выводы автора:
- Revolut выбирает Nasdaq как основной рынок для определения оценки, несмотря на двойной листинг, отражая доминирование США в финтехе
- Meta позиционирует себя в качестве центральной платформы для агентного коммерса через Muse Connectors
- Разрыв между стратегическими амбициями Meta и её фактическими возможностями платформы для разработчиков остаётся критическим фактором успеха
Nasdaq, а не Лондон, будет определять оценку Revolut
Оригиналы:Подписаться на Linas's Newsletter · Глубокий анализ: почему мы недостаточно оптимистичны в отношении Revolut
Парный трейдинг: как зарабатывать на рыночных аномалиях
Финтех и финансы · СберБанк · 7/10
Материал объясняет суть парного трейдинга — рыночно-нейтральной стратегии, которая позволяет получать прибыль независимо от общего направления рынка путём одновременной покупки недооценённого и продажи переоценённого актива. Ключевая идея — отыскание двух высоко коррелирующих активов (с коэффициентом корреляции, близким к 1), которые временно разошлись в цене, и ставка на их возврат к исторической норме. В основе подхода лежит поиск фундаментальных пар (сопоставимых по размеру и бизнес-модели компаний), где отклонение котировок можно объяснить статистической аномалией или корпоративными событиями. Стратегии делятся на два вида: следование за трендом (когда сильный актив продолжит опережать слабый) и возврат к среднему (ставка на ликвидацию спреда). Выделяют несколько типов парного трейдинга: секторальный (внутри одной отрасли), межотраслевой, фавориты против аутсайдеров, работа с корзинами акций, сравнение обыкновенных и привилегированных акций, статистический подход. Типичный горизонт таких стратегий — до года. Основные риски включают асимметрию убытков (отсутствие стоп-лоссов), ошибки в расчёте корреляции или отсутствие экономической логики, неожиданные новости и низкую ликвидность. Прибыль не гарантирована, нужно учитывать комиссии и налоги.
Выводы автора:
- Парный трейдинг работает на поиске и ликвидации временных отклонений цен между коррелирующими активами, позволяя зарабатывать независимо от направления рынка.
- Успешная реализация требует тщательного отбора пар на основе статистической корреляции и фундаментального анализа, с обязательной логикой за выбором.
- Основной риск — асимметрия убытков и неожиданные новости, способные «взорвать» идею, поэтому необходимо установление стоп-лоссов и учёт всех издержек.
Временное расхождение можно использовать для заработка
Как инвестору-новичку читать рыночные новости и интерпретировать их
Финтех и финансы · СберБанк · 7/10
Материал объясняет, на какие новости должен ориентироваться начинающий инвестор, чтобы принимать взвешенные решения и не поддаваться информационному шуму. Стоит отслеживать три категории: макростатистику (ВВП, ключевая ставка, инфляция, безработица) и действия регуляторов, геополитические события (военные конфликты, санкции) и корпоративные новости (финансовая отчётность, дивиденды, слияния). Важно избегать краткосрочных прогнозов цен и постоянного мониторинга индексов, которые повышают тревожность. Рынок часто растёт на плохих новостях и падает на хороших, потому что цены уже закладывают ожидания, события могут быть заложены в цену заранее, и инвесторы фиксируют прибыль по факту события. Эмоциональные заголовки в СМИ редко отражают реальность и часто используются для привлечения внимания, поэтому нужно отделять факты от мнений и фокусироваться на объективной информации.
Выводы автора:
- Следите за макроэкономическими показателями (ВВП, ставка ЦБ, инфляция, безработица), геополитикой и корпоративными событиями, но игнорируйте краткосрочные прогнозы и постоянные обновления индексов
- Рынок реагирует не на сам факт, а на то, совпадает ли он с ожиданиями инвесторов, поэтому хорошие новости могут привести к падению, если результаты ниже ожиданий
- Отделяйте объективные факты от эмоциональных заголовков и мнений экспертов, так как эмоциональная подача часто не отражает реальную ситуацию и может провоцировать панические решения
Важен не столько факт, сколько ожидания рынка — если консенсус по прибыли был 100 млн, а компания заработала 60 млн, акция упадёт, но если ждали убыток, а вышли в ноль — это позитив.
Премиальный банкинг: от путешествий к персонализированным комплексным решениям
Финтех и финансы · Б.О: Банки · 7/10
Интервью с вице-президентом ВТБ Дмитрием Кобяковым о трансформации премиум-банкинга в России. ВТБ переходит от стандартного набора услуг к системе персонализированных преференций, позволяя клиентам выбирать нужные им сервисы. Программа «Привилегия» обслуживает 1,2 млн человек, а портфель состоятельных клиентов вырос в 2,5 раза до 10 трлн рублей за пять лет. Банк активно развивает lifestyle-сервисы через платформу ВТБ Family с более чем 10 тыс. партнёрских эксклюзивов и консьерж-сервис AMA. Ключевой тренд — отход от зацикленности на путешествиях (наследие international payment systems) к семейным впечатлениям и целостным решениям. ВТБ внедряет технологии, включая ИИ-сервис «Умный портфель» для анализа риск-профиля клиентов. Персональные менеджеры получают полномочия принимать решения о гибких условиях по продуктам, включая ставки по вкладам. Роль менеджера трансформируется в финансового советника и партнёра. Клиенты становятся более требовательными к качеству обслуживания, инвестиционные портфели растут (на 50% за два года), развивается семейный банкинг с совместными счетами и детскими картами.
Выводы автора:
- Премиум-банкинг переходит к максимальной персонализации и комплексным решениям, где финансовые продукты дополняются lifestyle-сервисами и семейными опциями, но финансовая составляющая остаётся основой удержания клиентов
- Внедрение технологий (ИИ, CRM, платформы Wealth Management) не вытеснит персональных менеджеров, а трансформирует их роль в направлении финансового консультирования и партнёрства в сложных вопросах
- Российский премиальный сегмент развивается в сторону импортозамещения и развития отношений с дружественными странами, что открывает возможности для новых инвестиционных продуктов и семейных финансовых офисов
Если у банка прекрасные lifestyle-сервисы или хорошие скидки у партнёров, но нет возможности конкурировать банковскими и финансовыми продуктами, клиентов не удержать.
Оригиналы:Премиальный банк — это технологии и комплексные решения
Haier: как китайский завод стал глобальным корпоративным гигантом
Экономика · Habr · 7/10
Материал рассказывает историю трансформации Haier Group из убыточного цинндаоского завода в крупную международную корпорацию с выручкой более 30 млрд долларов. В 1980-х новый директор Чжан Жуйминь переориентировал компанию на качество продукции, а сотрудничество с немецкой Liebherr обеспечило доступ к современным технологиям. За 14 лет (1986–2000) продажи выросли в 11500 раз до 40,5 млрд юаней. Сегодня Haier владеет десятками тысяч патентов (более 50 тысяч в дочерней компании Haier Smart Home), возглавляет разработку международных стандартов интернета вещей и «умного дома», имеет 10+ центров НИОКР на пяти континентах. Инновационную стратегию компании строит на концепции «нулевая дистанция» — разработки должны соответствовать реальным запросам потребителей. Первое место среди китайских производителей бытовой электроники по числу охранных документов, активно защищает интеллектуальную собственность в России с 1990-х годов.
Выводы автора:
- Haier выросла из убыточного завода в глобального лидера благодаря смене руководства, фокусу на качество и международному сотрудничеству с технологическими партнёрами.
- Компания строит инновационную стратегию на платформе открытых инноваций HOPE, позволяющей интегрировать запросы потребителей с 10+ исследовательскими центрами и внешними партнёрами.
- Haier владеет более 50 тысячами патентов и первой среди китайских производителей электроники по числу охранных документов, что отражает её позицию технологического лидера в сегменте умного дома.
За счет управления и собственных приобретений корпорация расширила бизнес, начав заниматься микроволновыми печами, стиральными машинами, кондиционерами, что привело к росту продаж в 11500 раз за 14 лет.
Flock Safety предлагает щедрые компенсации за добровольные увольнения
Продукт и карьера · Habr · 7/10
Компания Flock Safety, разработчик систем автоматического распознавания номеров автомобилей (ALPR), ввела программу выплат сотрудникам за добровольное увольнение, чтобы избежать принудительных сокращений. Из 1,5 тысячи работников компания ожидает, что значительная часть воспользуется этой возможностью. Предложение описывается как "самое щедрое" в истории компании. Решение продиктовано стремительным падением количества клиентов и деморализацией персонала из-за многочисленных скандалов вокруг технологии. СМИ сообщали о 46 случаях неправомерного использования систем Flock, включая преследование личных контактов полицейскими. Штаты Флорида и Техас прекратили использование технологии, около 150 муниципалитетов расторгли или отказались продлевать контракты с компанией. Генеральный директор Гарретт Лэнгли признал, что репутационный урон особенно сильно повлиял на внутренний моральный дух. Ранее выяснилось, что полицейские вносили бессмысленные записи при использовании системы, а хакеры получили доступ к хранящимся на камерах данным.
Выводы автора:
- Программа добровольных выплат при увольнении становится альтернативой принудительным сокращениям для компании, теряющей клиентов из-за скандалов вокруг нарушения приватности.
- Репутационные риски и общественное давление оказали серьёзное влияние на моральный дух и кадровую стабильность компании.
Наибольший ущерб негативная реакция общественности пришлась на внутренний моральный дух компании.
Оригиналы:Теряющая клиентов Flock предлагает сотрудникам выплаты за увольнение по собственному желанию
Коротко
Финтех и финансы
- МТС утвердила новую дивидендную политику на 2027–2028 гг. – МТС утвердила дивидендную политику на период 2027–2028 годов, предусматривающую возврат акционерам до 20% от OIBDA.
- Распадская: рост цен на уголь не гарантирует восстановление стоимости – Аналитический материал СберБанка о перспективах компании «Распадская» на фоне изменившейся конъюнктуры.
- СберБанк повысил прогнозы по нефтяным компаниям на 2026–2027 годы – СберБанк пересмотрел в сторону повышения оценки финансовых показателей нефтяных компаний на 2026–2027 годы на основе сильной отчётности первого полугодия 2026 года.
Экономика
- Российский рынок корректируется на фоне ужесточения ЦБ и санкций – Индекс МосБиржи снизился на неделе из-за комбинации негативных факторов.
- Минэнерго сохранило спорные механизмы в законопроекте о Росэнергопроекте – Минэнерго опубликовало финальную версию законопроекта «О содействии инфраструктурному развитию», который создаёт институт развития «Росэнергопроект».
Прочее
- Как восстановить глубоко разряженный аккумулятор ноутбука ASUS – Статья рассказывает о восстановлении аккумулятора ноутбука ASUS X200CA, который два года пролежал в разряженном состоянии и перестал заряжаться.
- Игровая индустрия на пике: рост релизов и угроза краха – Статья анализирует взрывной рост качественных игровых релизов за последние 6 лет и предупреждает о возможности второго коллапса индустрии.