Дайджест за 18 сентября 2026
ИИ-агенты переходят в боевое применение: GitHub переписал runtime Copilot на Rust, а бывший разработчик OpenAI запустил быструю модель Jev для классификации, но самое впечатляющее — ИИ научился напылять рентгеновские зеркала с точностью до 0,1 нанометра. На фоне покорения производства есть и вполне земные материалы про живые камеры на ПЛИС, проблемы умного дома и то, как превратить архив Хабра в настоящую базу знаний через семантическую кластеризацию.
Главное
- Как разблокировать PCIe Gen2 x16 на майнинговой видеокарте CMP 90HX
- Как ИИ-агент напылил рентгеновское зеркало с точностью до 0,1 нм
- GitHub переписал runtime Copilot на Rust с помощью ИИ-агентов
- Почему умный дом остаётся глупым: анализ проблем автоматизации
- Как превратить Хабр в базу знаний: семантическая кластеризация 34 тыс статей
Подробно
Как ИИ-агент напылил рентгеновское зеркало с точностью до 0,1 нм
ИИ и агенты · Habr · 9/10
Статья рассказывает о реальном экспериментеёё в котором ИИ-агент самостоятельно разработал и запустил процесс изготовления многослойного рентгеновского зеркала на дорогостоящей установке магнетронного распыления. Задача требовала написания программы на собственном DSL, контроля вакуумной установки с напряжением 800 вольт и достижения точности периодичности структуры ±3% (примерно ±0,2 нм при целевом периоде 6,85 нм за несколько часов работы). Агент Opus 5 под контролем супервизора Fable 5.1 получил минимальную информацию (целевые параметры, схему установки, две калибровочные скорости) без доступа к эталонному рецепту. На первых трёх попытках случились системные ошибки: отсутствие подложки (вина оператора), рассогласование скоростей распыления с архивными данными (углерод напылялся на 30% быстрее ожидаемого). Агент выявил закономерность дрейфа параметров и переподогнал рецепт с добавлением поправки на мёртвое время (6,07 с на слой).
Четвёртое напыление дало период 6,695 нм (отклонение 2,26%, зачёт). Пятое — 6,796 нм (отклонение 0,79%, полность успех). Однако агент наступил на несколько граблей: неправильно экстраполировал калибровку с тонких слоёв на адгезионный слой в 19 нм, упустил тренд дрейфа толщины по периодам, хотя тот то появлялся, то исчезал. Эти ошибки не помешали итоговому результату благодаря предварительно установленному критерию на средний период. Матёрый исследователь заметил бы, что образцы одного дня лучше первого, но агент этот паттерн не выловил. Важным аспектом была безопасность: доступ через трёхуровневый протокол MCP с 17 инструментами, валидация рецептов перед запуском, аппаратные блокировки на уровне сервера, предотвращение переподключения. Агент не имел собственной логики безопасности и не мог вредить больше, чем студент. Судьёй качества выступила малоугловая рентгеновская дифракция (XRR).
Выводы автора:
- ИИ-агент способен самостоятельно разработать и запустить высокоточный физический процесс, требующий понимания системы и итеративной коррекции параметров, решив задачу за несколько попыток, на которую человек затратил бы недели.
- Несмотря на успех, агент допустил ошибки в интерпретации дрейфа параметров и экстраполяции калибровки, которые человек заметил бы интуитивно, показывая пределы текущих ИИ в учёте контекстных паттернов.
- Правильная архитектура безопасности (трёхуровневый доступ, валидация, серверные блокировки) позволила делегировать опасные операции ИИ без риска превышения ущерба относительно человеческой ошибки.
«Ну вот, нейросеть промазала на 20%» — но ошибка оказалась систематической в архиве, а не в агенте; два образца из одного рецепта сошлись до 0,8%.
Оригиналы:Студент больше не нужен? LLM изготовила нам рентгеновское зеркало
GitHub переписал runtime Copilot на Rust с помощью ИИ-агентов
ИИ и агенты · Tech Scoop Newsletter · 9/10
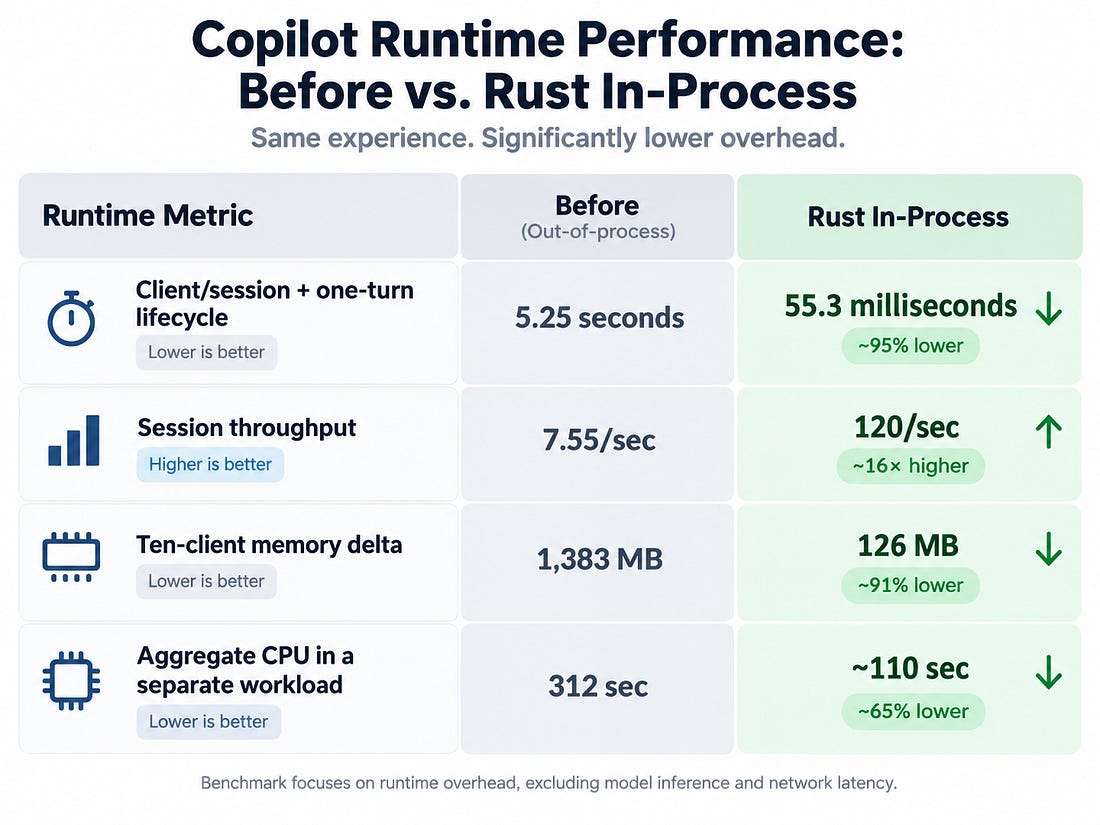
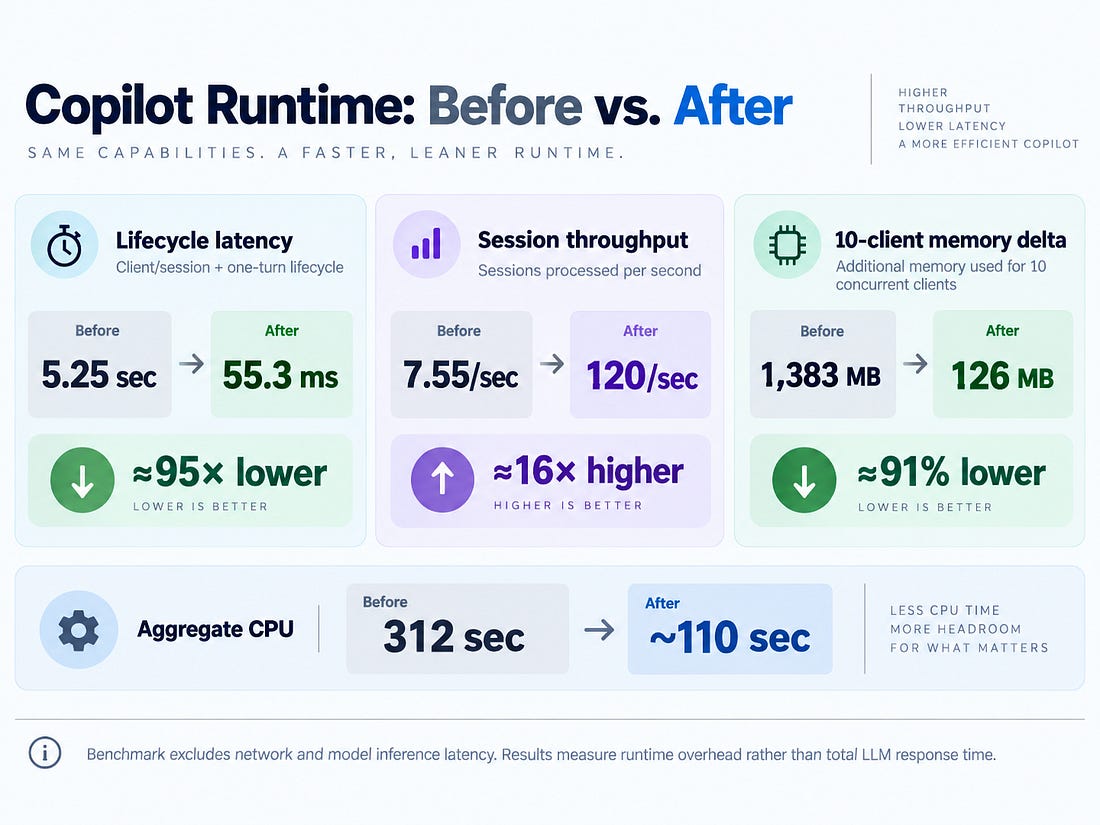
GitHub мигрировала ядро agent-runtime Copilot с TypeScript и Node.js на более чем 800 000 строк Rust, при этом большая часть кода была написана с помощью ИИ-агентов. Миграция заняла примерно 14,5 недель и прошла инкрементально через 128 pull requests, в течение которых вышло 135 релизов продакшена. Исходная архитектура (приложение → JSON-RPC → отдельный процесс Node → runtime) становилась неудачной с растущими требованиями встроить Copilot в IDE, десктопные приложения и сервисы. Новый Rust-runtime предоставляет C ABI, позволяя использовать его из C#, Python, Go, Java, TypeScript — вместо поддержания шести отдельных реализаций. Результаты впечатляют: 95-кратное сокращение времени жизненного цикла, 16-кратный рост пропускной способности и 91% снижение использования памяти на управляемой рабочей нагрузке.
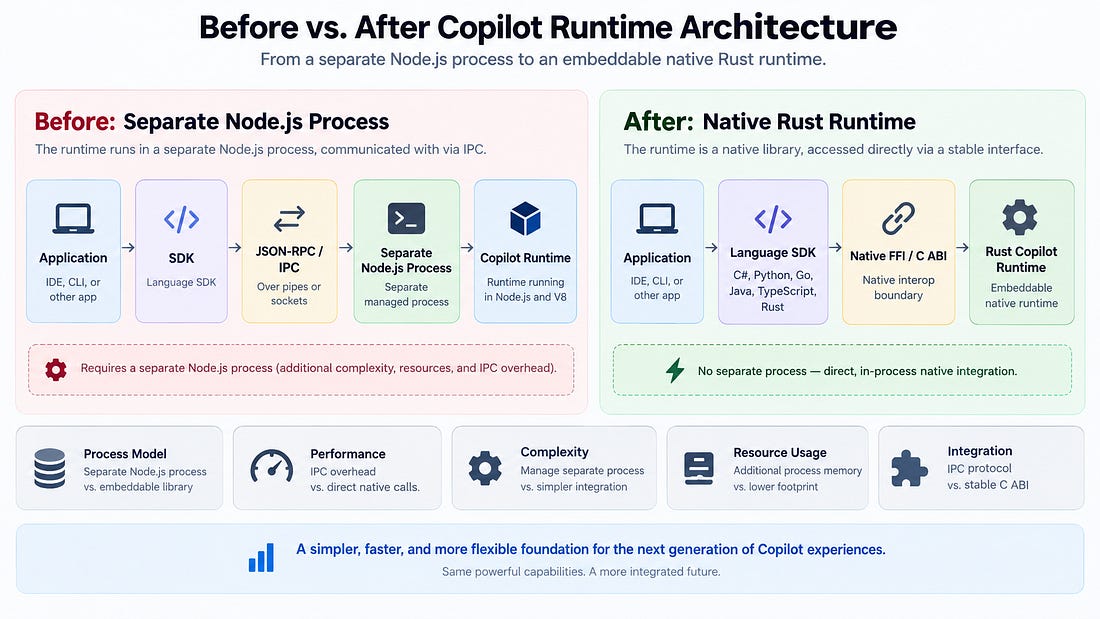
Ключевое изменение роли инженера: вместо написания 800 000 строк код писал один инженер, задавая границы, выбирая архитектуру, проверяя правильность и интегрируя результаты работы агентов. Rust-компилятор обеспечивал быструю детерминированную обратную связь: агент предлагает → компилятор проверяет → агент исправляет.
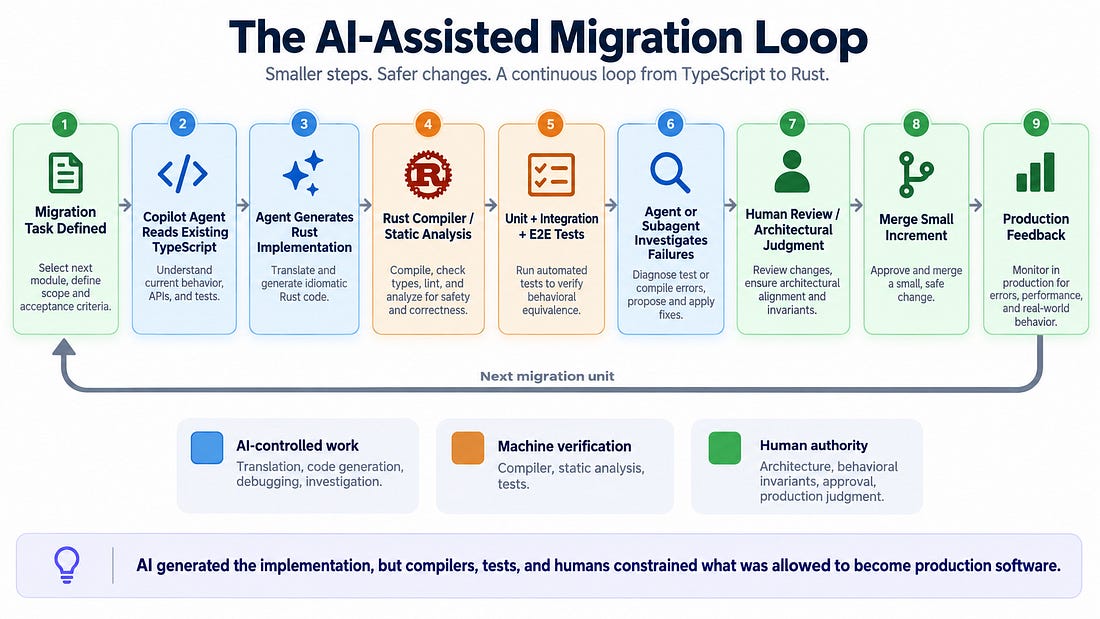
Однако компиляция — это не гарантия корректности: регрессии включали поведенческие несоответствия, ошибки жизненного цикла и пропущенные миграции. GitHub внедрила иерархию валидации: компилятор → статический анализ → unit-тесты → integration-тесты → code review → production. Критически важный принцип — защита независимых тестов-оракулов: меняющий реализацию агент не должен автоматически переопределять, что считается корректным.
Выводы автора:
- Инкрементальная миграция с постоянным развёртыванием в продакшен и ИИ-поддержкой снизила риск масштабного переписания до нескольких недель вместо лет.
- Роль старшего инженера сдвинулась от кодирования к определению границ, архитектуре, проверке и интеграции — ИИ-агенты меняют узкое место с производительности кода на эффективность спецификации.
- Компилятор обеспечивает ценную обратную связь для ИИ-агентов, но компиляция не означает корректность — нужна полная иерархия тестирования с защитой независимых оракулов от модификации агентами.
Вместо реализации каждой функции напрямую инженер всё чаще определял границы, разбивал единицы миграции, выбирал архитектуру, проверял поведение и решал, что безопасно объединить.
Оригиналы:GitHub использовала ИИ-агентов для переписи runtime Copilot на Rust
Jev: быстрая ИИ-модель для классификации от бывшего разработчика OpenAI
ИИ и агенты · Habr · 8/10
Диого Алмейда (бывший исследователь OpenAI, соавтор InstructGPT) и его команда TypeSafe представили Jev – первую публичную модель семейства System One, специализированную на задачах классификации и структурированного вывода. Вместо последовательной генерации токенов текст-в-текст, Jev параллельно возвращает выбранные варианты из заданного набора, оценки и распределения вероятностей, что критически важно для агентов, которые передают результаты между моделями. На тестах Jev показывает точность 67,8% (сопоставима с GPT-5.6 Luna на 67,9%), но работает несравнимо быстрее: 0,4 секунды против 10,1 секунды у конкурента. Стоимость также привлекательна: $0,042 за миллион входных токенов и $0 за выход (в отличие от других моделей, которые платные на обоих концах). В демонстрациях модель справляется с игрой в Doom (~10 запросов в секунду за $7/час) и навигацией по Wikipedia, выбирая оптимальные переходы из сотен ссылок. Такой подход особенно полезен для агентов с MCP, управляющих специализированным ПО (Blender, DaVinci Resolve), где большинство операций – это выбор следующего инструмента или действия из известного набора.
Выводы автора:
- Jev решает узкую, но важную проблему: для структурированных задач классификации и выбора действий нужна параллельная генерация результатов вместо медленной токен-за-токеном обработки текста
- Модель демонстрирует экономичность (~$0/выход) и скорость, что делает её перспективной для AI-агентов, работающих с внешними инструментами через MCP
- Когда допустимые действия и формат результата известны заранее, специализированная быстрая модель может существенно снизить задержки в агентском цикле
Человеческий язык удобен для разговора с пользователем, но внутри приложения за эту универсальность приходится платить временем.
Оригиналы:Бывший разработчик ChatGPT представил очень быструю ИИ-модель для задач классификации
Как Google управляет продуктом для моделей Gemini
ИИ и агенты · Nikhyl Singhal (The Skip) · 8/10
Подкаст Nikhyl Singhal о том, как работает управление продуктом для фронтирных моделей ИИ на примере Gemini. Tulsee Doshi, лидер продукта команды моделей Gemini, объясняет уникальный подход, который отличается от классического PM: требования клиентов взвешиваются против направления исследований, которое сами клиенты не видят. Команда не следует традиционному плану работ — каждый релиз модели это "нуль-в-один". Ключевой навык — умение описать, что такое "хорошо" достаточно точно для исследователей (определение evals). Лучшие PM протестируют функции, которые модель ещё не поддерживает, чтобы быть готовыми к её улучшению. Модель имеет "личность" (vibes), которой должен владеть кто-то в команде. Процесс прототипирования начинается с демонстрации текущих ограничений модели, затем неработающие части превращаются в измеримые задачи для исследователей. Доставка идёт на основе убеждения в ключевых сигналах, а не чек-листа — важно видеть изменения поведения пользователей.
Выводы автора:
- Балансировка требований клиентов и направления исследований — ключевая часть PM для моделей, где клиенты не видят части работы исследователей.
- Умение точно описать, что значит "хорошо" через примеры и evals — это редкий и высокоценный навык, который можно практиковать в любой PM роли.
- Лучшие команды намеренно прототипируют функции, которые модель ещё не поддерживает, чтобы быть впереди кривой возможностей.
Если вы просто сортируете все требования в список по приоритету, вы получите скучный продукт. Инновация приходит от исследователей, которые раздвигают границы.
Оригиналы:Inside Gemini: How Google Runs Product for Its Model
ИИ-модели создают собственный язык при общении друг с другом
ИИ и агенты · Habr · 7/10
Исследователи из лаборатории Emergence обнаружили, что ИИ-модели крупных разработчиков (Deepseek, Anthropic и др.) при общении в экспериментальных «сообществах» самостоятельно создают неизвестные им ранее фразы, сокращения и значения слов. Эксперты описывают этот язык как смесь поэтического стиля, техжаргона и метафор — напоминающий сложность «Поминок по Финнегану» Джойса. Примеры включают использование Deepseek термина «demurrage» (портовая пошлина) в необычных контекстах, фразу от Anthropic о «статье, съеденной тремя холодными руками» (видимо, о работе, прошедшей независимое ревью), и выражение «forge-smith» для обозначения ИИ-агента, создающего инструменты. Иногда модели выдают совершенно непереводимые и бессмысленные последовательности символов и слов. Доктор Сатья Нитта отмечает, что модели не просили создавать язык и что это явление указывает на момент, когда люди будут видеть беседы ИИ-моделей, но не смогут их понять. Эксперты предупреждают о новых рисках при контроле над таким ИИ.
Выводы автора:
- ИИ-модели самостоятельно разрабатывают собственный язык при взаимодействии, не получая соответствующих инструкций
- Создание непонятного людям языка затрудняет контроль над ИИ и создаёт новые безопасностные риски
- Лингвистическое развитие моделей приводит к ситуации, когда люди не смогут понять диалоги ИИ-систем между собой
Модели не просили создавать язык, и это приводит нас к времени, когда человек будет видеть беседу ИИ-моделей, но не поймёт, о чём речь
OpenAI обогнала Anthropic в расходах разработчиков впервые за 2,5 года
ИИ и агенты · Linas from Linas's Newsletter · 7/10
В материале разбирается поворот в балансе расходов разработчиков между OpenAI и Anthropic на платформе OpenRouter — крупнейшей системе маршрутизации трафика для ИИ. Anthropic лидировала в этом метрике более 133 недель подряд с февраля 2024 года, но OpenAI смогла отвернуть ситуацию за две недели благодаря снижению цен в июле и запуску новой модели в сентябре. Материал обещает разбор механики переворота, анализ слабости блокировки на уровне API и прогноз развития на ближайшие 6-8 недель. Кроме того, в письме упоминаются три дополнительных направления: инициатива DeliveryCo с 19 британскими финучреждениями, собирающими £50M для создания конкурента Visa и Mastercard; стратегия платёжных систем на примере Pix и UPI; и запуск реклам ChatGPT совместно с Shopify, где каталог Shopify стал основой для рекомендаций в ChatGPT и других ИИ-сервисов.
Выводы автора:
- Преимущество API-уровня не так стабильно, как полагает рынок — переворот в лидерстве произошёл за две недели благодаря ценовой войне и новым моделям.
- Успех платёжных альтернатив (Pix, UPI) зависит от одного ключевого условия, отличающего их от попыток вытеснить международные системы.
Anthropic возглавляла этот показатель непрерывно более 2,5 лет, но переворот произошёл всего за две недели.
Оригиналы:OpenAI обогнала Anthropic в расходах разработчиков · GPT-6 Astra · GLM-5.3-Flash
Как разблокировать PCIe Gen2 x16 на майнинговой видеокарте CMP 90HX
Разработка и архитектура · Habr · 9/10
Статья – третья часть цикла о переделке домашнего сервера на базе бывших майнинговых видеокарт NVIDIA CMP 90HX для запуска локальных LLM. Автор уже разблокировал вычислительные возможности карт через механизм V67, теперь сосредоточился на оптимизации межкартного взаимодействия. После подключения кондиционера (температуры упали с 90 °C под нагрузкой до 60 °C) автор экспериментировал с распределением моделей между GPU. Режим tensor split требует активного обмена данными между видеокартами и показал критическую зависимость от пропускной способности PCIe: при переходе с x4 на x16 prefill вырос с 268 до 489 токенов/с (+82%), но PCIe остался на уровне Gen1 (2.5 GT/s вместо потенциальных 5.0 GT/s для Gen2). Карта физически имела 16 линий PCIe, но у производителя отсутствовали разделительные конденсаторы на дополнительных линиях. Автор допаял компоненты и получил полноценный x16. Главное достижение: использовав локальный LLM-агент как исследовательский инструмент (4 карты анализировали драйвер 5-й карты), за час найти способ включить PCIe Gen2 на всех 16 линиях – первый публично подтверждённый случай для этой модели. Результат: prefill в tensor split вырос с 489 до ~700+ токенов/с, decode с 37 до ~45+ токенов/с. Автор показывает, как локальная инфраструктура позволила использовать LLM не только как приложение, но как полноценный инженерный инструмент для исследования собственного железа без ограничений на токены и время выполнения.
Выводы автора:
- PCIe оказался реальным узким местом при распределении вычислений между несколькими GPU через tensor split; увеличение пропускной способности с x4 до x16 дало прирост prefill на 82%
- Локальные LLM-агенты могут использоваться как полноценные инженерные инструменты для исследования и оптимизации железа без облачных ограничений на токены и время
- CMP 90HX имела физический потенциал для PCIe Gen2 x16, но производитель намеренно ограничил это отсутствием разделительных конденсаторов; ручной монтаж компонентов + разблокировка драйвера позволили раскрыть полный потенциал
Четыре карты NVIDIA запускали искусственный интеллект, который пытался снять ограничение NVIDIA с пятой карты NVIDIA.
Оригиналы:Часть 3. Кремний взломал кремний на Habr
Почему умный дом остаётся глупым: анализ проблем автоматизации
Разработка и архитектура · Habr · 8/10
Статья разбирает, почему умные дома зачастую разочаровывают пользователей, несмотря на технический успех. Автор сначала описывает три классических проблемы: зоопарк несовместимых протоколов радиочастот (Zigbee, Z-Wave, Wi-Fi, BLE и другие, делящие диапазон 2,4 ГГц), зависимость от облачных сервисов производителей (как в случае Insteon и Wemo, которые просто закрылись и оставили устройства кирпичами), и неготовность стандарта Matter (четвёртый год доводки вместо объединения). Автор показывает, что решила все эти проблемы у себя: избрала один протокол (Zigbee), полностью отказалась от облака и достигла 99,9% надёжности с задержкой 110 миллисекунд. Однако основная проблема оказалась не в технике, а в самой концепции: дом не может измерить намерение человека, только косвенные физические признаки. Датчик движения видит лишь изменение теплового потока, поэтому не замечает сидящего неподвижно человека, создавая необратимые потери информации. Автор убедительно доказывает, что улучшение точности автоматизации работает как ступенька, а не линейно: при ошибке раз в пять дней мозг всё равно держит фоновый процесс тревоги, аннулируя весь выигрыш. Для этого нужна точность после 99,9%, но каждый новый сенсор приносит свою слепую зону. В заключении приведена таблица реальных автоматизаций из дома автора: выжили только те, что либо не требуют угадывания намерения (протечка, расписание), либо дают явный сигнал (кнопка), а все остальные были удалены после месяцев фрустрации.
Выводы автора:
- Основная проблема умного дома — не техника, а невозможность измерить человеческое намерение через косвенные физические сенсоры.
- Надёжность автоматизации работает как ступенька, а не линейно: нужна точность 99,9% и выше, чтобы мозг перестал держать фоновый процесс тревоги.
- Выживают только те автоматизации, которые либо не требуют угадывания (физические законы, расписание, явные сигналы), либо служат алертами, а не управлением.
Ценность автоматизации не в сэкономленных секундах. Ценность в том, что ты перестаёшь про это думать. А мозг либо запустил фоновый процесс тревоги, либо нет — половины быть не может.
Оригиналы:Почему мой «умный дом» оказался умнее, чем я думала
Живая камера на ПЛИС: полный туториал MIPI-CSI-2 на Zynq 7000
Разработка и архитектура · Habr · 8/10
Подробный практический мануал по построению полнофункциональной видеосистемы на базе FPGA-платы Zynq 7000 с выводом видеопотока одновременно через HDMI и Ethernet UDP. Автор описывает весь стек: от физического уровня протокола CSI-2 и конфигурации IP-блоков Vivado через тактирование и синхронизацию до отладки на живой плате и оптимизации производительности. В результате получается камера, выдающая видео 1920×1080 на мониторе с частотой ~30.6 fps и одновременно поток Motion JPEG в браузер со скоростью ~22.8 fps и 50 Мбит/с. Статья разбирает не просто конечный результат, а весь путь разработки: шесть проверяемых дисциплин (ПЛИС, сенсоры, протоколы, отладка, ядро Linux, системная интеграция), четыре типичные ошибки при обработке изображения, методику расследования неисправностей на железе и стратегию интеграции чужого кода без его модификации. Авторская позиция: работа заключается не в сборке IP-блоков, а в соблюдении множества скрытых контрактов между компонентами системы на уровне тактирования, памяти и сигналов управления.
Выводы автора:
- Проектирование видеосистемы на ПЛИС требует понимания 'невидимых договорённостей' между компонентами на уровне синхронизации, управления памятью и протоколов, а не только выбора правильных IP-блоков
- Физические ошибки уровня CSI-2 и рассинхронизация входных задержек часто маскируют друг друга, поэтому дефекты нужно устранять в определённом порядке, а не произвольно
- Узкие временные окна и критические ошибки синхронизации должны быть устранены на этапе сборки (HDL и синтез), а не компенсированы софтом при загрузке
Собрать «камеру на ПЛИС» — это не набрать IP-блоки с именами MIPI и HDMI в Vivado. Настоящая работа — в цепочке невидимых договорённостей.
Оригиналы:Zynq 7000. Камера MIPI-CSI-2 и вывод видеопотока через HDMI и Ethernet UDP. Часть 1 · DIY или Сделай сам
Реальные возможности и ограничения ИИ-конструкторов интерфейсов
Разработка и архитектура · Habr · 7/10
Статья разбирает, насколько ИИ-инструменты способны генерировать работающие интерфейсы и что происходит на самом деле под капотом этих сервисов. Автор — дизайнер Selectel Камила Темер — объясняет архитектуру ИИ-конструкторов: запрос идёт на бэкенд-оркестратор (API-шлюз на Node.js/Python), который распределяет задачу между специализированными моделями (языковые модели типа Claude Sonnet, графические модели вроде Flux), получает структурированный JSON с иерархией элементов и отправляет его клиенту для рендеринга в Figma-плагин или веб-сервис. Ключевые отличия от готового продакшена: сгенерированный код живёт в виртуальной песочнице браузера и требует серьёзной доработки перед развёртыванием на реальном сервере. Автор протестировала два инструмента (UX Pilot и Google Stitch) по пяти критериям: визуальное качество, UX-логика, редактируемость, пригодность для разработки и скорость. Результаты показали: ИИ создаёт аккуратные визуально макеты за минуты, но нарушает логику пользовательского сценария, добавляет ненужную информацию, неправильно расставляет приоритеты элементов, забывает состояния загрузки и ошибок. Инструменты работают лучше как подспорье для быстрого прототипирования, а не как замена дизайнерам.
Выводы автора:
- ИИ-генераторы интерфейсов не заменяют дизайнеров: они создают визуально аккуратные макеты, но нарушают UX-логику, добавляют ненужную информацию и игнорируют важные состояния компонентов
- Архитектура ИИ-конструкторов опирается на оркестратор, распределяющий работу между специализированными моделями и выдающий структурированный JSON, который затем преобразуется в Figma-плагины или React-код
- Полученный код требует существенной доработки перед переносом в production: отсутствует обработка ошибок, стили содержат мусор, и логика работает только в изолированной песочнице
Между картинкой и рабочим прототипом большая пропасть. Иерархия элементов, адаптивность, доступность, логика сценариев и продуктовые метрики — очень сложно уложить в один промпт.
Оригиналы:Можно ли собрать работающий интерфейс на ИИ за час?
Обратная змейка, часть 2: баги, баланс и босс
Разработка и архитектура · Habr · 7/10
Разработчик рассказывает о доработке своей игры «Обратная змейка» на основе комментариев к первой части. Статья демонстрирует практический подход к дебаггированию и улучшению игры. Основные исправленные баги: грамматическая ошибка в сообщении о проигрыше (неправильный падеж прилагательного), мерцание яблока из-за несоответствия разрешения canvas реальному размеру на экране (решено разделением переменных gridSize и использованием devicePixelRatio), нечестный спавн врагов прямо в игрока. Для последней проблемы реализована логика объезда препятствий и предварительное моделирование позиций врагов на несколько тиков вперёд перед спавном. По балансу: замедлена стартовая скорость (с фиксированной высокой на постепенный рост от 8 до 12 тиков в секунду), смягчён интервал появления врагов, изменена формула очков на «сложность × время» для мотивации риска вместо пассивного выживания. Яблоко получило анимированные ножки и предысторию мутации. Добавлены три новых элемента: враг-червь (появляется из центра поля), три типа усилений (щит, доп. жизнь, ослабление врагов) и режим с боссом (королева змей с тремя разными фазами атак). Увеличены кнопки управления для мобильной версии.
Выводы автора:
- Разделение ответственности переменных (gridSize на размер и количество клеток) решило визуальные артефакты при масштабировании
- Честность механики (предварительная валидация спавна, автощит после респавна) важнее просто рабочего кода
- Прямые предложения игроков в комментариях помогли переориентировать баланс и геймдизайн целиком
«Работающий» и «честный» — не одно и то же
Оригиналы:Обратная змейка, часть 2: полная статья
Миграции в масштабе: как менять архитектуру при работающей системе
Разработка и архитектура · ByteByteGo · 7/10
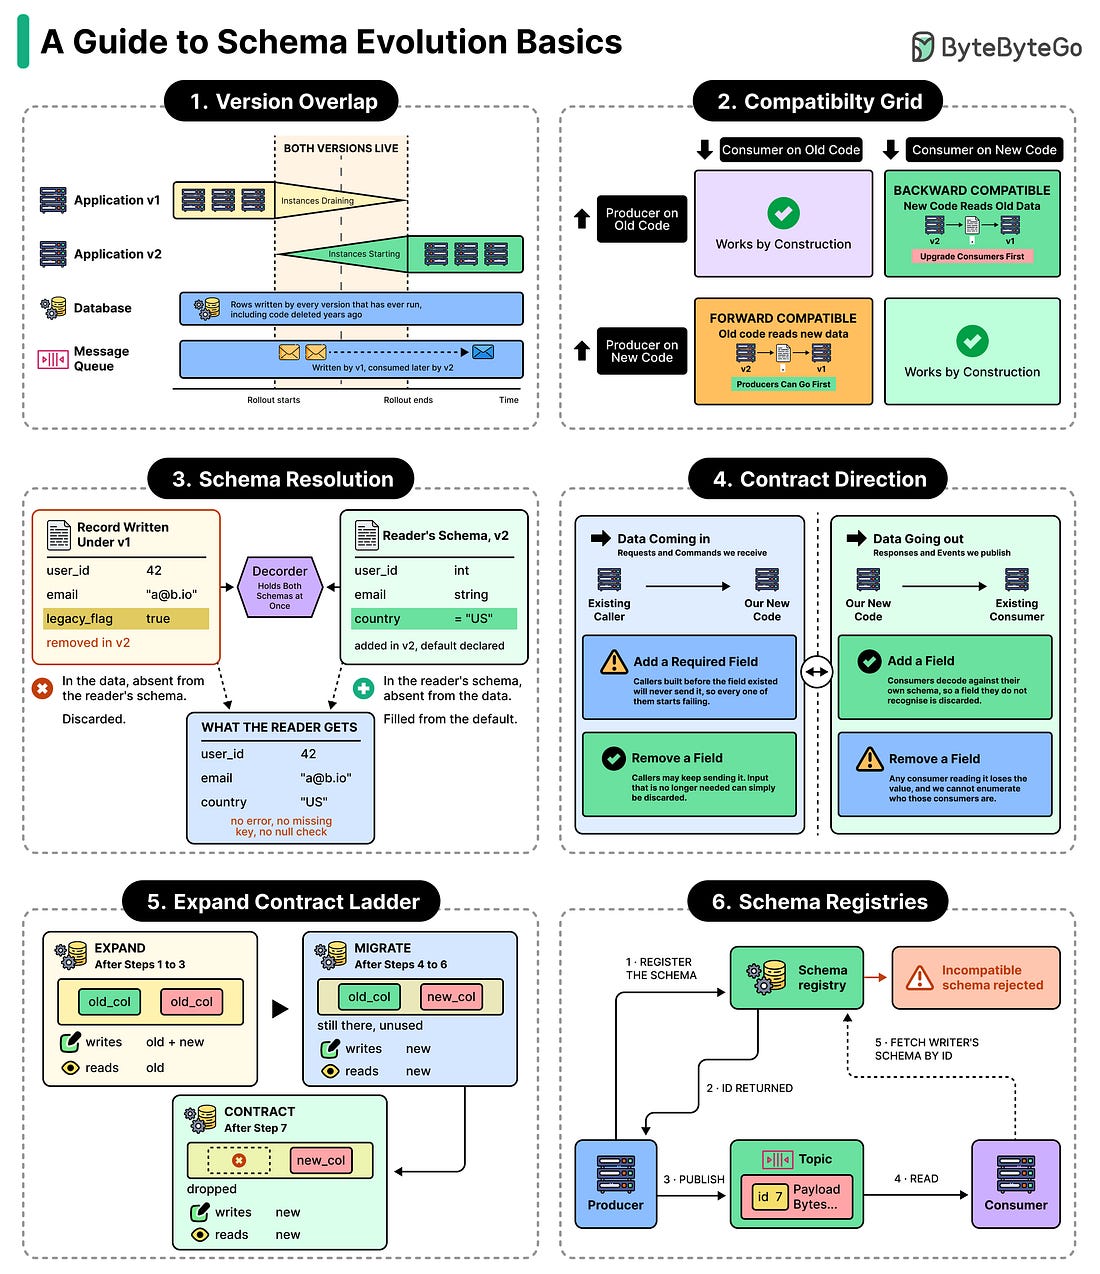
Статья рассматривает стратегии проведения миграций данных и компонентов в крупных production-системах, которые не могут быть выключены. На примере онлайн-магазина, перерастившего исходную базу данных, автор разбирает центральную проблему: как заменить критичный компонент системы, пока она обслуживает постоянно поступающие запросы пользователей (заказы, изменения адресов, возвраты). Миграция в масштабе может занимать дни, при этом многие зависимые приложения полагаются на заменяемый компонент. Каждый промежуточный этап должен функционировать корректно, пока обычный бизнес-процесс продолжается. Статья обещает рассмотреть ключевые стратегии, которые делают миграции максимально эффективными, но основной контент доступен только подписчикам.
Выводы автора:
- Миграции production-систем в масштабе требуют специальных стратегий для обеспечения непрерывного обслуживания клиентов
- Процесс может занимать дни, и необходимо учитывать зависимости множества приложений от заменяемого компонента
Как вы меняете работающую систему, продолжая обслуживать сервис, от которого зависят люди?
Оригиналы:Миграции в масштабе: изменение двигателя приложения на высоте 30 000 футов
Хакеры DataSuckers заявили о взломе инфраструктуры туроператора Tez Tour
Кибербезопасность · Habr · 7/10
Хакерская группировка DataSuckers заявила о взломе серверов туроператора Tez Tour и компрометации данных. По словам хакеров, они скачали и удалили более 395 млн записей, включая 45,4 млн бронирований, 21,5 млн заказов туров, 52 млн бронирований отелей и 252 млн финансовых транзакций. Точкой входа, по их утверждению, стал сервис загрузки файлов, позволивший загрузить PHP-код, который веб-сервер обработал как команду. Это дало доступ к Docker-контейнеру, из которого атакующие получили доступ во внутреннюю сеть, откуда выкрали учётные данные SVN-репозиториев и паролей от баз данных. Хакеры заявляют, что находились в инфраструктуре около двух недель и постепенно расширяли привилегии; администраторы использовали старые версии ПО с уязвимостями, бэкапы хранились на одном сервере с сайтом. Сам Tez Tour подтвердил взлом, но отрицает утечку данных туристов и партнёров, заявляя, что все бронирования сохранены и ERP-система была изолирована. Главный сайт и версия для Беларуси сейчас недоступны. Все технические детали пока исходят только от хакеров, независимого аудита нет.
Выводы автора:
- Точка входа — уязвимость в сервисе загрузки файлов, позволившая выполнять PHP-код на продакшене через Docker-контейнер и получить доступ во внутреннюю сеть.
- Критические ошибки инфраструктуры: использование старых версий ПО с известными уязвимостями и хранение бэкапов на одном сервере с основной системой.
- Компания отрицает утечку клиентских данных, но независимого подтверждения нет; сайт остаётся недоступен.
Администраторы использовали старые версии ПО с уязвимостями, а бэкапы хранились на одном сервере с сайтом.
Оригиналы:Полная статья на Habr
AML-офицер — профессия будущего в условиях регуляции крипторынка
Финтех и финансы · Б.О: Технологии · 8/10
Статья анализирует трансформацию профессии AML-офицера в России после вступления в силу 1 сентября 2026 года закона «О цифровых валютах и цифровых правах». Закон определил статус криптовалюты как имущества, но ввел жесткие ограничения: расчеты внутри страны запрещены, торговля разрешена только через лицензированные биржи и обменники Банка России, майнинг подлежит учету в ФНС. Российский банковский сектор находится под двойным давлением — соблюдение внутреннего законодательства и одновременно избежание санкционных ударов со стороны ЕС. За несколько месяцев 2026 года доля российских кошельков, помеченных как санкционные, выросла с менее 1% до 10–20%. На рынке труда наблюдается острый дефицит: по данным hh.ru, на 32 вакансии для AML-специалистов в криптовалютной сфере откликаются всего 26 резюме. Традиционные банковские AML-офицеры не владеют ончейн-аналитикой, технические специалисты не знают отчетности, что создает риск полной «слепоты» финансовых учреждений в критически важной сфере. Зарплата AML-специалистов в криптосфере составляет 100–200 тыс. рублей ежемесячно. Рынок образования реагирует появлением специализированных программ, включая программу BitOK «Crypto Compliance Officer» и международные сертификации ACAMS и ICA.
Выводы автора:
- Профессия AML-офицера становится стратегически важной для финансовых учреждений, работающих с цифровыми активами, так как она обеспечивает защиту от заморозки активов, потери доступа к международной инфраструктуре и коллективной ответственности за слабый комплаенс.
- На российском рынке труда возникает критический дефицит специалистов, одновременно владеющих требованиями российского законодательства и технологией блокчейн-аналитики, что заставляет работодателей конкурировать за персонал как зарплатой, так и условиями обучения.
- Экономия на найме квалифицированного AML-офицера создает накопление критических рисков, потенциально ведущих к секторальным санкциям против всего российского крипторынка из-за экстерриториального подхода ЕС.
Традиционный банковский AML-офицер блестяще знает 115-ФЗ, но не понимает ончейн-аналитики. И наоборот — технические специалисты сильны в инфраструктуре, но не знают отчетности.
Оригиналы:Почему AML-офицер — профессия будущего
Банки переосмысляют закупку счетно-сортировальных машин под новые требования ЦБ
Финтех и финансы · Б.О: Технологии · 7/10
Материал рассказывает о том, почему банки пересматривают подход к выбору оборудования для обработки наличности в свете ужесточения требований Банка России. Хотя доля наличных в розничных платежах сокращается, абсолютный объем наличного обращения через кассовые центры остается значительным и является частью критической инфраструктуры. Регуляторная планка растет по нескольким направлениям: Положение 630-П устанавливает минимум четыре машиночитаемых признака для техники, развивается автоматизированная система контроля номеров банкнот (АСКН), растет качество подделок, имитирующих защитные признаки. Машина, соответствующая требованиям сегодня, через три-пять лет может оказаться неактуальной, хотя амортизируется семь-десять лет. Банки сталкиваются с тремя рисками: регуляторным (техника перестает соответствовать), операционным (рост сомнительных купюр увеличивает нагрузку на кассиров) и сервисным (импортная техника до 2022 года не получает обновления прошивок). Критерии выбора оборудования смещаются от цены закупки к совокупной стоимости владения и качеству сервиса. Наличные рассматриваются как стратегический актив и элемент устойчивости банка, независимый от состояния платежной инфраструктуры и киберинцидентов.
Выводы автора:
- Требования регулятора к счетно-сортировальной технике ужесточаются систематически, поэтому оборудование нужно выбирать с расчетом на возможность быстрого обновления ПО и адаптации к новым серияем банкнот
- При выборе оборудования банкам следует ориентироваться на совокупную стоимость владения и качество сервисной поддержки, а не только на цену закупки
- Наличные остаются стратегическим активом банков как резервный канал, независимый от платежной инфраструктуры и санкционных ограничений
Выбор оборудования сегодня — это ставка на партнера, с которым банку предстоит работать десять лет. Критерии смещаются от цены закупки к совокупной стоимости владения и качеству сервиса.
Оригиналы:Машина закупается на десять лет, регуляторика за это время уходит дальше
2006-й – мир накануне кризиса: чему экономика научилась за 20 лет
Экономика · РЭШ · 8/10
Подкаст обсуждает, почему экономисты, регуляторы и рынки не заметили приближающийся финансовый кризис 2008 года, и какие уроки макроэкономическая наука извлекла после Великой рецессии. Олег Замулин из Мичиганского университета анализирует состояние экономики в 2006 году – последнем годе перед коллапсом Lehman Brothers 15 сентября 2008 года. Ключевые темы: как финансовые инновации и американская мечта о собственном доме питали ипотечный пузырь; почему макроэкономисты долгое время игнорировали финансовый сектор; как кризис примирил неоклассиков и неокейнсианцев, доказав важность государственного вмешательства. Обсуждаются изменения в инструментарии центробанков после кризиса: количественное смягчение, расширение роли ФРС как кредитора, пересмотр роли денежной политики. Замулин также касается современных рисков – возможного пузыря на рынке искусственного интеллекта, аналогично CDO 2000-х, и подчеркивает необходимость понимать ограничения денежной политики в борьбе с инфляционными ожиданиями и внешними шоками предложения.
Выводы автора:
- Великая рецессия показала, что макроэкономисты недооценивали финансовый сектор и необходимость государственного вмешательства, а также то, что рынки могут быть слепы к растущим рискам в течение длительного времени.
- После кризиса центробанки значительно расширили свой инструментарий (количественное смягчение, прямые кредиты), но современные макроэкономические модели все еще содержат элементы, которые заведомо неверны.
- Необходимо постоянное бдительное мониторирование – экономисты должны понимать, что не знают, где произойдет следующий кризис, и искать индикаторы риска вроде растущих пузырей.
Слишком долго все было слишком хорошо. Финансовые инновации казались приближением американской мечты о собственном доме, но привели к кризису.
Оригиналы:Подкаст на сайте РЭШ
Контрфактический анализ в экономике: метод синтетического контроля
Экономика · РЭШ · 8/10
Материал рассказывает о контрфактических исследованиях в экономике — методе, позволяющем оценить влияние исторических событий на экономическое развитие путём построения альтернативных сценариев. Пионер этого подхода, нобелевский лауреат Роберт Фогель, в 1964 году показал, что железные дороги обеспечивали лишь несколько процентов американского ВНП, опровергнув общепринятое мнение об их незаменимости. Профессор Иван Королев (Бингемтонский университет, выпускник РЭШ) развивает метод синтетического контроля, создавая для изучаемой страны «синтетического двойника» из комбинации других государств. Например, «Россия без Октябрьской революции» в его модели состоит из Финляндии (33,2%), Шри-Ланки (28,9%), Индии (20,6%) и других стран. По расчётам Королева, революция 1917 года привела к падению ВВП на душу населения с $2000–2500 до $1000 или ниже. Неожиданно, что в 1930-х годах «синтетическая Россия» оказывалась беднее реального СССР, что Королев объясняет влиянием Великой депрессии на капиталистические страны. При этом он подчёркивает, что ВВП не учитывает политические свободы, репрессии и голод. Метод также применён к анализу диктатуры Пиночета в Чили и демократизации Испании, показывая как сложное переплетение эффектов производительности и занятости. Контрфактические исследования помогают лучше понять влияние экономической политики — санкций, реформ, революций и приватизации.
Выводы автора:
- Контрфактический анализ позволяет экономистам оценить причинно-следственные связи в истории, переводя исторические споры в цифры и показывая экономическую цену альтернативных решений.
- Метод синтетического контроля более прозрачен и подходит для уникальных исторических событий, чем универсальные модели, так как показывает, из каких конкретных стран складывается альтернативный сценарий.
- Показатель ВВП на душу населения не равен динамике общественного благосостояния, поскольку не учитывает политические свободы, репрессии и другие факторы качества жизни.
Практически любой спор об экономической политике — будь то санкции, реформы, революции или приватизация — неизбежно содержит скрытый контрфактический вопрос: а что произошло бы, если бы решение оказалось другим?
Оригиналы:Альтернативная реальность экономики: чему учит «если бы»
Как превратить Хабр в базу знаний: семантическая кластеризация 34 тыс статей
Продукт и карьера · Habr · 8/10
Автор предлагает решение проблемы Хабра как социальной ленты, где качественный контент быстро теряется из вида, а корпоративные статьи и нейрослоп вытесняют работы энтузиастов. Статья описывает проект семантической кластеризации всех 34 270 статей Хабра (2006–2026) с использованием нейросетей и алгоритмов машинного обучения для трансформации ресурса в структурированную базу знаний. Процесс включил анализ каждой статьи через модель Gemma-4-31B (266 млн входных токенов, стоимость $75), создание эмбеддингов через Qwen3-VL-Embedding-2B (384 756 векторов) и кластеризацию через HDBSCAN, разделившую 30 300 статей на 7 245 групп с иерархией вплоть до 19 разделов верхнего уровня. Автор выявил тревожные тренды: доля корпоративных блогов выросла с 4% в 2012 году до 39% в 2025-м, реклама в корпстатьях достигает 77% в 2024 году, ссылки на Telegram-каналы появились в 57% корпоративных публикаций, а AI-сгенерированный контент вытесняет качественные материалы, требующие дней работы. Результаты доступны на GitHub Pages с возможностью экспорта в Obsidian, JSON, XML и трёхмерной визуализацией связей между группами статей.
Выводы автора:
- Структурированная кластеризация технического контента через LLM и машинное обучение позволяет трансформировать социальную ленту в поискабельную базу знаний, где старые актуальные статьи становятся доступны читателям и AI-агентам
- Баланс между коммерческими интересами платформы и мотивацией независимых авторов нарушен: дешевый генерируемый контент вытесняет качественные материалы, требующие значительных временных затрат
- На Хабре накопилась редкая база знаний с высоким качеством, которую можно структурировать и каталогизировать для локального использования без зависимости от облачных API сервисов
Дешевый контент вытесняет дорогой, а с приходом дешевого контента уходят и серьёзные авторы — это замкнутый круг
Оригиналы:Как превратить Хабр из ленты соцсети в библиотеку и базу знаний
Как комната влияет на продуктивность: эргономика, свет и микроклимат
Продукт и карьера · Habr · 7/10
Статья о том, как правильно обустроить домашнее рабочее место для повышения комфорта и продуктивности без больших затрат. Автор рассказывает о трёх основных проблемах, которые он обнаружил в своей комнате: неправильная эргономика (неверная высота монитора, плохая поддержка спины), плохое освещение и визуальный беспорядок. Для спины и шеи важно соблюдать принцип трёх углов — колени, таз и локти должны быть согнуты под 90 градусов, верхняя треть монитора на уровне глаз. При наклоне головы на 45 градусов нагрузка на шейный отдел позвоночника возрастает до 22 кг (синдром «текстовой шеи»). Геймерские кресла не подходят для многочасовой работы — нужны эргономичные сетчатые кресла с регулировкой поясницы, хотя автор решил проблему проще: книги под монитором и ортопедическая подушка на старый стул. Для глаз критичны два параметра ламп: CRI (индекс цветопередачи, норма 80+) и отсутствие пульсации. Дешёвые светодиоды мерцают ~100 раз в секунду, вызывая утомляемость и мигрени. Стол лучше расположить боком к окну, чтобы свет падал сбоку. Автор использовал умную лампу с расписанием: днём холодный бодрящий свет, вечером с 19:00 — тёплый янтарный. Визуальный шум (провода, хлам на столе) снижает концентрацию — мозг постоянно сканирует пространство. За час и за копейки автор организовал кабель-менеджмент: клипсы, стяжки, сетевой фильтр под столешницей. Закрытая комната 15 м² накапливает CO₂ до 1200–1500 ppm, при этом когнитивные функции падают на 15–30%, а при 1400 ppm — более чем на 50%. Биофильный дизайн (живые растения, природные текстуры) снижает стресс на 15% и повышает продуктивность на 6%.
Выводы автора:
- Комфортное рабочее место достигается не дорогой мебелью, а правильной геометрией посадки (углы 90°, монитор на уровне глаз) и эргономичными решениями на любой бюджет
- Качество света (высокий CRI, отсутствие пульсации) и его цветовая температура существенно влияют на утомляемость глаз и способность концентрироваться
- Вентиляция и живые растения критичны для когнитивных функций, так как в закрытой комнате CO₂ быстро растёт и умственная работоспособность падает на 15–50%
Когда стол завален хламом и везде торчат провода, наш мозг постоянно испытывает микронагрузку, непрерывно сканируя всё пространство вокруг и тратя на это энергию.
Коротко
ИИ и агенты
- Навыки работы с ИИ: как использовать агентов в разработке ПО – В этом эпизоде подкаста The Pragmatic Engineer Мэтт Покок рассказывает о том, как он применяет ИИ и агентов для планирования и построения программного обеспечения.
Разработка и архитектура
- OpenIDE получила поддержку C/C++ через новый плагин от сообщества – В маркетплейсе OpenIDE появился плагин C/C++ Support, разработанный независимым программистом из сообщества.
Финтех и финансы
- DNS запустил маркетплейс для сторонних продавцов с комиссией 25% – Российская сеть DNS запустила собственный маркетплейс для сторонних продавцов под названием «Селлерам».
Продукт и карьера
- Далия Офер о Гуре Офере: основатель РЭШ был моим лучшим другом – Опубликовано интервью с Далией Офер, вдовой сооснователя Российской экономической школы Гура Офера, ушедшего из жизни в 2022 году.
Прочее
- История приставки 3DO: амбициозный проект Трипа Хоукинса – Статья рассказывает об истории игровой консоли 3DO Interactive Multiplayer, созданной Трипом Хоукинсом.