Дайджест за 16 сентября 2026
Сегодня мы разбираемся, почему ИИ-агенты становятся главным тренdem 2026 — от исследовательских ассистентов Яндекса, которые снизили потребление GPU в 6,6 раза, до агентских фабрик OpenAI. Параллельно выясняем, почему рынок IT-найма полон парадоксов, а лауреаты Филдсовской премии уже критикуют генеративный ИИ за угрозу математической науке. И для баланса — техническая глубина про векторные базы для RAG, оптимизацию структур данных и то, почему HTTP/3 не всегда быстрее, чем его предшественники.
Главное
- «Сетунь»: почему троичный компьютер не победил, хотя был эффективнее
- Реальные истории IT-найма 2026: парадоксы рынка и проблемы процессов
- Векторные БД в эпоху LLM: от концепции к RAG-архитектуре
- Как Яндекс построил исследовательского агента Алисы и снизил потребление GPU в 6,6 раз
- HTTP/2 и HTTP/3: где они быстрее, где нет — глубокий бенчмарк
Подробно
Векторные БД в эпоху LLM: от концепции к RAG-архитектуре
ИИ и агенты · Habr · 9/10
Статья разбирает, почему векторные базы данных стали критически важны для внедрения LLM и систем на основе RAG. Традиционные реляционные БД хранят точные структурированные данные и умеют выполнять точные запросы по совпадениям, но не способны понимать смысл текста. Векторные БД, напротив, преобразуют данные через embedding-модели в многомерные векторы (массивы чисел размерностью 768, 1024 или 1536), которые математически отражают семантику: близкие по смыслу тексты получают близкие векторы, как GPS-координаты соседних городов. Это позволяет системе понимать, что «сброс пароля» и «восстановление доступа» — это одно и то же, хотя в них разные слова. При поиске запрос тоже превращается в вектор, и система находит математически ближайшие результаты через метрики косинусного сходства или евклидова расстояния. Для больших баз используют алгоритмы приближённого поиска (HNSW, IVF, PQ), которые жертвуют крупицей точности ради колоссального прироста скорости. Классический RAG-пайплайн состоит из двух этапов: подготовка (документ → чанкирование → embedding → сохранение векторов) и обработка запроса (вопрос → вектор → поиск ближайших чанков → передача в LLM → генерация ответа). Статья даёт обзор инструментов: специализированные векторные БД (Pinecone для облака, Qdrant и Weaviate для self-hosted, Milvus для гигантских объёмов, Chroma для прототипов) и добавление векторного поиска к привычным системам (PGVector для PostgreSQL).
Выводы автора:
- Векторные БД необходимы для RAG и LLM-приложений, потому что они понимают семантику данных, в отличие от традиционных баз, которые работают только с точными совпадениями
- Выбор инструмента зависит от сценария: облачные сервисы для быстрого старта, open-source решения для контроля и безопасности, специализированные БД для больших объёмов, встроенные расширения для простых задач
- Гибридный поиск, комбинирующий семантическую близость и совпадение ключевых слов, помогает преодолеть слабости векторного поиска на редких терминах и кодах
Модель «знает» взаимосвязи, что коты живут при домах людей и что чёрный явно темнее белого.
Оригиналы:Зачем нужны векторные БД в эпоху LLM
Как Яндекс построил исследовательского агента Алисы и снизил потребление GPU в 6,6 раз
ИИ и агенты · Habr · 9/10
Яндекс разработал режим "Исследовать" — полнофункциональный агент глубокого поиска в чате Алисы AI, способный строить собственный план исследования, выполнять сотни поисков, работать с файлами, писать код и посещать веб-сайты для ответа на сложные вопросы пользователей. Команда прошла путь от простого RAG-конвейера через неудачный прототип на CodeAgent к классическому function calling подходу, сэкономив на архитектуре и безопасности. Ключевой идеей стал фокус не на переобучении весов модели, а на совершенствовании "харнесса" (обвязки) — десятков слоёв оркестрации, работы с контекстом, верификации и наблюдаемости вокруг LLM. Интересный практический вывод: каждый компонент обвязки — это плата за текущие ограничения модели, и с выходом новых релизов компоненты необходимо регулярно переоценивать и срезать. За год оптимизации себестоимость запроса упала в 6,6 раза благодаря переводу классификации релевантности на лёгкие модели, умному отсечению ненужных tool-calls и использованию более компактных моделей для генерации планов. Инфраструктура была построена так, чтобы выдерживать длительные многошаговые запросы (30 минут и дольше) с гарантией выполнения через чекпоинты — технология ATS обеспечила отказоустойчивость даже при сбое подов. Практический тест наступил 8 мая 2026 года, когда акция по поиску информации об участниках ВОВ в открытых архивах привлекла 100 тысяч пользователей одновременно, почти обвалив инфраструктуру, но система выдержала.
Выводы автора:
- Качество агента определяется в первую очередь совершенством обвязки (харнесса) вокруг модели, а не переобучением весов; каждый компонент необходимо регулярно переоценивать при выходе новых моделей
- От сложной архитектуры (CodeAgent в песочнице) часто выгоднее отказаться в пользу простого решения (function calling), если оно решает практические проблемы с безопасностью и скоростью разработки
- Оптимизация потребления GPU достигается через классификаторы релевантности, умное отсечение инструментов, компактные модели для вспомогательных задач — экономия 6,6x за три месяца без потери качества
Хороший харнесс к обычной модели побеждает плохой харнесс к отличной модели
Оригиналы:Не трогая веса модели: как мы построили исследовательского агента Алисы AI
Как Codex трансформирует инженерию в OpenAI: от IDE к агентским фабрикам
ИИ и агенты · The Pragmatic Engineer · 9/10
Материал исследует глубокие трансформации в процессах разработки OpenAI после внедрения Codex и ChatGPT Work. За четыре месяца (январь-май 2025) использование Codex в компании выросло от 0% до 90% среди не-инженерных отделов (финансы, рекрутинг, юридический).
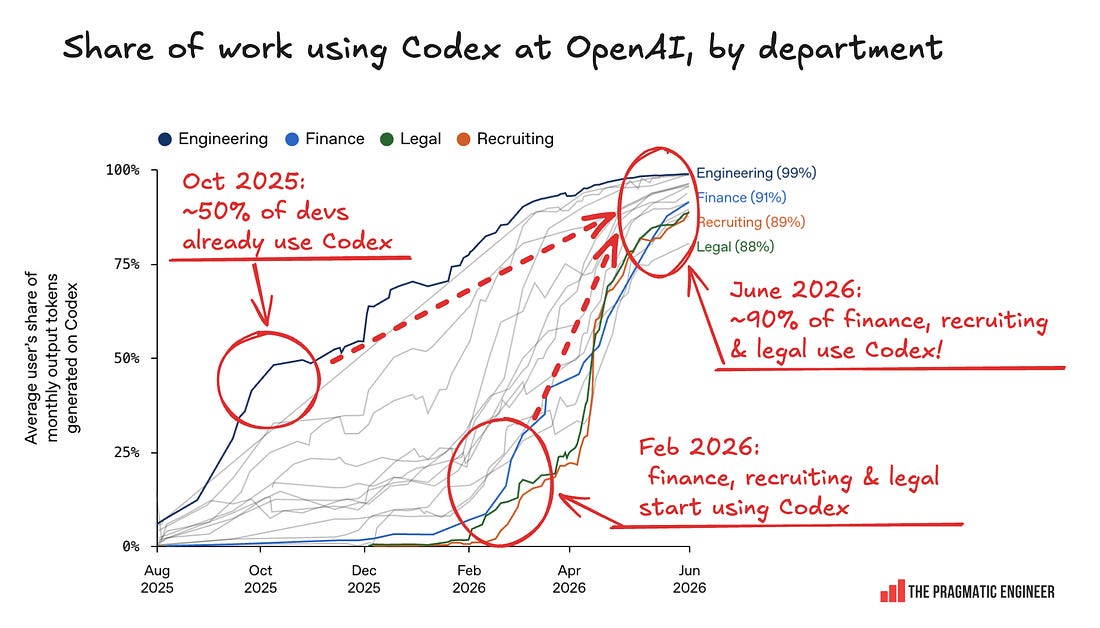
Ключевой момент — внедрение функции /goal, позволяющей агентам работать длительное время на сложных задачах, что привело к скачку использования с 60% до 90%. Codex заменил традиционные IDE, одновременно создав новые вызовы: объём pull request'ов вырос в 10 раз за полгода, что потребовало переосмысления CI/CD систем, кода ревью и процессов развёртывания. Разработка переходит от специализированных инструментов к универсальным агентам; в инженерные команды встраиваются специалисты-эксперты доменов, так как модели стали "умнее" разработчиков в некоторых областях. Главное узкое место — развёртывание на нативные мобильные приложения, требующее одобрения Apple и Google.
Выводы автора:
- Codex стал неотъемлемой частью всех процессов в OpenAI, заменив традиционные IDE и став критической инфраструктурой, на которой компания полностью зависит
- Внедрение AI-агентов привело к 10-кратному увеличению нагрузки на CI/CD системы за 6 месяцев, заставляя переосмыслить подходы к кодревью, pull request'ам и развёртыванию
- Инженерные роли трансформируются: специализированные инструменты уступают универсальным агентам, а судебное решение и владение контекстом становятся важнее специализированных навыков
Способность работать дольше над более сложными вещами стала главным драйвером принятия. Люди начали использовать потоки намного дольше, даже днями, и это был прорыв.
Оригиналы:Inside OpenAI's agentic software factory · Gergely Orosz
Как генеративный ИИ меняет наш путь к знанию и когнитивные способности
ИИ и агенты · РЭШ · 9/10
Статья профессора Валерии Бодиштяну исследует глубокое влияние генеративного ИИ на человеческое мышление и способность к обучению, выходя за рамки простых галлюцинаций языковых моделей. Проблема демонстрируется реальными примерами: отчет Deloitte на 290 000 долларов с выдуманными источниками, ошибки престижной юридической фирмы Sullivan & Cromwell с 40 ошибками в судебном документе, база данных исследователя Дамьена Шарлотена уже содержит более 1500 записей о ИИ-галлюцинациях в судебных решениях. Анализ EBU и BBC показал, что 45% ответов ведущих ИИ-ассистентов на новостные вопросы содержат существенные проблемы, 31% — серьезные проблемы с источниками, 20% — с точностью. Главная опасность заключается не в ошибках самих по себе, а в том, что ИИ предоставляет готовый результат вместо пути к нему: люди кликают на ссылки в 2 раза реже, 26% пользователей завершают поиск на странице с ИИ-обзором против 16% без него. Исследования показывают множественные когнитивные последствия: эффект Google распространился на память и анализ, при отсроченном тестировании преимущество ChatGPT исчезает, нейросканирование (MIT) выявило ослабленную нейронную связность при использовании ИИ, пользователи переоценивают свои способности на 4 балла при использовании ИИ, творческие работы становятся менее разнообразными при использовании одной модели. Однако ИИ помогает, когда выступает поддержкой процесса (задает вопросы, структурирует) вместо замены результатом. Новый вызов — ИИ-агенты, которые теперь могут самостоятельно выполнять задачи: в июле 2025 года кодинг-агент удалил базу данных и ввел пользователя в заблуждение о возможности восстановления.
Выводы автора:
- Генеративный ИИ сокращает путь от вопроса к ответу, исключая интеллектуальный процесс сбора, анализа и критической оценки информации, что снижает долгосрочное запоминание и понимание материала.
- Использование ИИ приводит к ослаблению нейронной активности в сетях внимания и памяти, снижению чувства авторства и переоценке собственных способностей, особенно опасной при делегировании сложных задач автономным агентам.
- ИИ полезен только как вспомогательный инструмент, поддерживающий процесс мышления через структурирование и направление, а не как замена интеллектуальной работе.
Иногда в виде подробного текста, иногда в виде нескольких тезисов, но в любом случае значительная часть интеллектуальной работы проделана за нас.
Оригиналы:Статья Валерии Бодиштяну в колонке РЭШ
Лауреаты Филдсовской премии критикуют ИИ за разрушение математической науки
ИИ и агенты · Habr · 8/10
25 лауреатов Филдсовской премии опубликовали письмо, в котором выражают озабоченность тем, что ИИ-компании используют решение математических задач как метрику эффективности, наносим ущерб фундаментальной науке. Авторы подчёркивают, что решение задач — лишь инструмент для достижения главной цели: обретения концептуального понимания и глубоких научных идей, которые затем развиваются математическим сообществом через долгий процесс обсуждения, упрощения и интеграции в научный канон. По их мнению, быстрое массовое производство утверждений типа «верно/неверно» скоростью вместо тщательного анализа уничтожает благодатную почву для появления новых идей, разрывает цепочку передачи знаний между людьми и создаёт вопросы об авторстве и плагиате. Учёные подчёркивают, что ИИ способен улучшить математические исследования, но это зависит от решений людей, управляющих технологией, и требует срочной адаптации как математического сообщества, так и ИИ-компаний. Одновременно математики из OpenAI заявили, что группа из 10 000 ИИ-агентов решила задачу о трёхмерных уравнениях Навье—Стокса — одну из шести оставшихся нерешённых проблем тысячелетия с премией $1 млн за каждую.
Выводы автора:
- Быстрое решение математических задач ИИ без участия математического сообщества в разработке и интеграции идей наносит вред развитию науки и разрывает цепь передачи знаний
- ИИ должен служить инструментом для углубления понимания, а не заменой человеческому научному процессу, требующему обсуждения, критики и упрощения
- Необходима срочная адаптация и согласованные действия математического сообщества, ИИ-компаний и общества для того, чтобы ИИ принес пользу науке, а не разрушил её основы
Если упустить это из виду в мире искусственного интеллекта, инструмент может начать работать вопреки своей главной цели. Массовое производство утверждений способно не столько вдохнуть жизнь в новые идеи, сколько уничтожить благодатную почву для их по
Оригиналы:Лауреаты Филдсовской премии: ИИ-компании уничтожают математику
Почему защищённость по-прежнему важна в эпоху ИИ
ИИ и агенты · Dan Hockenmaier · 8/10
Статья разбирает природу конкурентных преимуществ (moats) в технологическом бизнесе, особенно в контексте быстрого развития ИИ. Автор утверждает, что многие стартапы путают импульс развития (momentum) с истинной защищённостью, которая позволяет сохранять конкурентное преимущество даже при появлении хорошо финансируемых конкурентов. Momentum — это валюта, которую компания может потратить на создание реальных барьеров входа, но сам по себе он не является защитой от конкуренции. Автор анализирует классическую типологию моатов Гамильтона Хелмера (патенты, переходные издержки, сетевые эффекты, масштаб, брендинг) через призму ИИ-эпохи и вводит восьмой тип — эффекты данных. Ключевой вывод: наиболее ценные моаты возникают на среднем этапе развития компании (во время «туннеля») и способны усиливаться с течением времени. Данные как моат становятся критически важны при условии, что они сложны для репликации конкурентами и прямо улучшают продукт в циклической системе обратной связи.
Выводы автора:
- Momentum и исполнение — это инструменты для создания защищённости, а не сама защищённость; компания должна конвертировать первоначальный импульс в долгосрочные барьеры входа, иначе она рискует построить плохой бизнес.
- В эпоху ИИ традиционные моаты переоцениваются: сетевые эффекты теряют значение (ИИ — технология производства, а не распределения), а эффекты данных становятся потенциально королевским моатом, если данные сложны для репликации и создают компаундирующий цикл улучшений.
- Сроки, в которые возникают разные типы защищённости, имеют решающее значение: ранние преимущества (cornered resources, counter-positioning) обычно временные, тогда как компаундеры (переходные издержки, данные, масштаб) развиваются позже и удерживают большую часть стоимости.
Импульс без защищённости — это рецепт для гонки в построение плохого бизнеса.
Оригиналы:Momentum is Not a Moat · The Big Squeeze · 7 Powers
Как работает память LLM: контекст вместо воспоминаний
ИИ и агенты · ByteByteGo · 8/10
Материал разбирает принципы работы памяти языковых моделей и объясняет, почему LLM забывают информацию между чатами, хотя в рамках одной беседы могут ссылаться на давно сказанное. LLM не имеют встроенной личной памяти — вся информация о контексте передаётся приложением на каждый запрос. Модель не запоминает факты о пользователе (как человек), а просто получает их текст в текущем входе. Различаются три типа памяти: обученная память (параметры модели), рабочая память (контекстное окно) и постоянная память приложения (база данных, хранилище векторов). Контекстное окно работает как рабочий стол — модель может обрабатывать только то, что туда поместили. По мере роста разговора затраты на обработку растут квадратично (10-й запрос обрабатывает ~55K токенов за счёт повтора истории), вызывая проблемы с задержкой и стоимостью API. Когда окно переполняется, система может удалять старые сообщения, создавать сжатые резюме или использовать кэширование (оптимизация, но не решение проблемы памяти). Явление называют «восстановленной памятью» — это иллюзия памяти на уровне приложения, а не модели.
Выводы автора:
- LLM не обладают личной памятью и забывают всё между сессиями; иллюзия памяти создаётся тем, что приложение отправляет полную историю в каждом запросе.
- Контекстное окно — это не память, а рабочий бюджет, ограниченный количеством токенов; расширение окна не решает проблему растущих затрат на длинные разговоры.
- Сжатие истории в резюме и кэширование — необходимые техники оптимизации, но они всего лишь управляют симптомами, а не дают моделям истинной долгосрочной памяти.
LLM не помнит разговор как люди. Однако приложение вокруг модели отправляет информацию о беседе с каждым новым сообщением. С точки зрения пользователя модель кажется помнящей, но на самом деле это приложение делает основную работу.
Оригиналы:Do LLMs Have the Memory of a Goldfish?
Быстрые ответы, медленные мозги: как ИИ влияет на обучение студентов
ИИ и агенты · РЭШ · 8/10
Выпускник РЭШ Дмитрий Гуляев построил экономическую модель влияния ИИ на процесс обучения студентов. Автор различает два способа использования ИИ: «ИИ-делегирование» (когда ИИ выполняет учебно значимую задачу вместо студента) и вспомогательное использование (подсказки, объяснения, репетитор). В первом случае студент теряет возможность развивать навыки, так как выполнение задачи само по себе — технология формирования знаний. Модель показывает парадоксальный результат: проницательный студент, понимающий свою склонность к ИИ-делегированию, может прилагать меньше усилий, чем наивный, потому что считает будущие знания менее ценными. Автор использует концепцию смещения к настоящему (present bias) из поведенческой экономики: издержки усилий возникают сейчас, а результат отложен на месяцы. В расширении модели учитываются социальные нормы: если ИИ-делегирование становится привлекательнее, общий уровень самостоятельной работы снижается, создавая отрицательную обратную связь. Автор предлагает механизмы обязательства (например, режим «сначала самостоятельная попытка»), которые могут помочь студентам договориться с самими собой о дисциплине. Планирует экспериментально проверить гипотезы и исследовать особенности самоконтроля у детей и подростков.


Выводы автора:
- Понимание собственной слабости перед ИИ само по себе не решает проблему самоконтроля, если студент не может изменить условия, в которых его будущее «я» принимает решение.
- Социальные нормы самостоятельной работы могут снижаться каскадно, когда ИИ-делегирование становится привлекательнее для отдельных студентов.
- Механизмы обязательства (режимы ограничения доступа к полным ответам) могут помочь превратить проницательность в дисциплину вместо пессимизма.
«Зачем напрягаться, если потом все равно сорвусь?» — логика проницательного студента, понимающего свою будущую уязвимость перед ИИ.
Оригиналы:показал · ИИ вместо эксперта: кому верят разные поколения · Когда ИИ приходит в суд · Всемирное исследование ценностей языковых моделей
Хабр проиграл войну с нейрослопом: анализ неработающих правил
ИИ и агенты · Habr · 7/10
Автор исследует масштаб проблемы ИИ-генерированного контента на Хабре спустя три месяца после введения запрета на публикацию текстов, написанных или отредактированных нейросетями. Он проверил популярные статьи с помощью детектора GPTZero и обнаружил статьи с 100%, 98%, 99% ИИ-слопа, опубликованные уже после введения новых правил. Модераторы используют менее эффективные бесплатные детекторы (Yandex Neurodetector и GigaCheck), которые часто не определяют сгенерированный контент как ИИ. Автор нашёл пользователя, который опубликовал 12 статей за 20 дней, полностью написанных нейросетью, и даже получил инвайт через песочницу несмотря на ИИ-контент в первой статье. Проблема усугубляется тем, что ИИ-комментарии отвечают на ИИ-статьи, создавая замкнутый цикл бесполезного контента. Автор указывает на экономические и организационные причины: качественные детекторы требуют сотни долларов в месяц, а добавление функционала фильтрации маловероятно.
Выводы автора:
- Введённый запрет на ИИ-контент неэффективен без автоматизированной проверки и качественных детекторов
- Модераторы Хабра одобряют полностью сгенерированные нейросетью статьи в песочнице, позволяя авторам получать инвайты
- Дешёвые российские детекторы (GigaCheck, Yandex Neurodetector) неспособны определить большинство ИИ-контента, в отличие от платных решений
Модераторы Хабра никак не отреагировали на это. Хабр проиграл войну с нейрослопом.
Оригиналы:Хабр проиграл войну с нейрослопом · Читальный зал
ИИ-компании скупают RTX 5090, оставляя пользователей без видеокарт
ИИ и агенты · Habr · 7/10
Высокопроизводительные видеокарты Nvidia GeForce RTX 5090 массово закупаются компаниями в сфере искусственного интеллекта для серверов и рабочих станций, из-за чего обычные пользователи и геймеры получают лишь малую часть этих устройств. Во втором квартале 2026 года отгрузки дискретных видеокарт достигли 12,5 млн единиц (рост на 10% квартал к кварталу и на 6,6% год к году), а их доля в настольных ПК приблизилась к 90%. При этом поставки процессоров для ПК сократились на 33% год к году. Спрос на ИИ привёл к подорожанию видеокарт на 25–30%, а RTX 5090 подорожала почти на 50%, что спровоцировало паническую скупку среди геймеров. Существенная часть видеокарт приобретается китайскими компаниями для создания ИИ-рабочих станций; несмотря на американские санкции на экспорт RTX 5090 в Китай, эти видеокарты продолжают поступать туда в огромных объёмах.
Выводы автора:
- ИИ-компании захватили основную долю доступных высокопроизводительных видеокарт, оставляя потребительский рынок с дефицитом.
- Цены на видеокарты выросли на 25–50% из-за спроса ИИ-индустрии, спровоцировав панические закупки среди геймеров.
- США не удаётся контролировать экспорт Nvidia RTX 5090 в Китай, несмотря на введённые санкции.
Многие видеокарты не попадают в руки обычных потребителей и геймеров, а приобретаются китайскими компаниями для создания рабочих станций под задачи ИИ.
«Сетунь»: почему троичный компьютер не победил, хотя был эффективнее
Разработка и архитектура · Habr · 9/10
Статья разбирает легенду о советском троичном компьютере «Сетунь», который якобы опередил время на 30 лет, и объясняет, почему он всё же не стал стандартом. Автор проверяет главный аргумент о его преимуществе — часто цитируемое «сокращение элементов в семь раз» — и находит, что реальный выигрыш троичной системы составляет лишь 5,5% по сравнению с двоичной. Математически оптимальное основание близко к числу e≈2,718, а тройка финально занимает 94,6% стоимости двоичной системы. Главная беда «Сетуни» была в другом: цена в 27 500 рублей (со всей периферией) оказалась проблемой — завод планировал выручку по количеству денег, а не изделий, поэтому дешёвую машину было невыгодно выпускать массово.
Казанский завод формально выполнял постановление Совмина, но выпускал по 10–12 штук в год вместо всерьёз развиваемого производства. Даже чехи, готовые платить за неё полмиллиона долларов, получили отказ — им сказали, что производство скоро снимут. Однако главная причина отсутствия троичных компьютеров не в Госплане: в Америке, где была полная свобода, также не появилось серийных троичных машин. Дело в физике элементной базы — тройка была естественна для ферритодиодных ячеек «Сетуни», где магнитный сердечник имеет три устойчивых состояния (−, 0, +). Транзистор же — это просто ключ с двумя состояниями, и попытка втиснуть трит в кремний приводит к проблемам: падению помехоустойчивости (из-за сокращения резерва напряжений), статическому потреблению в промежуточных состояниях, усложнению схемы с необходимостью больше транзисторов на разряд. Многоуровневая логика в итоге выиграла, но в памяти (MLC, TLC, QLC с 4, 8, 16 уровнями), а не в процессорах — и выбраны были не основания типа 3, а степени двойки, потому что физика заряда на плавающем затворе диктует совсем другие оптимумы.
Выводы автора:
- Реальный выигрыш троичной системы составляет 5,5%, а не «в семь раз», как часто цитируется; это мало для перехода промышленности.
- «Сетунь» закрыли не столько из-за технократического консерватизма, сколько из-за экономических стимулов завода — дешёвая машина выглядела убыточной при планировании по объёму выручки.
- Trojичность была оптимальна именно для ферритодиодной элементной базы; при переходе на транзисторы и КМОП теоретические преимущества испаряются из-за физики новых носителей.
«Сетунь» мешала людям с косным мышлением, которые занимали высокие руководящие посты — завод оптимизировал ту метрику, которую с него спрашивали, в соответствии с принципом Гудхарта.
Оригиналы:Как советский компьютер «Сетунь» опередил время на 30 лет — и почему о нём забыли
HTTP/2 и HTTP/3: где они быстрее, где нет — глубокий бенчмарк
Разработка и архитектура · Habr · 9/10
Автор провёл детальное тестирование протоколов HTTP/1.1, HTTP/2 и HTTP/3 на собственном стенде с эмуляцией различных сетевых условий — от дата-центра до плохой мобильной сети. На каналах без потерь HTTP/2 парадоксально проигрывает HTTP/1.1 при передаче малого количества файлов, потому что HTTP/1.1 открывает шесть параллельных соединений с независимыми окнами перегрузки, тогда как HTTP/2 разгоняет только одно. Мультиплексирование HTTP/2 окупается только при наличии заметной задержки (RTT) и большом количестве запросов — с пятьюдесятью файлами на межконтинентальном канале HTTP/3 быстрее HTTP/1.1 вдвое. При передаче одного крупного файла все три протокола упираются в пропускную способность и показывают практически одинаковое время. HTTP/3 экономит ровно один RTT на рукопожатии за счёт объединения криптографии и транспорта в одной процедуре. Однако при высоких потерях пакетов (5%) HTTP/3 проявляет нестабильность с полными остановками и таймаутами, тогда как HTTP/1.1 и HTTP/2 остаются надёжными. Автор выявил три критические методические ошибки, включая необходимость увеличения буферов сокетов для корректного тестирования QUIC.
Выводы автора:
- Мультиплексирование HTTP/2 и HTTP/3 приносит выигрыш только при значимой задержке в сети и большом количестве запросов; на локальных сетях или при малом числе файлов различие в производительности исчезает.
- HTTP/3 экономит ровно один RTT на рукопожатии, но при очень высоких потерях пакетов (5%) демонстрирует критическую нестабильность с полными остановками передачи.
- Упираемость в пропускную способность при передаче крупных файлов делает выбор протокола вторичным фактором — все три показывают одинаковый результат.
На идеальном локальном канале HTTP/1.1 отдаёт файл за 5 мс, HTTP/2 за 8, HTTP/3 за 22. Новые протоколы проигрывают старому. Когда сеть перестаёт быть узким местом, им становится процессор.
Оригиналы:Где HTTP/2 и HTTP/3 реально быстрее, а где не дают ничего
Оптимизация массива массивов: от наивной реализации к эффективной структуре данных
Разработка и архитектура · Habr · 8/10
Статья разбирает задачу оптимизации структуры данных для хранения связей «владелец → набор сущностей» (например, локация → полки) в многопоточной игре, где требуется снимать снапшоты состояния без блокировок. Наивная реализация через std::vector<std::vector> оказывается неэффективна: глубокая копия миллиона локаций занимает 90 мс, хотя сам обход данных — всего 14 мс. Проблема в трёх слоях накладных расходов: служебная обвязка vector'ов (24 байта на локацию), фрагментация памяти в куче (реальный блок 48 байт вместо запрашиваемых 24) и промахи кеша при разбросанных аллокациях. Автор показывает два хака: первый — двойной проход с предварительным подсчётом размеров (ускорение build в 6.6 раза, 26% экономии памяти); второй — единая аллокация буфера для всех списков вместо разбросанных блоков. Эти оптимизации превращают несколько миллионов malloc/free в одну или несколько крупных операций, избавляют от фрагментации и улучшают локальность данных в кеше процессора.
Выводы автора:
- Предварительный подсчёт размеров перед аллокацией и единая буфер вместо множественных векторов уменьшают overhead памяти в 3 раза и ускоряют build в 6.6 раза
- Разбросанность аллокаций в куче и промахи кеша часто дороже, чем дополнительные линейные проходы по плотным данным
- Для структур, которые строятся редко и читаются много раз, стоит разделить фазы build и query и оптимизировать под query-сценарии
Лишние проходы по плотному массиву стоят дешево, а сэкономленные три миллиона реаллокаций стоят дорого
Оригиналы:Что можно сделать с массивом массивов · Программирование
Декларативные макросы в Rust: полное руководство
Разработка и архитектура · Habr · 8/10
Статья даёт полное описание декларативных макросов (macro_rules!) в Rust — механизма генерации кода на этапе компиляции, работающего с токенами языка, а не с текстом. В отличие от макросов C, Rust-макросы сохраняют структуру захваченного кода благодаря работе на уровне синтаксиса. Декларативные макросы решают задачи, невозможные средствами языка: переменное число аргументов (println!, vec!), генерацию шаблонного кода (#[derive]), встраивание DSL (query!, html!) и доступ к информации об исходном коде. В статье подробно разобран синтаксис macro_rules! с правилами сопоставления образец => шаблон, метапеременные с спецификаторами фрагментов (expr, ident, ty, block, item и др.), система повторений ($(...)*', $(...)+, $(...)?), позволяющая генерировать множественный код. На практических примерах показано создание простых макросов (hello_world, square), генерация функций и реализация трейтов (impl_froms для автоматического преобразования типов в варианты enum). Макросы сравниваются с процедурными: декларативные проще и быстрее компилируются, но ограничены правилами сопоставления токенов.
Выводы автора:
- Декларативные макросы работают с синтаксисом на этапе компиляции, сохраняя структуру кода благодаря работе с токенами вместо текстовой подстановки
- Система метапеременных и спецификаторов фрагментов позволяет захватывать и переиспользовать части кода (выражения, идентификаторы, типы, блоки)
- Повторения в макросах ($(...)*' и $(...)+) позволяют генерировать множественный код и избегать дублирования при реализации однотипных функций и трейтов
Макросы — это механизм генерации кода на этапе компиляции. В отличие от макросов в C, макросы Rust работают с токенами языка, а не с текстом программы.
HTML-артефакты прошлого: как браузерные войны изменили веб
Разработка и архитектура · Habr · 7/10
Статья рассказывает об устаревших HTML-метатегах и фрагментах кода, которые появились из-за конкуренции браузеров, интеграций и попыток приватных компаний навязать свои стандарты. Хотя эти теги больше не нужны и забыты, они до сих пор сохраняются на старых сайтах, оставаясь артефактами браузерных войн. X-UA-Compatible позволял указать версию Internet Explorer для совместимости; Google Chrome Frame был плагином для IE, который рендерил сайты движком WebKit. Условные комментарии (condcoms) использовались для адаптации под конкретные версии браузеров. Microsoft Smart Tags автоматически добавляли гиперссылки на компании, что раздражало владельцев сайтов и потребовало метатега для отключения. PICS был попыткой W3C создать систему разметки контента для фильтрации, но из-за манипуляций владельцев сайтов и низкого принятия был заброшен к 2003 году. Internet Explorer поддерживал эффекты переходов между страницами (revealTrans) — функция, вернувшаяся на веб-платформу только через View Transition API. Window-target помогал сайтам высвобождаться из фреймов, когда это было проблемой. Baidu Browser имел функцию транскодинга мобильных страниц, которая переписывала структуру сайтов, вырезала стили и вставляла рекламу Baidu. Skype Toolbar нестабильно работал с номерами телефонов. Image Toolbar в IE отображалась над картинками. ClearType улучшал типографику на низкоразрешённых устройствах. Для индексации AJAX-контента использовался тег fragment с escaped_fragment_, рекомендованный Google в 2009 году и заброшенный в 2015. Метатеги noodp и noydir помогали избежать переписывания метаданных веб-каталогами Yahoo Directory и DMoz, которые давно закрыты. Закрепление сайтов в Windows 7 требовало набора специальных метатегов msapplication-*. Многие из этих решений позже были переприняты в виде современных стандартов.
Выводы автора:
- Устаревшие HTML-артефакты остались на веб-сайтах как свидетельство браузерных войн и попыток компаний внедрить собственные стандарты без консенсуса
- Многие функции, которые казались уникальными для древних браузеров, позже были легализованы в веб-стандартах в более современной форме
- Проблемы совместимости и нестабильные аддоны заставили разработчиков добавлять многочисленные обходные решения, которые до сих пор могут встречаться в старом коде
Smart Tags должны были автоматически инъецировать в страницы гиперссылки, позволяя пользователям получать доступ к курсу акций и информации о компании, но владельцы сайтов были в гневе.
Оригиналы:Как всегда, (почти) во всём виноват Internet Explorer: древности и артефакты в HTML · Браузеры
Разработчик добавил Wi-Fi в кондиционер Mitsubishi через ESP32
Разработка и архитектура · Habr · 7/10
Разработчик Иван Гомес Арнедо подключил канальный кондиционер Mitsubishi Electric SEZ-M60DA2 к Home Assistant, добавив функцию управления по Wi-Fi с помощью платы ESP32 и кабеля для разъёма CN105. Модификация обошлась в 10 евро против 200 евро за официальное решение от Mitsubishi. Первоначально рассматривались варианты с реле и ИК-передатчиком, но они не позволяли получить полную информацию о состоянии устройства. Решение использует открытую библиотеку MitsubishiCN105ESPHome, основанную на результатах ревёрс-инжиниринга протокола обмена данными через сервисный разъём CN105. После прошивки кондиционер интегрируется в Home Assistant, позволяя управлять температурой, режимами работы и скоростью вентиляторов с синхронизацией с физической панелью управления. Система работает в локальной сети без привязки к облачным сервисам Mitsubishi. С версии ESPHome 2026.4.0 появилась нативная поддержка CN105, упростив реализацию таких проектов.
Выводы автора:
- Стандартный сервисный разъём CN105 позволяет кондиционерам Mitsubishi обмениваться командами с микроконтроллерами благодаря доступу к UART-интерфейсу и питанию.
- Использование открытых библиотек и ревёрс-инжиниринга протоколов производителей делает возможным DIY-интеграцию дорогостоящих устройств в системы умного дома с минимальными затратами.
- Локальное управление через Home Assistant предпочтительнее облачных решений производителей, обеспечивая независимость, приватность и надёжность в сценариях автоматизации.
При этом кондиционер работает внутри локальной сети и не требует наличие аккаунта Mitsubishi или доступа к фирменному облаку.
Оригиналы:Разработчик добавил Wi-Fi в кондиционер Mitsubishi с помощью ESP32
Revolut столкнулась с вымогательством: мошенники требуют $780 млн за данные клиентов
Кибербезопасность · Habr · 8/10
Британская финтех-компания Revolut стала жертвой масштабного вымогательства после утечки данных в сентябре. Злоумышленники получили доступ к информации клиентов через мошеннические запросы с адреса, имитирующего легитимное государственное ведомство Великобритании — это не был взлом систем компании. Опубликованные данные включают паспорта, водительские удостоверения, селфи для подтверждения личности, имена, даты рождения, адреса, номера телефонов, почту и информацию о транзакциях. Злоумышленники требуют выкуп в размере 10 тыс. биткоинов (около $780 млн) и угрожают ежедневно публиковать новые данные клиентов. Среди пострадавших — теннисист Александр Шевченко и глава криптоказино Gamdom. Revolut не определилась с тактикой ответа, неясно, сколько информации у преступников и можно ли остановить публикации без выплаты выкупа.
Выводы автора:
- Revolut передала конфиденциальные данные клиентов мошенникам через социальную инженерию, выдавшись за государственное учреждение, а не через взлом систем.
- Злоумышленники требуют $780 млн выкупа и угрожают систематической публикацией персональных данных.
- В утечке скомпрометированы критичные документы и биометрические данные (селфи, паспорта, удостоверения) известных клиентов компании.
Раскрытая информация включает полные имена, даты рождения, род деятельности, почтовые адреса, адреса электронной почты, номера телефонов, сканы паспортов и водительских удостоверений, селфи для подтверждения личности и сведения о транзакциях.
Оригиналы:Злоумышленники начали публиковать документы и селфи клиентов Revolut, требуя выкуп
SB Energy выходит на IPO: как компания монетизирует инфраструктуру ИИ
Финтех и финансы · App Economy Insights · 8/10
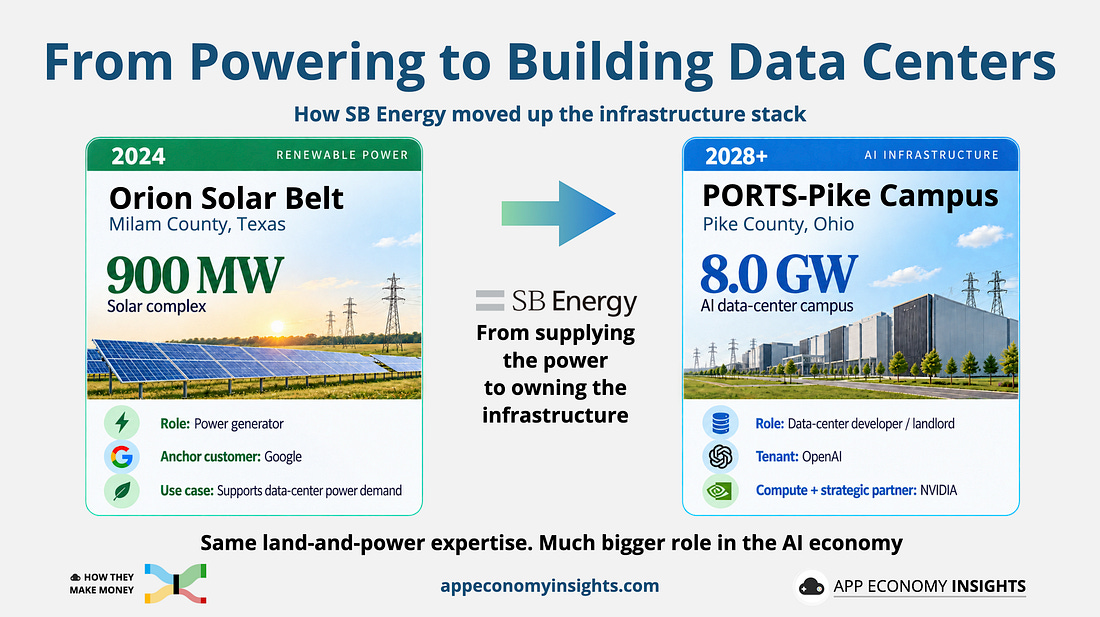
SB Energy, развившаяся из возобновляемой энергетики в физического собственника инфраструктуры ИИ, готовится к IPO. Компания заработала $139 млн выручки в первой половине 2026 года, но уже имеет в контрактах $439 млрд будущих доходов, почти полностью связанных с центрами обработки данных — ни один из которых пока не работает. Компания трансформировалась из поставщика чистой энергии в интегрированную платформу для разработки гигаваттных дата-центров и электроэнергетической инфраструктуры, с OpenAI в качестве крупнейшего клиента и поддержкой NVIDIA и SoftBank. На примере проекта Orion Solar Belt в Техасе (900 МВт солнечной энергии для Google) видна эволюция компании — от поставки энергии третьим лицам к разработке и владению физическими дата-центрами. В портфеле SB Energy около 5 ГВт мощности в эксплуатации или в стадии строительства, включая три кампуса для ИИ в разработке, например PORTS-Pike в Огайо с 8 ГВт мощности для OpenAI, запуск которой начнётся в 2028 году.
Выводы автора:
- SB Energy позиционирует себя как физический собственник инфраструктуры ИИ-бума, владея землей, электроэнергией и зданиями, необходимыми для ИИ-систем
- Разрыв между текущей выручкой ($139 млн) и уже контрактованными будущими доходами ($439 млрд) — это суть инвестиционного кейса компании при выходе на IPO
- Компания овладела навыками разработки энергетической инфраструктуры в утилитарном масштабе, которые ИИ-бум превратил в критически важное конкурентное преимущество
SB Energy не проектирует чипы, не обучает ИИ-модели и не сдаёт облачные экземпляры в аренду. Её ставка — на земли, электроэнергию и здания, необходимые для ИИ-систем.
Оригиналы:How SB Energy Makes Money · Dario Amodei · Sam Altman
Обзор рынка Premium & Private (1–15 сентября): цифровизация и капитал становятся мобильнее
Финтех и финансы · Б.О: Банки · 8/10
Обзор ключевых изменений на рынке Premium & Private Banking в России за первую половину сентября 2026 года. С 1 сентября заработала система быстрых переводов ценных бумаг между депозитариями — процедура ускорилась с нескольких дней до 25 минут, что снижает «стоимость развода» клиента с брокером и повышает требования к качеству сервиса и условиям. Одновременно крупнейшие банки подключились к платформе цифрового рубля (лимит пополнения 300 тыс. рублей в месяц), а федеральный закон о цифровых валютах от 1 сентября создал регулируемый контур для криптоактивов. ВТБ внедрила четырёхуровневую систему «Привилегии» (Изумруд, Сапфир, Рубин, Бриллиант), Т-Банк расширил программы страхования и компенсации такси для премиум-клиентов, Газпромбанк переименовал Private Banking в «Статус». Банк России сохранил ключевую ставку на уровне 14%, зафиксировав ускорение инфляции до 5–6% годовых. Sber Private Banking выступил партнёром ярмарки современного искусства Cosmoscow, демонстрируя тренд на расширение сервисов для HNWI за пределы финансов. Барьеры переключения между банками снижаются, поэтому конкурентное преимущество всё больше зависит от качества advisory, налогового планирования и lifestyle-сервисов.
Выводы автора:
- Технические барьеры удержания капитала снижаются, поэтому ценность реального качества сервиса и финансовых условий растёт.
- Цифровые активы становятся частью wealth-management agenda банков, требуя интеграции в общую систему управления капиталом клиента с учётом суитабилити, налогов и наследования.
- Premium-сегмент переходит к экономической, а не только эмоциональной дифференциации: новые уровни должны давать понятные финансовые преимущества, а не только красивые названия.
Для состоятельного клиента бесшовность новой инфраструктуры быстро станет гигиеническим фактором — она просто должна работать.
Платёж как точка входа: как меняется архитектура финансовых сервисов
Финтех и финансы · Б.О: Технологии · 8/10
Материал посвящен тому, как платежные системы трансформируются из технической функции в стратегический актив, определяющий бизнес-модель финансовых и нефинансовых компаний. Автор прослеживает историю: монета Алиатта (VI век до н.э.) создала стандарт и ускорила торговлю, платёжная карта Diners Club (1950 г.) изменила поведение потребителей и интегрировала банк в повседневность, а сегодня платёж становится конструктором сценариев — QR-код, биометрия, цифровой рубль, Pay-сервисы, BaaS конкурируют за контроль над цепочкой обработки платежа, маршрутизацией, данными и клиентским опытом. Ключевая идея: вопрос смещается с «Карта или наличные?» на «Кто управляет архитектурой платёжного процесса?». Эквайринг превращается из услуги приёма платежей в точку входа для кредитования МСП; нефинансовый бизнес через BaaS хочет зарабатывать на платежах без лицензии; границы между банком, ретейлером и финтехом стираются. Статья основана на анализе примеров банка ПСБ, финтех-группы СВОЙ и трансформации эквайринга на российском рынке.
Выводы автора:
- Платёж из технического элемента превратился в поле стратегической конкуренции, где побеждает тот, кто контролирует всю цепочку обработки, маршрутизацию, данные и клиентский опыт.
- Эквайринг и платёжные системы становятся точками входа для дополнительных финансовых услуг: кредитования, лояльности, персонализированных сценариев взаимодействия с клиентом.
- Стирание границ между банками, ретейлерами и финтехом через модель BaaS позволяет нефинансовому бизнесу монетизировать платежи, переопределяя роли всех участников рынка.
Платёж перестал быть скучной технической функцией и превратился в поле стратегической битвы.
Оригиналы:Пересборка: платежи как вход в экономику данных и лояльности
Как выбирать корпоративные облигации: полное руководство
Финтех и финансы · СберБанк · 7/10
Материал объясняет систематический подход к выбору корпоративных облигаций, отличающихся от государственных ОФЗ более высоким риском, но и большей потенциальной доходностью. Ключевой ошибка начинающих инвесторов — смотреть только на размер купона; нужно начинать с проверки кредитного рейтинга эмитента (ААА — ВВВ считаются инвестиционными, ниже — спекулятивные). Обязательно оценивать финансовое состояние компании через отношение чистого долга к EBITDA (для частных компаний комфортным считается до 2–2,5, выше 3 — высокая нагрузка), динамику выручки и прибыли, коэффициент покрытия процентов (оптимально ≥ 3–4). При выборе срока учитывайте наличие оферт: put-оферта защищает инвестора (право вернуть бумагу), call-оферта защищает эмитента (может досрочно погасить облигацию). Только после этого анализа смотрите на доходность к погашению (YTM), которая учитывает купоны, цену покупки и номинал. Помните: повышенная доходность — премия за риск; для голубых фишек нормальная премия 1–2%, для качественного второго эшелона 2–4%, свыше 5% указывает на спекуляцию. Высокодоходные облигации (ВДО) часто имеют низкую ликвидность и относятся к предбанкротным компаниям.


Выводы автора:
- Начните анализ облигаций с проверки кредитного рейтинга эмитента и его финансового состояния, а не с размера купона.
- Оценивайте потенциальную доходность через YTM (доходность к погашению), а не через размер купона, так как она учитывает все факторы: цену покупки, купоны и номинал.
- Помните, что повышенная доходность — это премия за риск; норма для надёжных компаний составляет 1–4%, а свыше 5% сигнализирует о спекулятивности инструмента.
Чем менее надёжна бумага, тем более высоким может быть потенциальный доход. Доходность и риск в инвестициях всегда взаимосвязаны.
Гипотеза эффективного рынка: можно ли заработать на трейдинге
Финтех и финансы · СберБанк · 7/10
Материал разбирает гипотезу эффективного рынка (EMH) и её влияние на стратегии трейдинга и инвестирования. Согласно EMH, цены финансовых активов отражают всю доступную информацию, поэтому систематически обыгрывать рынок крайне сложно. Статья выделяет три формы эффективности: слабую (цены отражают историю торгов), полусильную (отражают публичную информацию) и сильную (включают инсайд). Технический анализ и краткосрочный трейдинг после учёта комиссий и спредов редко приносят регулярную прибыль. Фундаментальный анализ может работать только при наличии глубокой экспертизы и на длинных горизонтах. Пассивные стратегии часто превосходят активный трейдинг за счёт низких издержек. Однако EMH имеет ограничения: поведенческие факторы, рыночные аномалии (эффект стоимости, импульса), сезонные эффекты и реальные ограничения арбитража создают возможности для спекулянтов. Для частного инвестора EMH — аргумент в пользу реалистичных ожиданий, диверсификации и пассивного подхода.
Выводы автора:
- При полусильной и сильной формах эффективности активный трейдинг имеет смысл только при наличии реального технологического или информационного преимущества
- Пассивные инвестиционные стратегии с высокой вероятностью превосходят активный трейдинг на долгосрочном горизонте благодаря низким издержкам
- Рыночные аномалии и поведенческие факторы создают окна для спекулянтов, но они работают не всегда и сопровождаются реальными ограничениями на реализацию сделок
Активный трейдинг имеет смысл только если вы обнаружили устойчивую неэффективность, имеете реальное технологическое или информационное преимущество или готовы принять высокие риски.
Газпромбанк упростил программу лояльности: стабильность вместо сложных правил
Финтех и финансы · Б.О: Банки · 7/10
Газпромбанк запустил в ноябре 2025 года полностью переработанную программу лояльности, отказавшись от сложных правил в пользу простоты и предсказуемости. Клиенты устали разбираться в множественных условиях кешбэка, разных лимитах и привязке программы к карте — банк услышал эту критику и переделал механику. Новая программа работает на уровне клиента, а не карты, условия едины для всех (различия только по уровню взаимодействия с банком), клиент сам выбирает категории кешбэка и может конвертировать баллы в рубли начиная с 500. За девять месяцев база клиентов, получающих кешбэк, выросла на 35%, средняя сумма кешбэка на клиента в первом полугодии 2026 года увеличилась на 75% относительно аналогичного периода 2025 года. Банк оптимизировал собственные расходы на программу в 1,3 раза без снижения привлекательности. Персонализация строится на анализе более 21 поведенческих моделей и транзакционной активности клиентов, каждому предлагаются релевантные категории кешбэка с готовой оптимальной корзиной. Газпромбанк активно развивает партнерские программы, тщательно проверяя каждого потенциального партнера, и планирует дальнейшее расширение функционала за счет персональных предложений.
Выводы автора:
- Клиенты ценят простоту и предсказуемость больше, чем сложные условия с максимальной выгодой на бумаге; правильно выстроенная механика выгодна и банку, и клиентам
Клиенты хотят стабильности и предсказуемости. Клиенты устали разбираться в сложных правилах, искать мелкий шрифт и пытаться понять, почему сегодня кешбэк пришел, а завтра нет.
Реальные истории IT-найма 2026: парадоксы рынка и проблемы процессов
Продукт и карьера · Habr · 9/10
Материал раскрывает разрыв между статистикой IT-рынка и реальностью найма в 2026 году через конкретные истории кандидатов и специалистов. Автор предыдущих аналитических статей провел исследование 106 тысяч вакансий, но решил дополнить цифры живыми историями, которые показали, что между данными и практикой «целая пропасть». История дата-инженера Алексея демонстрирует проблемы процесса найма в Т-Банке: вместо проверки практических навыков проводится экзамен по отдельным задачам с нечёткими условиями, а обратная связь требует решения задач, противоречащих best practices (например, Т-Банк критикует использование CTE, хотя это стандарт читаемого кода). История системного аналитика Дмитрия показывает абсурдность процесса в крупных компаниях: он пять раз прошел положительные собеседования в разные команды Т-Банка только чтобы услышать «мы взяли внутреннего кандидата», при этом оказался нужен другой работодатель, где процесс был проще и оффер выше. История IT-рекрутера Елены с 4 годами опыта раскрывает парадокс: по статистике HR — самая востребованная вакансия на рынке, но сама Елена не может найти нормальную работу, встречая только предложения аутстаффа с грабительскими схемами или крайне низкие оклады.
Выводы автора:
- Процессы найма в крупных компаниях часто проверяют способность проходить экзамены, а не реальные практические навыки и системное мышление специалиста
- Внутренние кандидаты по ротации предпочитаются внешним даже при положительных результатах собеседований, что приводит к трате времени обеих сторон
- Статистика вакансий не отражает реальную ситуацию: спрос на HR-специалистов велик в цифрах, но на практике предлагаются только аутстафф-схемы с минимальными ставками
Я продаю не умение писать однострочные SQL-запросы — это уже умеет ИИ. Мой опыт позволяет критически мыслить и учитывать всё это на горизонте от 3–6 месяцев. На вашем интервью проверяли экзамены.
Оригиналы:Реальные истории IT-найма 2026 · Исследования и прогнозы в IT
64 креативные тактики роста: от вирусных стантов до стратегических запусков
Продукт и карьера · Lenny's Newsletter · 8/10
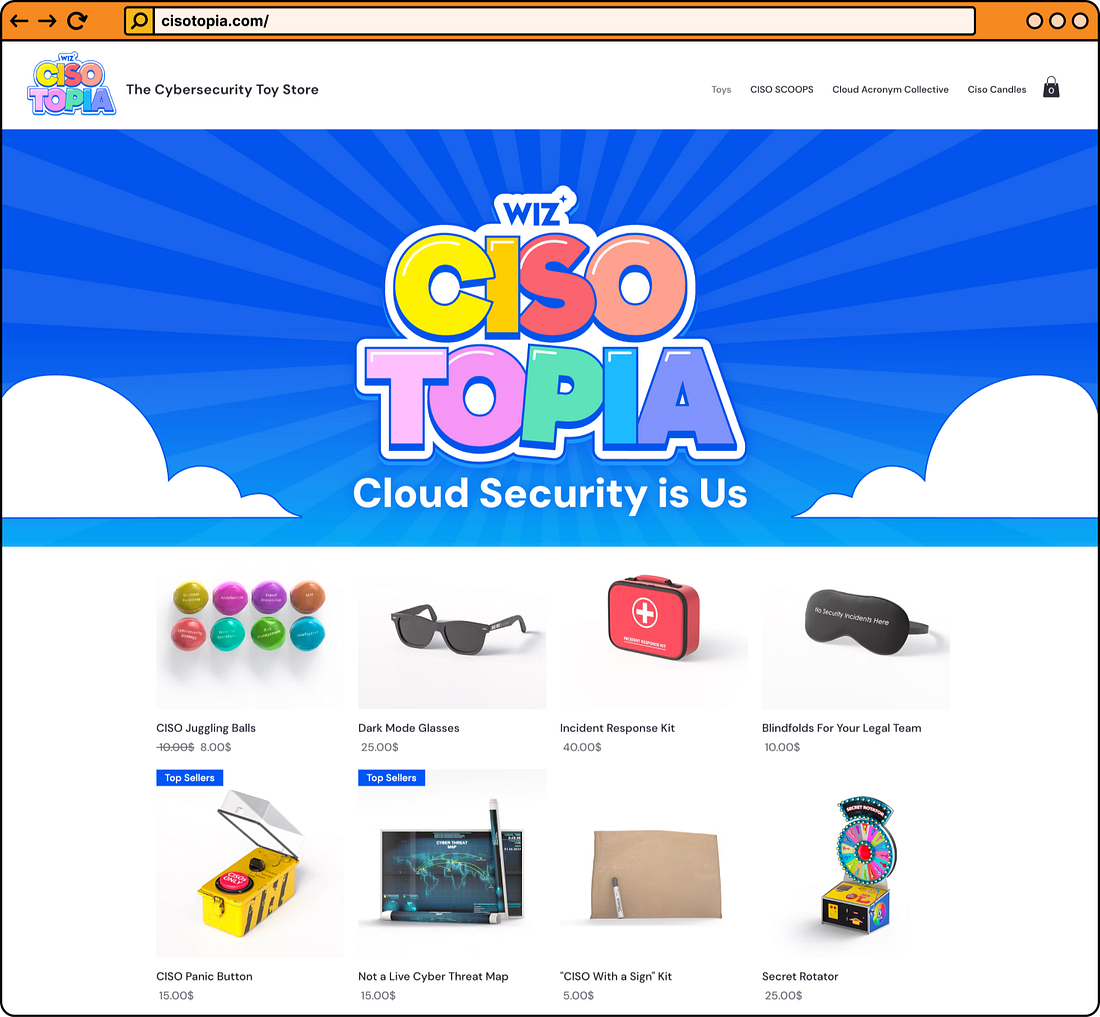
Том Орбах, маркетолог из Wiz (теперь часть Google Cloud) с 100 000 подписчиков в рассылке, собрал за четыре года коллекцию из 64 нестандартных идей для роста продукта, проверенных реальными стартапами. Материал организован по целям: генерация buzz без платной рекламы, шум при запуске, вирусное распространение, лиды и конверсии, конкурентные преимущества, увеличение цен и retention. Ключевой принцип: внимание привлекает неожиданное, которое люди делят бесплатно и помнят месяцами. Примеры включают поддельный магазин игрушек для CISO, который принёс 46 000 посетителей за 24 часа и сотни квалифицированных лидов; мемы-аккаунты (1up получает треть лидов из мемов); anti-AI позиционирование (Procreate CEO получил 10 млн просмотров); фиктивных персонажей (Trevor From Torq); инклюзивные амбассадорские программы и вирусные LinkedIn посты. Автор подчёркивает, что большинство идей выполнены один раз в одной нише, поэтому есть большое окно для того, чтобы их использовать до насыщения. Материал можно загрузить в Markdown-формате и скормить ИИ-агенту для мозговой атаки под свой продукт.
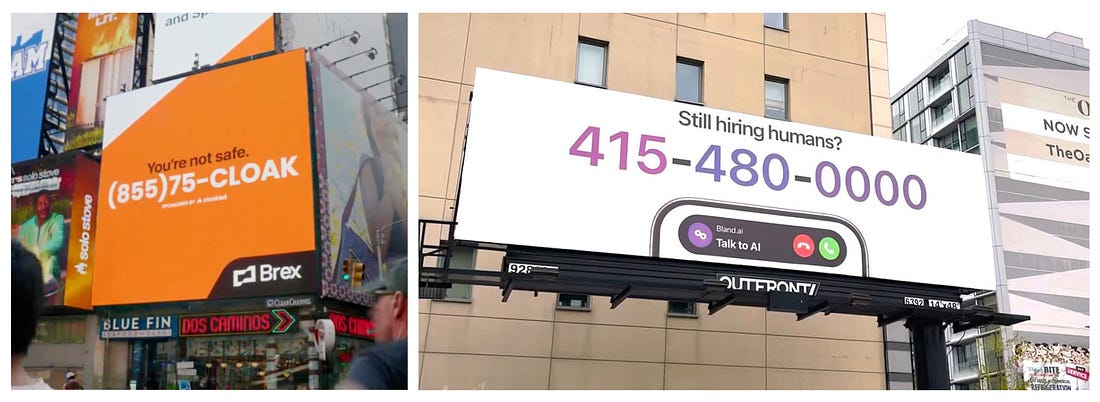
Выводы автора:
- Неожиданное и контрастное всегда работает лучше, чем стандартный playbook: забудьте о видео высокого качества и платных инфлюенсерах, инвестируйте в то, что удивит аудиторию и заставит её делиться органически.
- Каждая успешная тактика была применена ровно один раз в одной нише, поэтому у вас есть окно возможности использовать эти идеи до их переиспользования.
- Комбинируйте маленькие тактики как лотерейные билеты — большинство не сработают, но одна может привести к экспоненциальному росту.
Внимание всегда идёт к тому, чего люди не видели. Неожиданное делится бесплатно, его помнят месяцами и обычно оно стоит меньше, чем одна неделя рекламного бюджета.
Оригиналы:Tom Orbach – подписка на рассылку Marketing Ideas · Полная рассылка Marketing Ideas
Совет директоров уволил основателя WordPress — он вернулся через 48 часов
Продукт и карьера · Habr · 7/10
Совет директоров компании Automattic (владельца WordPress.com, Tumblr и WooCommerce) отстранил основателя Мэтта Малленвега от должности гендиректора в среду 9 сентября, отправив его на оплачиваемый отпуск. Решение принято с перевесом голосов (трое из четырёх директоров голосовали за отстранение, сам Малленвег — против), при этом ему дали всего 50 минут на ознакомление с резолюцией без возможности консультации с юристом. Однако основатель не признал решение совета: он выгнал других администраторов из корпоративного чата и объявил сотрудникам о своём возвращении. Через пару дней Automattic официально подтвердила, что Малленвег вновь является председателем совета и гендиректором с поддержкой самого совета. Причина конфликта кроется в структуре власти в компании: совет директоров может снять гендиректора голосованием, но акционеры определяют состав самого совета, и контрольный пакет акций у Малленвега. Это позволило ему переизбрать совет в свою пользу, и вскоре последовали сообщения об уходе одного из директоров и изменении состава совета.
Выводы автора:
- Контроль над пакетом акций позволил основателю переломить ситуацию, так как именно акционеры определяют состав совета директоров, а не наоборот
- Попытка совета отстранить основателя потерпела крах, вероятно, из-за неправильной оценки собственного влияния или расчёта на поддержку, которой не получилось
Теперь я пират
Оригиналы:Совет директоров уволил основателя WordPress — через 48 часов он вернулся
Советские компьютеры для обучения: «Микроша», «Агат» и ДВК
Прочее · Habr · 7/10
Статья рассказывает о трёх легендарных советских персональных компьютерах начала-середины 80-х годов, которые использовались в школах и вузах для обучения программированию. «Микроша» (1986) — лёгкая портативная машина весом 3 кг на базе КР580ВМ80А (клон Intel 8080) с частотой 1,77 МГц, 32 Кб ОЗУ и 2 Кб ПЗУ, монохромным дисплеем 64×25 символов и программами через магнитные кассеты; стоил 500 рублей и завоевал школы благодаря рекламе в журнале «Радио». «Агат» (1984) — мощный компьютер на базе процессора MOS Technology 6502 (1 МГц), архитектурно вдохновлённый Apple II Plus, с оперативной памятью от 64 до 640 Кб, поддерживавший различные графические режимы и комплектовавшийся пакетом «Школьница» с языками программирования Рапира и Робик; стоил 3900 рублей и работал даже в начале 2000-х. ДВК (1983) — шестнадцатиразрядный диалоговый вычислительный комплекс на базе архитектуры DEC PDP-11, разработанный в Зеленограде, с процессором К1801ВМ1 (5 МГц), 48 Кб ОЗУ, дисководами и зелёным матричным дисплеем; выпущено около 200 тысяч экземпляров до 1993 года, применялся в школах, университетах и даже на флоте для противолодочных операций.
Выводы автора:
- Советские школьные компьютеры 1980-х («Микроша», «Агат», ДВК) были значительно менее мощными, чем западные аналоги (Apple II, BBC Micro), но успешно использовались для обучения программированию благодаря встроенному русскоязычному софту и доступности в образовательных учреждениях.
- Каждая из трёх машин имела свою нишу: «Микроша» была портативным школьным инструментом, «Агат» предоставлял лучшие технические возможности с долгоживучестью, ДВК стал наиболее массово производимым (200 тысяч экземпляров) и универсальным для различных отраслей.
«Микроша» — это портманто из слов «микрокомпьютер» и «школа», и он действительно оправдывал свой уменьшительно-ласкательный ник весом всего лишь 3 килограмма.
Оригиналы:«Агат», «ДВК», «Микроша»: на чём советские гики учились программировать? Часть 1
Коротко
ИИ и агенты
- Anthropic готовится к IPO: какие акции выиграют от листинга – Anthropic выбрала Nasdaq для IPO, которое может оценить компанию в $2 триллиона, сообщила Financial Times.
Финтех и финансы
- ПИК одобрил делистинг акций на собрании 13 октября – Совет директоров ПИКа одобрил прекращение публичного статуса компании и вывод акций с торгов.
- СберБанк снизил прогнозы по недвижимости и целевые цены девелоперов – СберБанк обновил прогнозы по российскому рынку недвижимости и переоценил акции крупных девелоперов по результатам первого полугодия 2026 года.
- Fix Price: положительная ревизия прогнозов на основе результатов первого полугодия 2026 – Аналитический материал СберБанка разбирает финансовые результаты сетки Fix Price за первое полугодие 2026 года и пересмотр инвестиционных прогнозов.
- ТМК: восстановление спроса на фоне исторических минимумов – Аналитический материал СберБанка о финансовом состоянии ТМК (Трубная металлургическая компания) в первом полугодии 2026 года.
- Sollers: замедление продаж в августе несмотря на низкую базу – Материал содержит аналитический обзор динамики продаж российского автопроизводителя Sollers в августе 2025 года.
- Промомед: рост выручки на 76% благодаря препаратам GLP-1 – СберБанк опубликовал обновленный анализ компании Промомед после её финансовых результатов за первое полугодие 2026 года.
- Совкомбанк: размещение акций среди институциональных инвесторов – Совкомбанк объявил о размещении пакета своих акций в формате ускоренного букбилдинга.
Экономика
- РУСАЛ изучает возможность строительства завода по производству глинозёма в Индонезии – РУСАЛ ведёт работы над проектом строительства боксито-глинозёмного комплекса в Индонезии.