Дайджест за 10 сентября 2026
Яндекс Еда поделилась опытом огромной оптимизации PHP-монолита, сэкономив тысячи ядер, а инженеры разбирают восемь алгоритмов балансировки нагрузки, которые лежат в основе масштабируемых систем. В мире ИИ разгорелась настоящая драма — OpenAI и Anthropic обвиняют друг друга в присвоении решения классической задачи Навье-Стокса, на фоне чего сообщество обсуждает архитектуру современных ИИ-агентов и экспериментирует с запуском гигантских моделей на скромном железе.
Главное
- Как сэкономить 1000+ ядер: оптимизация PHP-монолита Яндекс Еды
- Как балансировщики нагрузки распределяют трафик: 8 алгоритмов
- Четыре тренда платежных технологий: автоматизация, API-интеграция и сетевые платформы
- Скандал OpenAI: обвинения в присвоении решения задачи Навье-Стокса
- «Арканутый C++»: как экстремальная оптимизация меняет язык
Подробно
Скандал OpenAI: обвинения в присвоении решения задачи Навье-Стокса
ИИ и агенты · Habr · 8/10
Разгорелся скандал вокруг решения знаменитой задачи тысячелетия Навье-Стокса (за решение которой полагается $1 млн и вечная слава). Математики Тристан Бакмастер и Левент Альпёге (из Anthropic) год работали над доказательством с использованием ChatGPT через Codex и Claude. После слухов о их работе OpenAI якобы быстро обучила свою новую модель Astra решать Навье-Стокса, используя подозрительно схожий подход. Бакмастер обвинил компанию в корпоративном шпионаже: модель могла получить доступ к их сессиям Codex через тренировочный датасет. OpenAI впоследствии признала, что анонимизированные данные логов могли попасть в датасет, но отрицает прямое подсмотривание и утверждает, что решила задачу независимо, используя рой из 10 тыс. агентов и 130 млрд токенов. Основной вопрос: этично ли использовать данные пользовательских сессий для обучения внутренних моделей без явного согласия и прозрачности?
Выводы автора:
- OpenAI решила задачу Навье-Стокса, но обвинена в том, что использовала результаты работы математиков через данные их Codex-сессий
- Ключевой этический вопрос: могут ли компании-разработчики AI использовать пользовательские данные для обучения своих моделей без прямого согласия
- История демонстрирует проблему информационной асимметрии при использовании внешних AI-сервисов для разработки
Если вы разрабатываете что-то новаторское и активно используете ChatGPT — Сэм Альтман может в любой момент скормить ваши наработки своей внутренней нейросети
Оригиналы:Нейронный Навье-Стоксгейт: скандал с OpenAI · Математика
Архитектура современных ИИ-агентов: от теории к прототипу
ИИ и агенты · Habr · 8/10
Статья разбирает архитектуру ИИ-агентов на примере OpenClaw и Hermes, объясняя, почему технология раньше не взлетела, а теперь стала жизнеспособной. Автор развеивает миф об агентах как потребительском продукте, указывая на то, что реальная революция — это инженерная обвязка, позволяющая соединить нейросеть с реальным миром. Ключевой момент: в 2023 году AutoGPT провалился из-за слабых моделей (GPT-4 теряла контекст в длинных цепочках). Зимой 2026-го качественный сдвиг произошел благодаря моделям Claude 4.5, GPT-5.1 и DeepSeek V3.2, которые научились справляться с длинными цепочками действий. Однако узкое место переместилось: теперь ограничения — это интеграции, права доступа и стоимость инфраструктуры. В основе любого агента лежит цикл из триггера, компоновки запроса с контекстом и описанием инструментов, ответа ИИ в JSON и вызова нужных функций. Базовый цикл занимает сто строк кода, остальной объём (почти три миллиона в OpenClaw) — это обвязка: интеграции, обработка ошибок, авторизация. OpenClaw и Hermes отличаются архитектурой: первый — централизованный пульт управления с расширениями, второй — фокус на накопление опыта и память. Главный риск — Prompt Injection атаки через внешние данные, поэтому агенты нельзя запускать с доступом к конфиденциалам. Статья завершается разбором создания собственного ИИ-агента с использованием промтов.
Выводы автора:
- Ценность ИИ-агентов не в потребительском продукте, а в инженерной обвязке, которая позволяет соединить модель с реальным миром и автоматизировать сложные сценарии.
- Технология стала жизнеспособной только благодаря качественному скачку в возможностях моделей (Claude 4.5, GPT-5.1, DeepSeek V3.2), которые научились удерживать длинные цепочки действий.
- Описание инструментов в текстовом формате — это одновременно программирование: модель сама решает, какой инструмент использовать, но человек может влиять на качество выбора через подсказки в описании.
Революция произошла, но не там, где её привыкли искать. Революция в том, что появился новый способ соединить нейросеть с реальным миром.
Оригиналы:Архитектура современных ИИ-агентов: собираем прототип за один вечер
Робот-секретарь для банка: от идеи к MVP
ИИ и агенты · Habr · 8/10
Инженер Тимур Баян описывает разработку системы автоматической обработки конференций в банке: запись встреч, их транскрибация и анализ через LLM для составления итогов. Начав с простой гипотезы (OBS + Yandex SpeechKit + локальная YandexGPT), автор создал полноценный пайплайн в закрытом контуре банка. Самой сложной частью оказалось подключение к конференц-системе через WebRTC: месяц работы на Python потребовал переписи на Go, которая заработала за 4 часа. Для транскрибации выбран Whisper (whisper.cpp с GPU поддержкой), обработка часовой конференции сократилась с 1:1 до 4:1 благодаря GeForce GTX 1080. Сопоставление говорящих потребовало эвристик из-за задержек в логах конференц-сервера. Система состоит из нескольких компонентов: recorder (Go), транскрибер (Docker с whisper.cpp), LLM-агент (YandexGPT-5-Lite), Telegram-бот для заказов и оркестратор на Go с Postgres. Пилот прошёл на 20 человеках с записью 3-5 встреч в день. Выявлены артефакты Whisper (упоминание DimaTorzok из-за субтитров YouTube) и нестабильность LLM при анализе.
Выводы автора:
- Переписать решение с неработающего Python на Go позволило достичь работоспособности в сотни раз быстрее благодаря лучшей поддержке WebRTC
- Использование GPU (whisper.cpp вместо стандартного Whisper) ускорило транскрибацию в 4 раза — с соотношения 1:1 до 4:1
- Полностью офлайновая архитектура в закрытом контуре банка достижима через комбинацию Go, Docker, локальных LLM и open-source инструментов
Я месяц возился с python, чтоб заставить aiortc записывать конференцию, а здесь версия на Go заработала спустя всего 4 часа, буквально с первого раза!
Оригиналы:Никто не просил — а я сделал банку робота-секретаря
Запуск модели Qwen3.8-Flash-Next 125B на 6 ГБ видеопамяти
ИИ и агенты · Habr · 8/10
Статья описывает практический способ запуска полноразмерной открытой модели Qwen3.8-Flash-Next (125B параметров) на видеокарте с всего 6 ГБ VRAM, используя инструмент AirLLM и технику layer-wise inference. Модель включает 125B MoE-архитектуру, 51B n-gram embedding table, встроенную обработку видео, окно контекста 262K токенов и по результатам автора конкурирует с закрытыми frontier-моделями в программировании и работе с агентами. Основная инженерная хитрость: n-gram таблица размером ~102 ГБ хранится на диске через memory mapping и обрабатывается на CPU, decoder layers стримятся последовательно, требуя одновременно в видеопамяти только текущий слой, видеовход и активации. Пиковое потребление VRAM составило 5,95 ГБ без квантизации; модель работает offline. Для запуска требуется видеокарта с 8 ГБ VRAM, 64 ГБ оперативной памяти, несколько сотен гигабайт на диске и установка AirLLM>=3.3.0 с актуальной версией transformers. Код интеграции максимально простой: стандартный AutoModel.from_pretrained(). Это показывает, что качество open-weight моделей опережает требуемое аппаратное обеспечение, и локальный запуск больших моделей становится доступнее.
Выводы автора:
- Полнофункциональную 125B модель с vision можно запускать на 8 ГБ видеопамяти через комбинацию layer-wise inference и memory mapping больших эмбеддинг таблиц на диск
- AirLLM автоматически оптимизирует загрузку архитектуры без ручного написания custom code, оставляя простой стандартный интерфейс
- Узкое место для локального запуска сместилось с видеопамяти на хранилище (несколько сотен ГБ SSD) и оперативную память (64 ГБ)
Требования к GPU действительно становятся заметно ниже. Для такого запуска достаточно видеокарты с 8 ГБ VRAM, 64 ГБ RAM и диска с несколькими сотнями гигабайт свободного места.
Оригиналы:Как запустить Qwen3.8-Flash-Next 125B на 6 ГБ VRAM · Open source
OpenAI и Anthropic в конфликте вокруг доказательства уравнения Навье-Стокса
ИИ и агенты · Habr · 8/10
История о возможном прорыве в одной из семи задач тысячелетия превратилась в спор об авторстве между независимыми математиками и крупными компаниями. Тристан Бакмастер из NYU и Левент Алпеге из Anthropic получили результаты по образованию сингулярностей в уравнениях гидродинамики, работая на собственные деньги в личное время. Их работа привлекла внимание Теренса Тао, назвавшего её интересной и близкой к решению проблемы Навье-Стокса. Однако вскоре OpenAI заявила, что её внутренняя модель якобы уже доказала существование решения, используя похожий подход. Бакмастер усомнился в совпадении и поднял вопрос о возможной утечке его материалов, загруженных в Codex. OpenAI предложила варианты публикации, при которых Алпеге был бы исключён, что математик воспринял как попытку убрать конкурирующую Anthropic из истории открытия. После конфликта Бакмастер и Алпеге поспешили опубликовать свои текущие результаты, не дожидаясь финальной формализации. OpenAI впоследствии подтвердила наличие решения, полученного многоагентной системой из ~10 тысяч агентов, и заявила, что использованная модель значительно превосходит GPT-6 Astra, однако научное сообщество требует независимой проверки.
Выводы автора:
- Конфликт показывает растущую роль ИИ-систем в фундаментальной математике, но также выявляет вопросы о прозрачности и авторстве результатов, полученных с помощью нейросетей
- OpenAI использовала многоагентные системы для решения задачи, что указывает на новый подход к применению ИИ в научных исследованиях
- Независимая проверка результата научным сообществом остаётся критически важной, несмотря на формализацию в Lean
Возможный один из крупнейших результатов в истории ИИ-математики сначала превратился в спор о том, кто первым пришел к правильной идее и кому достанется авторство.
Оригиналы:Полный разбор конфликта на Habr
Meta Muse: ставка на доверие в гонке ИИ-агентов против Grok и Gemini
ИИ и агенты · Linas from Linas's Newsletter · 8/10
Meta запустила Muse — первого массового ИИ-агента с бесплатным уровнем и защитой покупателей третьих сторон. Это произошло всего через 13 дней после того, как компания согласилась выплатить до 18 млрд долларов для урегулирования исков о том, что Instagram и Facebook были созданы для привлечения детей. Meta столкнулась с серьёзным дефицитом доверия, что заставило компанию реализовать самый полный дизайн безопасности потребителя из всех когда-либо выпущенных агентов — и именно этот дизайн, а не качество модели, является основным продуктом. Muse, Grok Bot и ChatGPT теперь используют один и тот же кошелек агента (в основном powered by Stripe), что означает, что конкуренция переместилась на экран одобрения. Магазины Shopify мгновенно стали инвентарём для агентов без каких-либо дополнительных действий. Материал рассматривает, почему гонку ИИ-агентов выиграет не модель, а доверие, и какие два ключевых показателя Meta не публикует, которые определат судьбу Muse.
Выводы автора:
- Гонку ИИ-агентов выиграет не качество модели, а доверие потребителей — Meta был вынужден реализовать самый полный дизайн безопасности потребителя из-за проблем с репутацией.
- Muse, Grok Bot и ChatGPT конкурируют на экране одобрения платежей, используя одну и ту же инфраструктуру Stripe, что делает доступность ключевым фактором.
Дизайн, а не модель, является всем продуктом.
Оригиналы:Meta Muse и гонка ИИ-агентов · Полное руководство по Grok Bot · Стратегия Anthropic для победы в коммерции агентов
Умная маршрутизация моделей: как снизить затраты на LLM в 10 раз
ИИ и агенты · ByteByteGo · 8/10
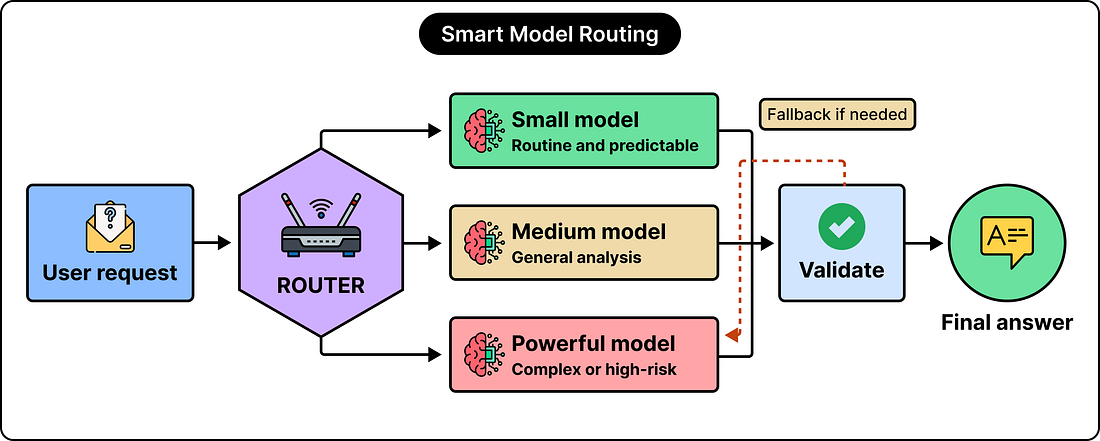
Материал раскрывает стратегию оптимизации расходов на LLM-приложения через умную маршрутизацию запросов к разным моделям. Проблема в том, что компании часто отправляют все запросы самой мощной (и дорогой) модели, даже когда задача простая. Маршрутизация перенаправляет сложные запросы к мощным моделям, а простые – к дешёвым и компактным, что позволяет сократить общие затраты примерно в 10 раз при сохранении качества ответов. В статье рассмотрены ключевые аспекты: почему LLM-приложения дорогеют, как работает маршрутизация, способы её реализации (маршрутизатор на базе маленькой модели, каскадный подход, семантическая и обучаемая маршрутизация). Затраты зависят от типов запросов, разницы в ценах между моделями и эффективности самой системы маршрутизации.
Выводы автора:
- Умная маршрутизация позволяет использовать дешёвые модели для простых задач и дорогие – только для сложных, снижая общие затраты на 10x без потери качества.
- Традиционный подход, когда все запросы идут в самую мощную модель, приводит к неэффективному использованию ресурсов и пустой траты денег на тривиальные операции.
- Эффективность маршрутизации критически зависит от распределения запросов, разницы в стоимости моделей и точности системы для определения сложности задачи.
Маленькое слово может быть одним токеном, но более длинное слово можно разбить на несколько токенов, а затраты обычно рассчитываются на основе обработанных токенов.
Как OpenAI строит Codex: интервью с разработчиком Tibo Sottiaux
ИИ и агенты · The Pragmatic Engineer · 8/10
Подкаст The Pragmatic Engineer с Tibo Sottiaux, одним из создателей Codex, раскрывает ключевые решения при построении инструмента для автоматизации разработки. Codex написан на Rust, несмотря на то что модели лучше работают с Python и TypeScript, чтобы обеспечить производительность и масштабируемость на миллионах машин. Инструмент выпущен как open source, что позволяет поддерживать модели от разных провайдеров и выигрывать через конкуренцию, хотя открытость означает, что решения иногда копируют раньше, чем Codex их выпустит. Codex использует архитектуру с harness (обвязка модели) — системой guardrails, safety-механизмов и эффективности, которая по мере улучшения моделей постепенно упрощается. В OpenAI инструмент встроен в Slack, документы и весь код, позволяя разработчикам запрашивать Codex о чём угодно. Аварийное закрытие проекта в Google научило Sottiaux ценить product-market fit и вовлечённость пользователей — урок, который стал ключевым в его карьере. С помощью AI агентов обслуживание и переархитектура кода становятся дешевле и быстрее, хотя качество абстракций и тестов остаются критичны. Разработка переходит от длительных сессий в потоке к быстрому сбору данных через агентов для принятия решений.


Выводы автора:
- Выбор Rust для Codex был обоснован целью масштабируемости на миллионы облачных машин, хотя требовал обучения моделей писать на менее знакомом языке.
- Open source подход позволяет Codex поддерживать модели от разных провайдеров и конкурировать качеством, но приводит к копированию идей конкурентами.
- AI агенты снижают стоимость обслуживания кода и переархитектуры систем, меняя рабочий процесс разработчиков с длительных сессий на быстрый сбор данных.
В OpenAI Codex подключён к Slack, каждому документу и коду — новичкам кажется удивительно, что они могут спросить его всё, даже кто работает над чем-то или почему было принято решение.
Оригиналы:Building Codex with Tibo Sottiaux
Налог на ИИ как стратегическая ошибка: альтернативные механизмы регулирования
ИИ и агенты · Б.О: Технологии · 8/10
Статья разбирает предложение Билла Гейтса ввести налог на ИИ и роботов как способ смягчить социальные последствия автоматизации. Автор Тимур Аитов, председатель комиссии по безопасности финансового рынка Совета ТПП РФ, доказывает, что такой налог будет неэффективен и контрпродуктивен: он создаст искусственное преимущество компаниям, не внедряющим ИИ, но в итоге проиграет международной конкуренции, когда на рынок придут китайские и американские игроки. Вместо наказания за технологию Аитов предлагает три альтернативных механизма: инвестиционный налоговый кредит (до 30% затрат на внедрение ИИ при условии двухлетнего сохранения штата и 10% инвестиций в переобучение), налог на сверхприбыль от автоматизации (25% вместо стандартных 20% при росте прибыли более чем на 20%), и сертификаты на переобучение (300 тыс. рублей на два года для уволенных из-за ИИ). Программа обойдется в 80 млрд рублей в год (0,07% федерального бюджета, или 1200 рублей на одного занятого), но может быть развёрнута уже в 2027–2032 годах. Аитов критикует идею «заповедников» для человеческого труда как консервирующую экономику в прошлом и подчеркивает, что Россия не может ждать мирового консенсуса — риск остаться на позиции догоняющей слишком велик. Новый Закон № 243-ФЗ о поддержке ИИ — рамочный, но требует наполнения реальным содержанием и решения проблем с агентным ИИ, кадрами, песочницами и ответственностью.
Выводы автора:
- Налог на ИИ контрпродуктивен: он замораживает конкурентоспособность отечественной отрасли перед международными игроками, а не решает проблему социальной адаптации
- Эффективнее использовать гибкие механизмы стимулирования (налоговые кредиты, налог на сверхприбыль, сертификаты на переобучение), которые распределяют плоды прогресса, не тормозя его
- Россия должна срочно действовать самостоятельно, не дожидаясь мирового консенсуса, иначе рискует потерять ИИ-отрасль и специалистов конкурентам
Это не налог на технологию ИИ, а налог на выгоду от неё — почувствуйте разницу. Государство получает долю от прогресса, но сам прогресс не тормозит.
Оригиналы:Налог на ИИ — стратегическая ошибка?
Как сэкономить 1000+ ядер: оптимизация PHP-монолита Яндекс Еды
Разработка и архитектура · Habr · 9/10
История о поиске и устранении неожиданного «пожирателя» CPU в PHP-монолите Яндекс Еды. Разработчик Миша заметил подозрительное совпадение: RPS в пиковые часы соответствовал количеству выделённых ядер, при этом реальная нагрузка была 100% одного ядра на 2,5 RPS — явно неэффективно. Профилирование с помощью Perforator выявило проблему: eBPF-программа для разворачивания стека PHP была слишком велика и не проходила верификацию ядра из-за ограничения в 1 млн инструкций проверки. Виновник — цикл размотки Python-стека, который анализировался верификатором 44-45 раз подряд, исчерпав лимит. Решение пришло при переделке счётчика цикла: вместо одной переменной используются две независимые, что позволило верификатору обойтись 774 тыс. шагов. Дополнительное косметическое улучшение — перемещение отладочного вывода, который случайно занимал регистр со счётчиком цикла и破坏ил инварианты. После устранения этих проблем стало возможно профилировать PHP и найти истинного потребителя ресурсов — связано это было с поддержкой OpenTelemetry.
Выводы автора:
- Профилирование с помощью eBPF — мощный инструмент, но требует понимания ограничений верификатора ядра, особенно в отношении циклов и состояний
- Небольшие изменения в структуре кода (независимые счётчики вместо зависимых) могут существенно упростить верификацию и снять ограничения на размер программы
- Отладочный вывод и макросы могут косвенно повлиять на распределение регистров и破坏ить инварианты, требуя аккуратного размещения в коде
100% загрузки одного ядра приходятся на 2,5 RPS — какое-то время я находился в состоянии глубокого изумления
Оригиналы:Как на ровном месте сэкономить 1000+ ядер, или Куда на самом деле уходили 80% CPU
Как балансировщики нагрузки распределяют трафик: 8 алгоритмов
Разработка и архитектура · Ashish Pratap Singh · 9/10
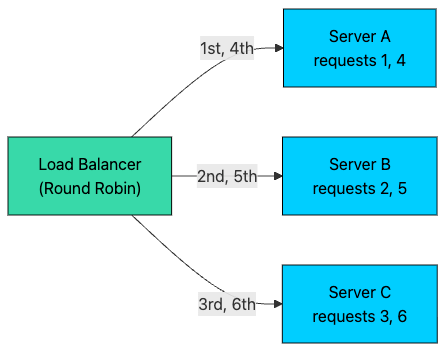
Статья разбирает 8 основных алгоритмов распределения трафика в балансировщиках нагрузки, которые используются в реальных системах и требуются знать для собеседований по системному дизайну. Round Robin отправляет запросы по кругу к одинаковым серверам, но не учитывает различия в их мощности.
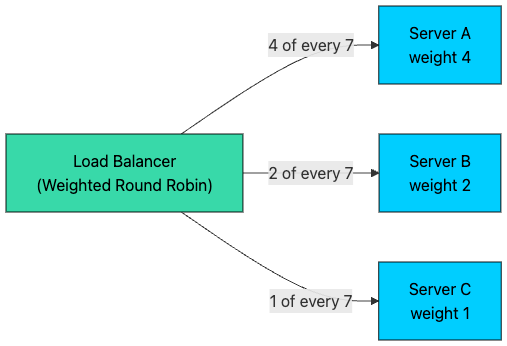
Weighted Round Robin добавляет веса серверам на основе их ёмкости, но игнорирует текущую нагруженность.
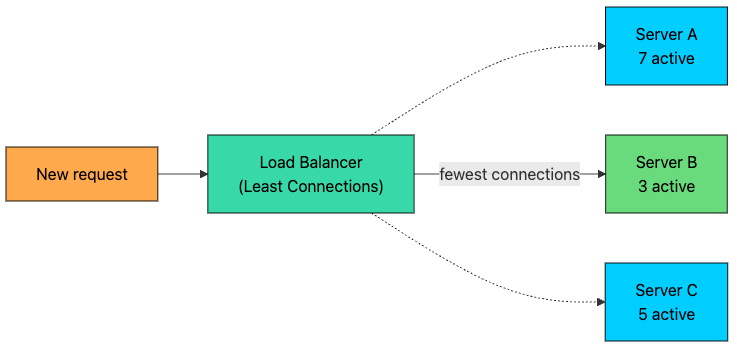
Least Connections отслеживает активные соединения и полезен для долгоживущих соединений (WebSockets, потоковая передача), но не учитывает ёмкость серверов.
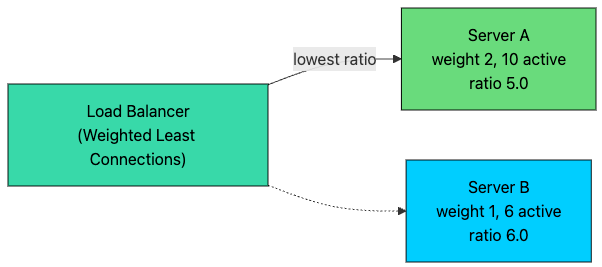
Weighted Least Connections комбинирует оба подхода через соотношение соединений к весу.
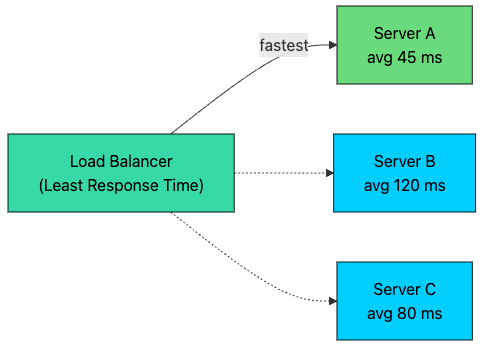
Least Response Time измеряет скорость ответа серверов и динамически адаптируется, но требует постоянного мониторинга.
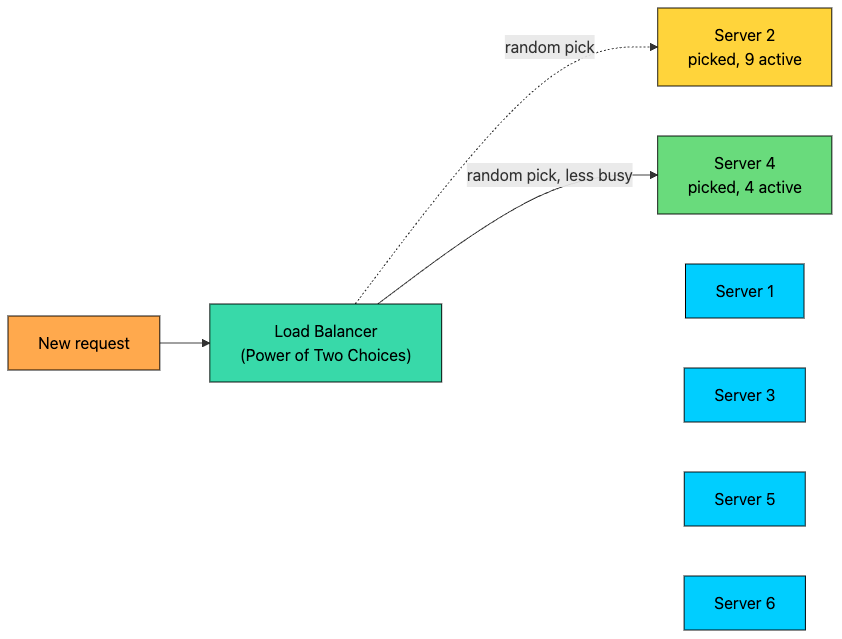
Power of Two Choices случайно выбирает два сервера и отправляет запрос менее нагруженному — эффективен при масштабировании на тысячи серверов.
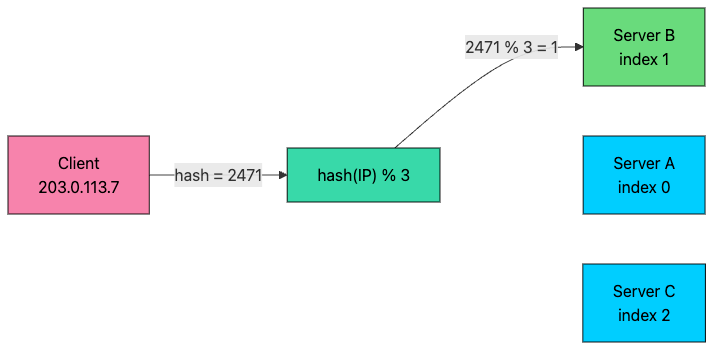
IP Hash использует хеш IP-адреса клиента для обеспечения sticky sessions, но при добавлении серверов переносит ~80% ключей.
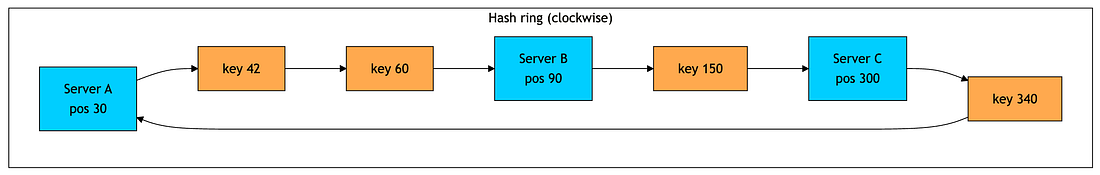
Consistent Hashing решает эту проблему через виртуальное кольцо, при изменении списка серверов переносит минимум ключей (~1/(N+1)) и применяется в распределённых кешах, DynamoDB, Cassandra и CDN.
Автор даёт рекомендации: начинать с Round Robin для коротких запросов, переходить на Least Connections для вариативной длины, использовать Power of Two Choices на большом масштабе, а Consistent Hashing выбирать только когда запросы должны идти на конкретный сервер.
Выводы автора:
- Выбор алгоритма балансировки зависит от характеристик нагрузки: длительности соединений, различий в ёмкости серверов и масштаба системы.
- Consistent Hashing минимизирует перераспределение ключей при изменении списка серверов благодаря виртуальным узлам, что критично для автомасштабирования.
- Power of Two Choices достигает близкого к оптимальному распределению трафика с минимальными вычислениями, избегая проблемы стадного эффекта на больших флотах.
Ключ в понимании того, на что каждый алгоритм обращает внимание, что он игнорирует и когда эти компромиссы имеют значение.
«Арканутый C++»: как экстремальная оптимизация меняет язык
Разработка и архитектура · Habr · 8/10
Статья разбирает нестандартный подход к C++ в игровом движке Arkane Studios, когда для достижения максимальной производительности и предсказуемости команда запретила значительную часть возможностей C++14, оставив лишь то, что работает на этапе компиляции. Автор описывает свой опыт работы в команде, которая пришла из закрытого подразделения EA в Санкт-Петербурге и позже сотрудничала с остинской студией через сложную цепочку подрядчиков. Главные ограничения включают запрет на исключения и RTTI, которые усложняют анализ потока управления, и фанатичное следование принципу zero frame allocations — всего около двадцати аллокаций на один кадр вместо тысяч. Для достижения этого пришлось выделить стек в 20 МБ для главного потока, жёстко распределить память по статическим кешам и пулам, а также ввести доменную систему выделения памяти, где каждая подсистема получает свой аллокатор с чётким бюджетом. Обработка ошибок разделена на два уровня: ожидаемые проблемы (файл не найден, соединение разорвано) возвращают Result<T, E>, а нарушения контракта вызывают единый panic() с диагностикой и завершением программы. Несмотря на огромные накладные расходы на разработку и сложность переучивания команды, такая архитектурная дисциплина позволила создать удивительные и необычные игры.
Выводы автора:
- C++ допускает множество полностью противоположных стилей разработки: универсальный современный язык можно заменить архитектурной дисциплиной, ориентированной на предсказуемость и производительность в реальном времени.
- Принцип zero frame allocations требует огромной дополнительной организационной работы (стеки, пулы, доменная память), но позволяет стабильно работать на консолях и достичь гарантированной производительности.
- Явная обработка ошибок через Result вместо исключений добавляет постоянные накладные расходы, но делает поток управления видимым и предсказуемым для компилятора и разработчиков.
В крупном проекте почти никогда не существует единого C++, потому что есть C++ в тулах и есть C++ загрузчика, и есть C++ игровой логики, и есть хотпас рендера.
Оригиналы:Эти пчелы делают неправильный C++ · Раздел Программирование на Habr
Хардварные стартапы, которые меняют мир: три истории успеха
Разработка и архитектура · Habr · 8/10
Статья рассказывает о трёх хардварных стартапах, основанных энтузиастами и студентами, которые разработали инновационные решения в робототехнике и химии. Open Bionics, основанная Джоэлом Габбардом и Самантой Пейн, создаёт роботизированные протезы рук стоимостью в три раза ниже аналогов, используя 3D-печать нейлона 12, систему тросиковых тяг и 3D-сканирование культи. Протез «Hero Arm» оснащён магнитными креплениями для стильного оформления и управляется через считывание электрических импульсов мышц. Air Company разработала технологию преобразования CO₂ из атмосферы в этанол через искусственный фотосинтез, производя 5000 ящиков водки в год (каждая бутылка потребляет ~0,45 кг CO₂), а затем расширилась на парфюм и авиационное топливо. ODrive, созданная Оскаром Вайглем, предложила недорогую плату управления бесколлекторными двигателями с поддержкой двух каналов до 100А, методом FOC и рекуперативным торможением, став стандартом в любительской робототехнике несмотря на массовое копирование китайскими производителями.
Выводы автора:
- Инженерные инновации (3D-печать, FOC, искусственный фотосинтез) позволяют снизить стоимость решений в 3 раза и сделать технологии доступными для массового рынка
- Студенческие проекты и энтузиазм отдельных людей могут создавать продукты, нужные миллионам пользователей, не зная ограничений "это невозможно"
- Открытые исходные коды и масштабируемые технологии (3D-печать, модульные платы) обеспечивают быстрое распространение идей и коммерциализацию
Один простой энтузиаст может создать нечто, весьма нужное для очень большого числа людей
Оригиналы:Хардварные стартапы — которые меняют мир
Телевизоры LG собирают данные о контенте HDMI без надлежащей защиты
Кибербезопасность · Habr · 8/10
Исследователи GamersNexus, Level1Techs и независимые специалисты обнаружили серьёзные проблемы безопасности в умных телевизорах LG с webOS. В основе рекламной системы лежит технология ACR (Automatic Content Recognition), которая создаёт цифровые отпечатки изображения и анализирует не только контент webOS, но и данные, поступающие через HDMI-порт, например при подключении ноутбука. Полученная информация передаётся в подразделение LG Ad Solutions для таргетирования рекламы. При исследовании устройства с root-правами учёные обнаружили возможность включения микрофона без видимых индикаторов в интерфейсе, даже при погашенном экране. Записи голоса хранятся в открытом виде без шифрования — в логах были найдены конфиденциальные данные вроде номеров социального страхования. Хотя это не доказывает прямой сбор LG, такой подход создаёт возможность для хакеров перехватывать управление и подслушивать пользователей. В протест разработчики запустили сайт We Own the Glass с заставками художественных произведений о революциях.
Выводы автора:
- Телевизоры LG анализируют контент не только из встроенных приложений, но и со внешних источников через HDMI, передавая данные рекламному подразделению компании
- Уязвимость архитектуры безопасности позволяет включать микрофон без уведомления пользователя и хранить конфиденциальные данные в открытом виде, что создаёт риск для перехвата информации злоумышленниками
Это не доказывает прямой сбор данных со стороны LG, но потенциально такой подход к безопасности даёт возможность хакерам перехватывать управление телевизором и подслушивать за пользователями.
Четыре тренда платежных технологий: автоматизация, API-интеграция и сетевые платформы
Финтех и финансы · Б.О: Банки · 9/10
Материал разбирает четыре ключевых тренда в развитии платежных технологий, которые определяют инвестиционные приоритеты в финтехе (19,2 млрд из 116 млрд долларов глобальных вложений в 2025 году). Первый тренд — исчезновение видимости платежа: клиент совершает действие (покупку), а расчет происходит автоматически внутри процесса; в 2025 году 56% мировой электронной торговли оплачивалось через цифровые кошельки, в России за девять месяцев 2025 года произведено 146 млн биометрических платежей (в 9 раз больше, чем годом ранее). Второй тренд — преимущество банка зависит не от интерфейса, а от интеграции в процессы клиента через API; 65% корпоративных казначейств планируют расширять использование API, 31% выбирают банк именно за простоту интеграции. Третий тренд — платформизация инфраструктуры: государственные и отраслевые платформы (СБП в России, Pix в Бразилии, UPI в Индии, EPI в Европе) снижают стоимость платежа в 2–10 раз по сравнению с картами; цифровые валюты центральных банков внедряют или изучают 146 стран и валютных союзов. Четвёртый тренд — объединение национальных платформ в региональные сети: EuroPA (10 стран Европы), Nexus Global Payments в Азии, PAPSS (28 стран Африки), а также двусторонние коридоры, например между Россией и Ираном. Автор подчёркивает: платёж теряет роль самостоятельного продукта, его цена стремится к нулю, а ценность возникает вокруг него — в управлении ликвидностью, антифроде, идентификации. Выиграют игроки, которые лучше понимают бизнес-процессы клиента, а не те, кто конкурирует только тарифами.
Выводы автора:
- Платёж становится невидимым: расчёт встраивается в действие клиента (покупку, перевод, оплату услуги) и происходит автоматически через цифровые кошельки, супераппы и биометрию.
- Для корпоративных клиентов ценность банка определяется не тарифами, а способностью интегрироваться в их системы через API и автоматизировать процессы.
- Государственные и региональные платежные платформы (СБП, Pix, UPI, EPI и др.) снижают издержки в 2–10 раз и становятся стандартом; финтехи и банки должны конкурировать через сервисы вокруг платежа, а не через сам платёж.
Лучший блокчейн — тот, которого никто не замечает: продукт остаётся привычным, просто внутри работает быстрее и дешевле.
Как новые стандарты МСФО 17 и МСФО 9 изменили отчетность страховщиков
Финтех и финансы · Б.О: Не банки · 8/10
С 2025 года российские страховщики перешли на МСФО 17 и МСФО 9, что кардинально изменило подход к учету страховых обязательств и финансовых инструментов. Новая отчетность отделяет страховой результат от инвестиционного, делая страховые компании более сопоставимыми с банками и другими финансовыми институтами. Вместо фокуса на валовые премии акцент сместился на будущую маржу, качество резервов и стоимость принятого риска. В 2025 году российский страховой рынок вырос на 6,9% до 4 трлн рублей, однако часть этого роста связана с эффектом новой методологии: в life-сегменте 57% компаний фиксировали рост капитала более чем на 10%, в non-life эффект был менее однородным. Для non-life важны показатели аквизиционных расходов, коэффициента убыточности, качества резервов (LIC и LRC), а для life — контрактная сервисная маржа (CSM) как индикатор будущей прибыли и способность инвестиционного портфеля работать лучше обязательств.
Выводы автора:
- Новые стандарты МСФО 17 и 9 переносят аналитический фокус со спонированных премий на экономику бизнеса, качество будущей прибыли и маржинальность, что требует пересборки аналитической базы при сравнении с допереходными периодами
- В non-life стоимость создается через правильную цену риска, контроль аквизиционных расходов и качество резервов, в life — через контрактную сервисную маржу (CSM) и способность инвестиционного портфеля генерировать избыточную доходность над обязательствами
- Рост абсолютных показателей (премии, прибыль, капитал) может быть связан как с реальным развитием бизнеса, так и с эффектом новой методологии, что требует глубокого анализа при оценке платежеспособности и стоимости в M&A сделках
Новая отчетность лучше разделяет, где компания зарабатывает на страховом риске, а где — на управлении активами и финансовом результате.
Оригиналы:Страховой бизнес в новой отчетности
Эволюция эквайринга ПСБ: от приёма карт к мультиканальным платежам
Финтех и финансы · Б.О: Технологии · 8/10
Материал рассказывает о трансформации эквайринга в малом бизнесе на примере развития сервиса в ПСБ — переход от базовой функции приема карт к поддержке множественных платежных сценариев (QR-платежи, мобильные Pay-сервисы, биометрия, цифровой рубль). За последний год доля платежей со смартфонов в ПСБ выросла более чем вдвое. Банк значительно ускорил процесс подключения: если в 2024 году сроки доходили до 14 дней, то сейчас — от трёх дней до одного часа при обращении в офис. Весной 2026 года запущена выдача POS-терминалов в день обращения, в августе — однодневная выдача онлайн-касс. Эквайринг интегрирован с ИИ-ассистентом «Катюша», который помогает в настройке и остаётся каналом взаимодействия. Данные об оборотах, поступающие через эквайринг, позволяют банку развивать кредитные продукты (например, кредитование под обороты эквайринга). ПСБ внедрил технологию «Волна» для оплаты смартфоном через Bluetooth, запустил решение «Оплата с чаевыми» от платёжной системы «Мир». Банк договорился с НСПК о развитии биоэквайринга и участвует в разработке российских POS-терминалов совместно с БФС и Инновационным инжиниринговым центром. С 1 сентября 2026 года через универсальный платежный код доступна оплата цифровым рублём, позволяя клиентам выбирать способ оплаты после сканирования единого кода.
Выводы автора:
- Эквайринг трансформируется из специализированного сервиса в универсальную точку входа в комплексное обслуживание предпринимателя, интегрированную с кредитованием и цифровыми сервисами.
- Скорость подключения нового оборудования и сервисов критична для малого бизнеса — ПСБ сократил этот процесс с 14 дней до одного часа, что является конкурентным преимуществом.
- Будущий эквайринг должен быть готов к быстрой смене платежных инструментов и пользовательских привычек, при этом оставаясь максимально простым для предпринимателя.
Меняются платежные инструменты, но прием платежей для бизнеса должен оставаться максимально простым и незаметным.
Оригиналы:Эволюция эквайринга для малого бизнеса: формула ПСБ
Метод выбора IT-профессии: от неопределённости к конкретному плану
Продукт и карьера · Habr · 8/10
Статья предлагает систематический подход к выбору IT-специальности и планированию карьеры, разбирая метод на примере кибербезопасности. Автор рекомендует сначала честно определить, какие задачи вам интересно решать ежедневно, а не гоняться за красивым названием должности. Затем нужно изучить существующие роли в выбранной области: пентестер, DevSecOps-инженер, аналитик SOC, специалист по реверс-инжинирингу, AppSec-инженер и другие. Важно также учитывать тип компании (частные, госструктуры, интеграторы, вендоры, аутсорс), так как одна должность в разных организациях может сильно отличаться по задачам и темпу работы. Ключевой практический шаг: собрать 50+ вакансий на hh.ru или LinkedIn, загрузить их в ИИ (например, Claude) и получить таблицы с наиболее частыми требованиями и обязанностями. Это даёт реальный срез рынка вместо абстрактных роадмапов. Автор подчёркивает важность портфолио, сертификаций (OSCP, CTF для пентестеров, pet-проекты для DevSecOps), homelabинга и живого общения с людьми в сообществах, так как AI-системы на job-бордах часто отсеивают кандидатов автоматически.
Выводы автора:
- Выбирайте IT-специальность, исходя из реальных ежедневных задач, а не названия должности, и учитывайте тип компании
- Собирайте требования прямо из вакансий рынка через ИИ-анализ, чтобы получить конкретный приоритетный список для обучения вместо абстрактных роадмапов
- Ищите работу через живое общение в сообществах, мероприятиях и личные контакты, не полагайтесь только на job-борды с автоматической обработкой
Одна и та же должность в разных типах компаний — это часто вообще разные задачи и разный темп работы.
Оригиналы:Как выбрать IT-профессию и понять, что учить — метод на примере кибербезопасности
Легендарные презентации в IT: от Microsoft до Apple как школа для спикеров
Продукт и карьера · Habr · 8/10
Статья разбирает шесть исторически значимых презентаций технологических компаний, которые не просто продавали продукты, но меняли культурные привычки и создавали новые форматы публичных выступлений. Автор показывает, как Microsoft с Windows 95 (1995) превратила релиз ОС в поп-культурное явление с шоу, спутниковыми трансляциями и привлечением звёзд (инвестиции $300 млн, первые 5,5 млн продаж за 5 недель). Amazon с Kindle (2007) применила более утончённую тактику — создала интеллектуальную атмосферу закрытого клуба, используя социальное доказательство (лауреаты премий и известные авторы), и запустила экосистему вокруг новой привычки; первая партия разошлась за 5,5 часов, к 2010 году Kindle-бизнес дал оборот $1 млрд. Apple с iPhone (2007) применила схему Джобса: объявить о трёх устройствах, затем раскрыть, что это одно, и позиционировать как неизбежное будущее. Ключевой вывод: успешная презентация должна продавать не прибор, а новую картину мира, быть сфокусирована на главной идее и использовать инструменты, наследуемые каждым следующим лидером от предшественников.
Выводы автора:
- Сильная презентация в IT продаёт новую картину мира и культурный сценарий, а не просто технические характеристики продукта.
- Каждое крупное выступление наследует и развивает приёмы предшественников: Microsoft показала массовый медиашум, Amazon — тактику экосистемы и социального доказательства, Apple — минимализм и позиционирование будущего.
- Для успеха презентации необходимо сфокусироваться на одной главной мысли, обойтись без технических подробностей и опираться на искреннюю веру спикера в сказанное.
В ИТ-индустрии сильная презентация редко продает определенное устройство или сервис. Проще продавать новую картину мира — как люди будут общаться, читать, работать, смотреть видео.
Оригиналы:Шесть ярких презентаций о технологиях как бесплатный архив идей и уроков · История IT
Как личная ошибка основателя разрушает репутацию бренда
Продукт и карьера · Б.О: Не банки · 8/10
Статья разбирает кейс компании Revyline, где старое интервью основателя Максима Обушенкова с оскорбительными комментариями о женщинах получило вирусный охват спустя почти год. Материал показывает, как цифровой архив становится источником отложенных репутационных кризисов: старое видео месяцами лежит в сети, но один популярный блогер может превратить его в проблему для бизнеса. Когда лидер бренда — его публичное лицо, его личные высказывания неизбежно приписываются компании; это особенно критично в отраслях, построенных на доверии. Главная ошибка Обушенкова заключалась не только в первоначальной фразе, но и в том, что он назвал критику «честным маркетингом» — это превратило старое видео в его актуальную позицию. Вторая волна кризиса была вызвана неправильной реакцией. По данным SL, через три недели после пика скандала доля негативных упоминаний выросла с 3 до 25%, а продуктовая повестка снизилась на 36%. Репутационные потери проявляются в отказе от повторных покупок, оттоке клиентов и снижении доверия. Автор объясняет, что аудитория не требует безошибочности, но смотрит, насколько быстро компания признает ошибку без высокомерия.
Выводы автора:
- Репутационные кризисы могут появиться с большой задержкой, когда старый контент находит резонатор с достаточным охватом
- Первая реакция лидера на критику либо останавливает эскалацию, либо ускоряет её; попытка выдать возмущение за маркетинговый успех создаёт вторую волну кризиса
- В отраслях, построенных на доверии, способность быстро и без высокомерия признавать ошибки становится финансовым активом, а не только репутационным
Лайк не равен покупке, комментарий не тождествен лояльности, а вирусность — доверию. Во время кризиса медийные показатели могут пойти вверх ровно в тот момент, когда бизнес-показатели начнут снижаться.
7 способов испортить канбан-доску: от перегруженных названий к идеальной системе
Продукт и карьера · Habr · 7/10
Статья разбирает типичные ошибки при организации работы в таск-трекерах и канбан-досках, которые приводят к тому, что команда перестаёт пользоваться системой. Автор в форме вредных советов описывает антипаттерны: слишком длинные названия задач вместо лаконичных, недостаток информации в описании, искусственное повышение приоритета всех задач (из-за чего сигнал теряет смысл), избыточное использование всех функций таск-трекера, создание слишком много колонок с нечёткими переходами, неконтролируемый рост незавершённых задач и застывание процесса. Для каждой проблемы приводится решение: держать названия краткими, но полноценными с контекстом в описании, использовать сроки и приоритеты избирательно, добавлять функции только под реальные проблемы, ограничить колонки логичными этапами, разбивать большие работы на закрываемые подзадачи, постоянно адаптировать доску под текущий процесс. Главный вывод: хорошая доска должна позволять разобраться в ситуации за несколько секунд, не требуя от команды обслуживания самой системы.
Выводы автора:
- Краткие названия задач с полным контекстом в описании делают доску скеннируемой и предотвращают потерю информации.
- Сроки и приоритеты должны быть редкими и значимыми — иначе они перестают что-либо означать для команды.
- Процесс управления всегда меняется, поэтому канбан-доска должна регулярно адаптироваться под текущую реальность, а не остаться застывшей на год назад.
Почти все плохие доски начинаются с хороших намерений: добавить контроля, порядка и прозрачности. А заканчиваются одинаково — команда уже не работает с таск-трекером, а обслуживает его.
Оригиналы:Люди гибнут за канбан. 7 способов убить даже хорошую доску
Коротко
Финтех и финансы
- Изменения в стандартах раскрытия информации для операторов финансовых платформ – Банк России опубликовал указание от 29 июня 2026 года о внесении изменений в Положение о формах раскрытия информации в бухгалтерской отчётности операторов инвестиционных и финансов
- Указание ЦБ о стандартах саморегулируемых организаций и формах раскрытия информации – Опубликованы два указания Банка России, вносящие технические изменения в нормативные акты.
Прочее
- Android-клавиатура «Соучастник» анализирует текст на соответствие законодательству – Разработчик MShverdiakov опубликовал open-source проект — Android-клавиатуру «Соучастник», которая анализирует набираемый текст и предупреждает о возможном соответствии фраз статья
- Microsoft начала показывать полноэкранную рекламу через Bing Wallpaper в Windows 11 – Microsoft встроила полноэкранную рекламу в приложение Bing Wallpaper, которое используется для отображения обоев на рабочем столе Windows 11.