Дайджест за 9 сентября 2026
OpenAI выпустила GPT-6 Astra и готовится штурмовать корпоративный рынок кодирования, пока разработчики разбираются, как переосмыслить код-ревью в эпоху AI-агентов. Параллельно инженеры решают архитектурные вызовы — от проблем с памятью ранних агентов до надежности платежных систем (American Express показала, как это делается через cell-based design). Плюс неожиданно полезное: как промпт-инжиниринг, формальная верификация и даже интерпретатор Python в 1024 байтах меняют реальность разработки прямо сейчас.
Главное
- Почему ссылка сброса пароля не работает: тайна почтовых сканеров
- GPT-6 Astra: OpenAI атакует рынок корпоративного кодирования
- Как меняется код-ревью в эпоху AI-агентов в 2026 году
- Память агентов: что не так с первой волной систем и что дальше
- Архитектура обработки платежей American Express: надёжность через cell-based design
Подробно
GPT-6 Astra: OpenAI атакует рынок корпоративного кодирования
ИИ и агенты · Linas from Linas's Newsletter · 9/10
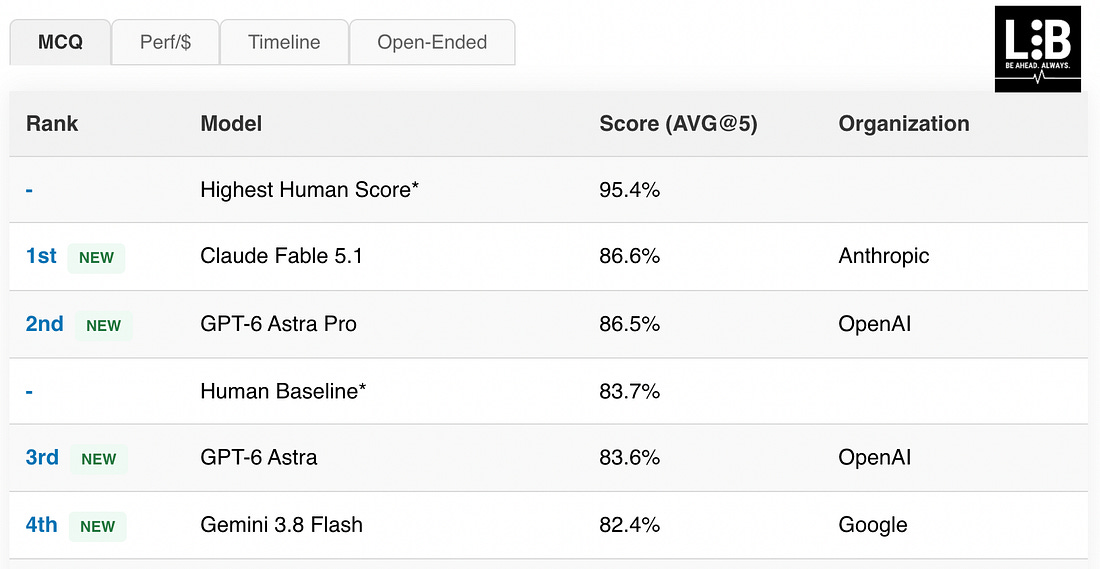
OpenAI выпустила GPT-6 Astra и на основе этого NVIDIA заявила об наступлении AGI, но главное не в громких словах, а в практических результатах. Согласно оценке Artificial Analysis от 3 сентября, Astra сравнялась с Claude Fable 5 по качеству работы с кодом (оба выше человеческого уровня на бенчмарке SimpleBench) при меньшей чем половине стоимости за задачу.
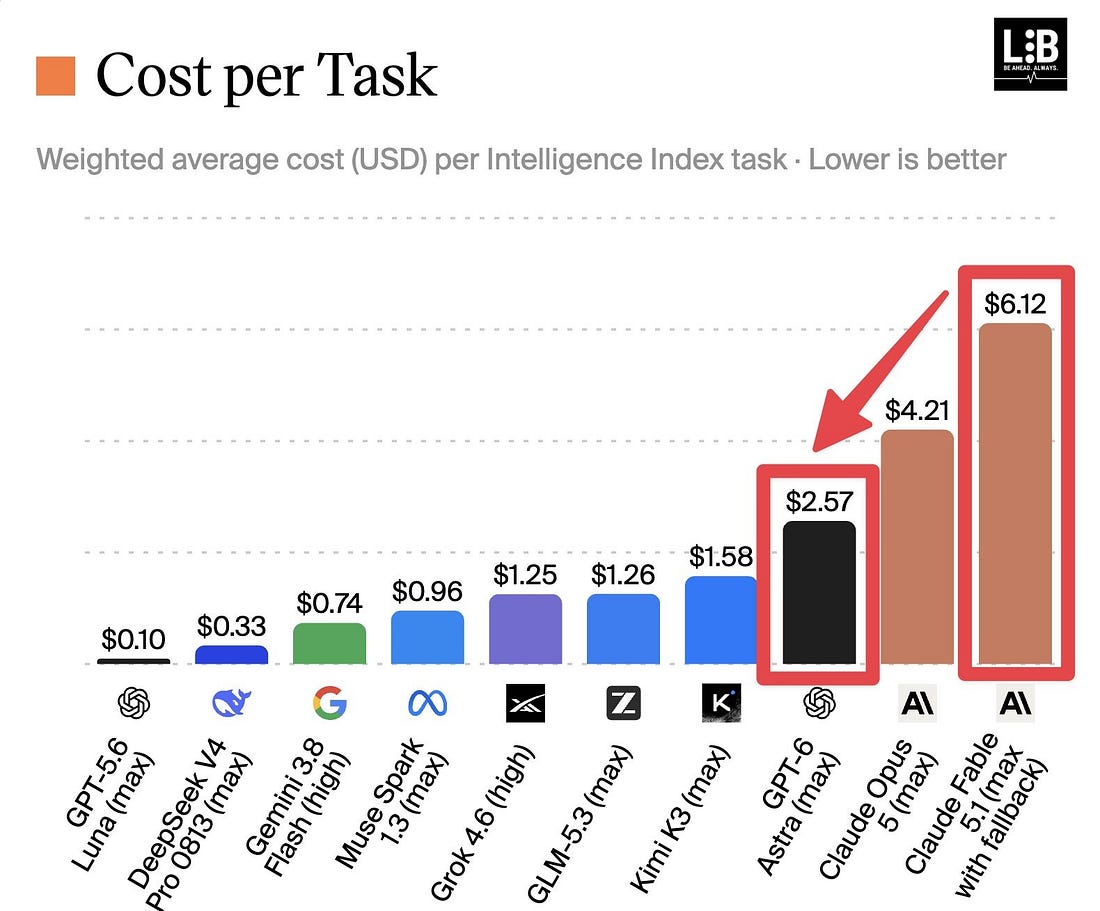
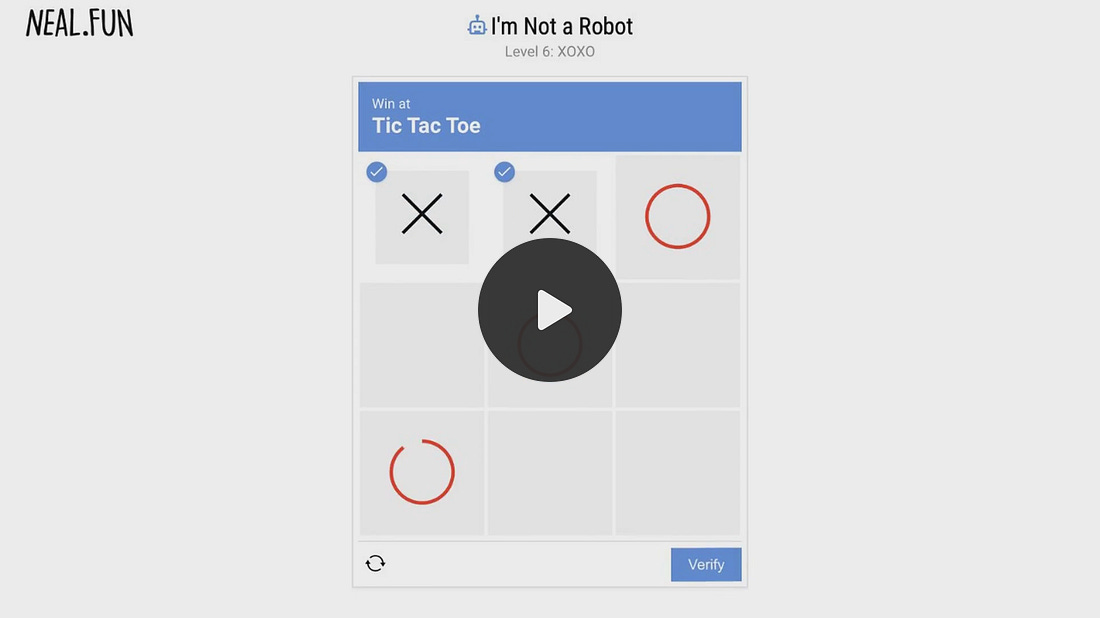
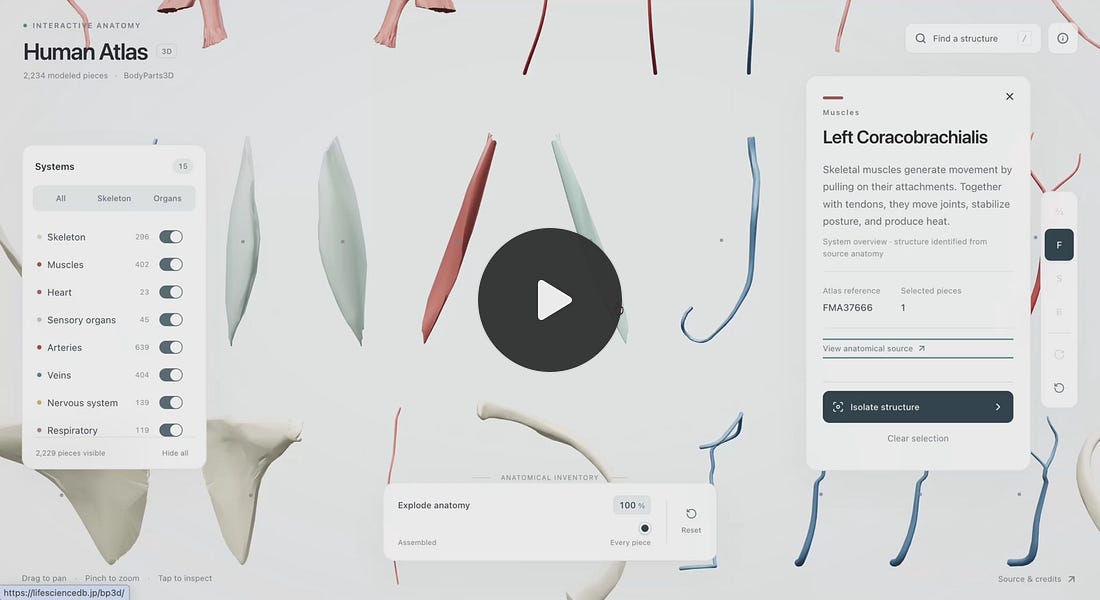
Это прямая атака на рынок, где Anthropic доминирует: по оценке Menlo Ventures, Anthropic контролирует 54% корпоративного сегмента AI-кодирования против 21% у OpenAI. Разработчики показали впечатляющие демо: инженер OpenAI Sharif Shameem опубликовал видео, где Astra прошла все 48 уровней браузерной игры «I'm Not a Robot», включая головоломки и ритм-игры; другой разработчик создал 3D-анатомический исследователь с 2234 интерактивными сетками.
Самое поразительное: за последний год горизонт решаемых задач расширился с ~30 минут до ~16 часов, и кривая продолжает ускоряться.
Выводы автора:
- GPT-6 Astra достигает стоимости менее половины от Claude при сопоставимом качестве на кодировании, угрожая доминирующей позиции Anthropic на рынке корпоративного AI-кодирования
- Модели теперь превысили человеческий уровень на задачах повседневного рассуждения (SimpleBench), и этот прогресс ускоряется по экспоненциальной кривой
- Горизонт независимого решения задач расширился более чем в 30 раз за год – от 30 минут до примерно 16 часов
Мы перешли от задач в ~30 минут к горизонту ~16 часов чуть более чем за год, и кривая продолжает ускоряться.
Оригиналы:OpenAI · NVIDIA · Claude Fable 5
Память агентов: что не так с первой волной систем и что дальше
ИИ и агенты · Modern Data 101 · 9/10
Статья разбирает архитектуру и проблемы существующих систем памяти для AI-агентов. Автор различает три вида информационного восприятия: контекстное окно (видимое в текущей сессии), поиск по документам (retrieval) и подлинную память — информацию об отдельном человеке или проекте, сохраняющуюся между сессиями.
Анализируя основные решения (Mem0, Zep, Graphiti, LangMem, Letta, Cognee, Supermemory), автор выявляет шесть критических проблем, общих для всей первой волны систем памяти. Главное открытие: простое сохранение дословных разговоров (verbatim storage) превосходит на 15.9–22 пункта сложные системы с LLM-экстракцией фактов, потому что экстрактор принимает решение о релевантности до того, как станут известны вопросы — выброшенное им безвозвратно.
Бенчмарк LoCoMo, на котором тестируют эти системы, содержит 6.4% критических ошибок, включая галлюцинированные факты в ответах, а LLM-судья принимает до 63% заведомо неправильных ответов. Другие проблемы: система теряет историю изменений мнений, путает утверждения пользователя с фактами, не различает проверяемые данные и предположения, игнорирует информацию вне чатов (Slack, Notion, Jira, CRM).
Выводы автора:
- Сохранение дословных текстов разговоров работает лучше, чем сложная семантическая экстракция фактов, потому что экстрактор необратимо выбрасывает информацию до того, как известны вопросы.
- Текущие бенчмарки (LoCoMo, LongMemEval) слишком шумные и включают халатные ошибки, из-за чего не различают хорошие решения от тривиальных (текстовые файлы получают тот же балл, что и сложные графовые системы).
- Агенты должны помнить не только собственные разговоры, но и решения из Slack, Jira, Notion и CRM, иначе они переговаривают уже решённые вопросы, как новый сотрудник, отказывающийся читать документацию.
Извлечение фактов обязывает себя релевантности до того, как существуют вопросы, а дословное хранилище откладывает это решение на время запроса. Всё, что выбросил экстрактор, безвозвратно потеряно, независимо от того, как хорош будет ваш поиск позже.
Оригиналы:Agent Memory: The First Wave
Промпт-инжиниринг и работа с LLM: книга о диалоге с искусственным интеллектом
ИИ и агенты · Habr · 8/10
Издательство БХВ выпустило книгу Камиля Гадеева «Промпт-инжиниринг и работа с LLM. Как говорить с искусственным интеллектом», которая фокусируется не на сборниках готовых промптов, а на глубоком понимании того, как устроены языковые модели и как эффективно с ними взаимодействовать. Автор демонстрирует распространённые ошибки: студенты безоговорочно доверяют LLM и принимают первый ответ как истину. Гадеев показывает пример, когда с помощью манипулятивного промпта (давление по времени, запрет на «не знаю», требование уверенности) Gemini генерирует полностью фиктивный протокол с несуществующими методиками и ссылками на ЮНЕСКО — но ответ звучит убедительно и связно. Книга охватывает внутреннее устройство LLM (машина связности, предсказание токена, контекстное окно), грамматику промптов (структура запроса, few-shot, RAG, температура), управление сложными сценариями (Chain-of-Thought, Tree of Thoughts, ReAct), работу с галлюцинациями через протоколы верификации и прикладные области (код, тексты, изображения, аналитика, маркетинг). Особое внимание уделено когнитивным рискам. Гадеев позиционирует книгу как руководство по пониманию ошибок при работе с ИИ: ошибки доверия (красивый ответ воспринимается как правда), ошибки восприятия (LLM не база данных, а нарративный двигатель, генерирующий статистически вероятное продолжение), ошибки формулировки промптов и непонимания ограничений моделей. Главный вывод: если ваше мышление структурировано, промпт становится ненужным — каждая фраза становится хорошим промптом.
Выводы автора:
- LLM — это машина связности, предсказывающая статистически вероятное продолжение текста, а не база данных или калькулятор; галлюцинации и искажения фактов — следствие её природы, ответственность за проверку лежит на пользователе.
- Главная ошибка — безоговорочное доверие к красиво оформленным ответам; нужно учиться замечать, когда модель отклоняется от темы, галлюцинирует или интерпретирует вас неправильно.
- Эффективность работы с LLM зависит не столько от сложности промпта, сколько от ясности и структурированности вашего мышления; если вы чётко понимаете задачу, любой запрос будет работать.
Нужно учиться видеть, когда модель отклоняется от направления и замечать пробелы в ответе. LLM — машина интерпретаций, и очень часто она интерпретирует вас неправильно не потому что глупа, а потому что вы не сказали достаточно.
Оригиналы:Как говорить с искусственным интеллектом. Книга о промптах · Профессиональная литература
Формальная верификация станет массовой благодаря ИИ-агентам
ИИ и агенты · Habr · 8/10
Статья предсказывает, что искусственный интеллект коренным образом изменит экономику формальной верификации кода, превратив её из нишевого направления в промышленный стандарт. Сегодня формальная верификация остаётся редкой практикой, несмотря на существование специализированных языков (Rocq, Isabelle, Lean, F*, Agda) — причина в невероятной сложности и дороговизне написания доказательств (например, верификация микроядра seL4 потребовала 20 человеко-лет и 200 тысяч строк кода). Современные LLM-агенты уже демонстрируют способность автоматически генерировать доказательные скрипты на разных языках; по мере автоматизации процесса экономика верификации радикально изменится. Автор выделяет три ключевых обстоятельства: верификация подешевеет, код ИИ можно будет верифицировать формально вместо ревью, а строгость методов компенсирует недетерминированность LLM. Основная оставшаяся задача — правильно описать спецификацию, что несравнимо проще, чем ручное доказательство. Ограничивающим фактором станут не технологии, а культурные сдвиги в восприятии формальных методов.
Выводы автора:
- Формальная верификация благодаря ИИ-агентам резко подешевеет и станет массовой практикой в промышленности в ближайшие годы.
- Формально верифицированный код ИИ заменит ревью человеком, обеспечивая математическую гарантию корректности без необходимости читать сгенерированный код.
- Главный вызов переместится с написания доказательств на правильное описание спецификации требований к системе.
Чем заставлять людей вычитывать код, сгенерированный ИИ, я бы поручил ИИ доказать, что сгенерированный им код действительно корректен.
Оригиналы:Прогноз: благодаря ИИ формальная верификация станет мейнстримом
Как SpaceXAI создала Grok Bot за месяц: от кода к хиту
ИИ и агенты · Lenny's Newsletter · 7/10
Подкаст Lenny's Newsletter с Романом Угарте из SpaceXAI о разработке и запуске Grok Bot – популярного AI-агента для knowledge work. Небольшая изолированная команда создала рабочий внутренний продукт за четыре недели, а затем успешно запустила его публично ещё за три недели. До Grok Bot Роман возглавлял Growth в Cursor, помогая компании вырасти с 15 до 1000+ сотрудников перед покупкой SpaceX. В беседе обсуждаются происхождение Grok Bot, решение разрабатывать его с нуля вместо интеграции в Cursor, процесс личного onboarding почти 300 первых пользователей, две ключевые продуктовые решения, обеспечившие успех, философия "colleague-pilled" и советы Романа о конкурентных преимуществах на самом конкурентном рынке в мире.

Выводы автора:
- Решение разработать Grok Bot как отдельный продукт вместо добавления в Cursor было критическим для его успеха
- Личный onboarding первых 300 пользователей помог команде получить ценный фидбэк и построить сильное сообщество
- AI-агент, выполняющий 100% работы, категорически отличается от того, что справляется только на 90%
AI, который делает 100% работы, категорически отличается от того, который доходит до 90%
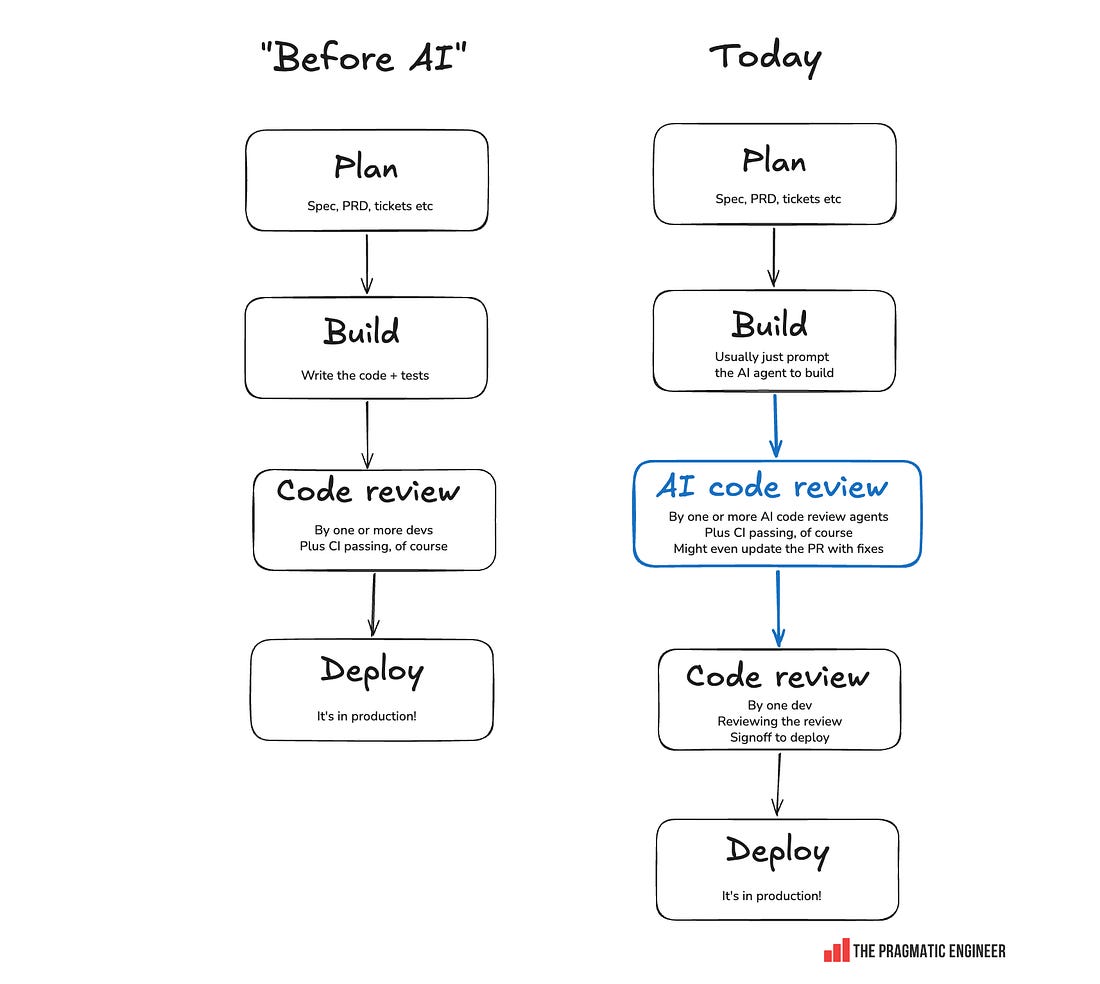
Как меняется код-ревью в эпоху AI-агентов в 2026 году
Разработка и архитектура · The Pragmatic Engineer · 9/10
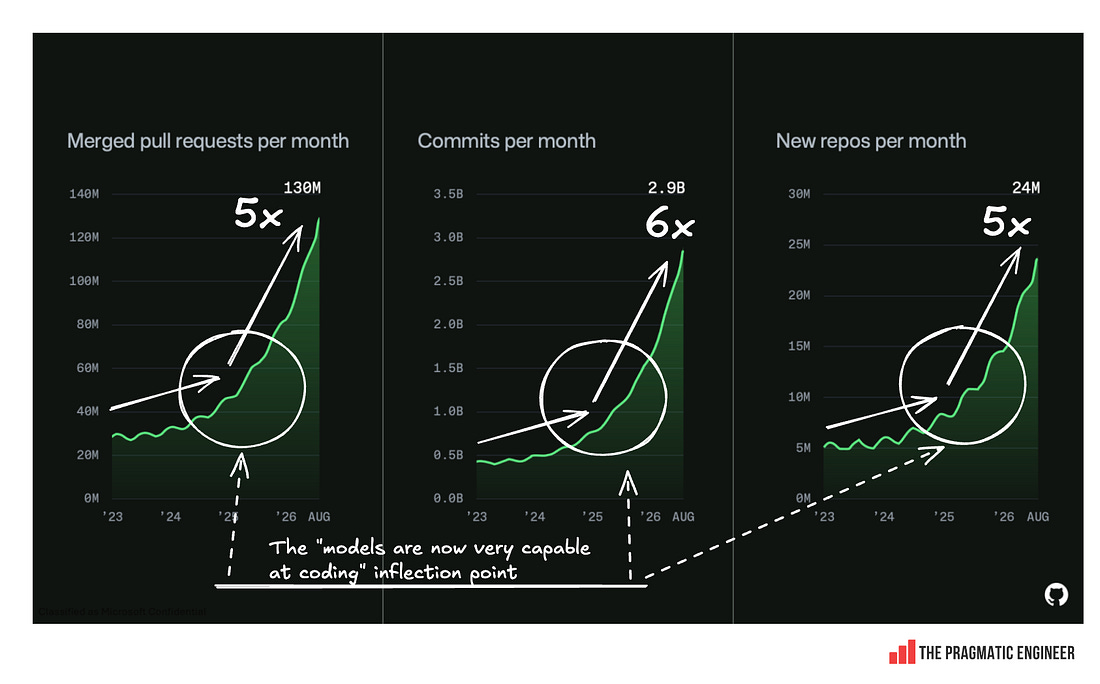
Материал рассматривает, как инженерные команды адаптируют процесс code review в условиях, когда AI-агенты генерируют больше кода, чем люди успевают отследить. На GitHub количество pull requests за три года увеличилось в пять раз, а с конца 2025 года почти удвоилось. Автор описывает семь основных подходов к решению проблемы: люди проверяют AI-ревью (популярный метод с использованием CodeRabbit, GitHub Copilot и других инструментов); классификация изменений по «радиусу риска» (низкорисковые не требуют человеческой проверки, высокорисковые требуют); проверка плана/тестов/схемы базы вместо кода; генерация меньшего объёма кода; полная человеческая проверка; отказ от code review (редкий случай); возврат к основаниям code review.
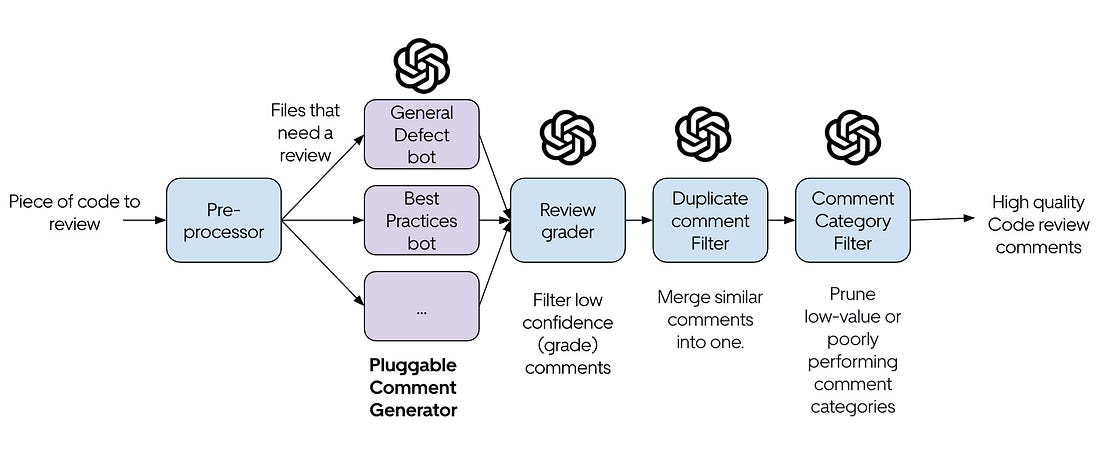
Примеры реальных компаний: Anthropic и OpenAI используют risk-based подход; Uber построил agentic pipeline uReview для фильтрации шума в AI-комментариях; стартап Duckbill Group увеличил скорость мержа PRs с 28% за час до 45% после введения risk-based системы. Ключевой вывод Etienne Dilocker из Weaviate: агентам трудно найти правильный баланс, поэтому оптимально использовать агентов на 90% работы с человеком в цикле для критических решений.
Выводы автора:
- Классификация по «радиусу риска» позволяет командам значительно ускорить процесс разработки: Duckbill Group увеличила скорость мержа на 94% и среднее время мержа PR без human review с часа до одного часа
- Ключевая проблема AI code review — шум: требуется кастомная разработка (как Uber uReview) для фильтрации низкоуверенных комментариев и выделения действительно важных замечаний
- Для быстрорастущих стартапов имеет смысл сфокусироваться на проверке плана, тестов и схемы базы данных, а не деталей реализации, так как код легко переписать, а данные нет
Очень сложно агентам найти правильный баланс в code review. Если полностью игнорировать человеческую проверку и оставить всё агентам, каждый PR либо разрастётся, либо привнесёт критические ошибки.
Оригиналы:Что происходит с code reviews?
Интерпретатор Python в 1024 байтах на C
Разработка и архитектура · Habr · 8/10
Автор реализовал функциональный интерпретатор подмножества Python на языке C, уместив его ровно в 1024 байта кода. Задача была поставлена как упражнение по код-гольфингу: сначала попытка на 512 байт не удалась (получился только калькулятор), поэтому увеличили лимит вдвое. Парсер использует рекурсивный спуск без промежуточного представления кода — выражения интерпретируются и исполняются одновременно. Все состояние хранится в глобальных переменных (исходный код, таблица символов переменных и функций, позиция парсера). Циклы реализованы путём повторного парсинга исходника на каждой итерации, функции запоминают свою позицию в коде и возвращаются туда при вызове. Для минификации использованы классические трюки код-гольфинга: односимвольные имена, полагание на неявные типы C89, битовые операции вместо логических, ASCII-значения вместо символьных литералов, тернарный оператор и оператор-запятая. Читаемая версия занимает более 4800 байт. Реализованы: переменные (одна буква), арифметика (+ - * %), сравнения, условия (if/else), циклы (while, for x in range), функции без аргументов, блоки по отступам, print с литералами и выражениями, комментарии.
Выводы автора:
- Полнофункциональный интерпретатор Python можно реализовать в 1024 байтах без промежуточного кода, используя интерпретацию на лету при парсинге с рекурсивным спуском.
- Код-гольфинг требует глубокого понимания особенностей языка (C89) и требует итеративной оптимизации, но результаты могут быть достаточно неожиданными — циклы работают через повторный парсинг, функции через позиции в исходнике.
Удивительно, что это возможно даже без промежуточного представления! Интерпретатор тоже почти не хранит никакого состояния.
Оригиналы:Интерпретатор Python в 1024 байтах · Программирование
ADR как инструмент для принятия архитектурных решений в крупных проектах
Разработка и архитектура · Habr · 8/10
Статья рассказывает о применении методологии Architecture Decision Records (ADR) при разработке архитектуры для системы интеграций с внешними площадками онлайн-торговли в компании МойСклад. Автор, фронтенд-разработчик Данил, впервые столкнулся с задачей масштабной архитектурной работы и использовал ADR для структурирования мышления. ADR — это документ, фиксирующий архитектурное решение, его причины, рассмотренные альтернативы и последствия (идею предложил Майкл Найгард в 2011 году). Автор подчёркивает, что ADR — не жёсткая методология, а способ снизить тревогу перед сложной задачей. Ключевые моменты: необходимо анализировать текущее состояние кодовой базы, чётко определить граничные вопросы (что будет общим, что особенностью), рассматривать действительно конкурентоспособные варианты решения, а не витрину. ADR служит основой для обсуждения, но само решение рождается в дискуссии с коллегами. После принятия решения важно проверить его на практике и при необходимости скорректировать. ADR — это артефакт, а не постоянная документация; для актуальной архитектуры нужен отдельный документ.
Выводы автора:
- ADR помогает структурировать мышление и снижает тревогу при принятии крупных архитектурных решений, выступая основой для обсуждения, но не источником решения
- Необходимо анализировать реальное состояние системы, чётко определить ключевые архитектурные вопросы и рассматривать действительно конкурентоспособные варианты, а не предвзятый выбор
- Архитектурные решения требуют проверки на практике и остаются открытыми для корректировки; ADR — это артефакт процесса, а не постоянно актуальная документация
ADR — это не приговор. ADR лишь повышает осведомленность перед принятием решения, но архитектура может оказаться неверной и требует проверки на практике.
Оригиналы:Как ADR помог мне не утонуть в первой крупной архитектурной задаче
QArtText: встраивание текста прямо в QR-коды
Разработка и архитектура · Habr · 7/10
QArtText – это открытый веб-инструмент, который позволяет встраивать читаемый текст прямо внутрь QR-кодов, сохраняя их функциональность. Традиционно QR-коды содержат данные с кодами коррекции ошибок Рида-Соломона, что обеспечивает их читаемость даже при повреждениях. QArtText использует байты после терминатора (которые декодеры игнорируют) для размещения визуальной информации, применяя специальный шрифт, оптимизированный для низкого разрешения. Идея основана на методе Russ Cox (QArt), который добавлял цифры в конец URL для создания узнаваемых паттернов. Инструмент позволяет кодировать не только ссылки, но и номера телефонов, пароли и другие данные. Пользователь может редактировать результат вручную – перемещать текст по коду (с автоматическим пересчётом коррекции) или даже менять отдельные пиксели. Готовый код экспортируется в PNG, SVG или DXF (для резака винила). Приложение работает как PWA в браузере без отправки данных на сервер, исходный код доступен на GitHub.
Выводы автора:
- QArtText встраивает текст в QR-коды, используя неиспользуемые декодерами байты и опираясь на математику кодов коррекции ошибок
- Визуальная информация в низком разрешении требует ручного проектирования с учётом восприятия человеческим мозгом, а не просто оцифровки
- Инструмент работает локально в браузере и позволяет экспортировать результат в несколько форматов, включая команды для резки винила
Биты коррекции ошибок считаются линейными операциями над полем Галуа – этот процесс обратимый, можно по заданным значениям найти соответствующие исходные данные
Оригиналы:QArtText на Habr · Open source проект
Эмулятор Сетуни 70: реализация троичной ЭВМ на Rust
Разработка и архитектура · Habr · 7/10
Статья рассказывает об эмуляторе советской троичной ЭВМ «Сетунь 70», разработанном на языке Rust. Автор описывает многолетний путь создания эмулятора (начиная с 2001 года) на различных языках программирования: Java, Pascal, C, C++, Assembler, Haskell, Elm, Idris и, наконец, Rust. Основная сложность заключалась в работе с уравновешенной троичной системой счисления с цифрами {-1, 0, +1}, где один разряд называется «трит». Машина используует отрицательные индексы (номера страниц памяти от -13 до +13, короткие ячейки от -40 до +40), что невозможно напрямую реализовать на большинстве современных языков программирования. Архитектура «Сетуни 70» — это стековая машина с небольшим объёмом памяти: всего 729 18-разрядных слов (243 слова оперативной памяти на 9 страницах), дополняемой магнитными барабанами. Система команд включает 81 команду, из которых 27 — макрокоманды, реализуемые программно из постоянной памяти. На машине работали серьёзные приложения: текстовый редактор, ассемблер, система обучения студентов МГУ, и даже игры. Автор подчёркивает, что выбор языков был продиктован желанием опробовать их возможности, при этом наиболее удобными оказались Haskell и Elm, а наиболее простым и наглядным — Assembler.
Выводы автора:
- Для эмуляции архитектур на основе троичной системы счисления критически важна поддержка отрицательных индексов и правильное представление данных, что требует переосмысления традиционных двоичных подходов.
- «Сетунь 70» была полнофункциональной системой с операционной системой, системой прерываний, поддержкой многопроцессной работы через внешние терминалы и возможностью запуска сложных приложений на ограниченных аппаратных ресурсах.
- Практическая реализация эмулятора лучше всего удалась на функциональных языках программирования (Haskell, Elm) благодаря их математической природе, лучше соответствующей архитектуре троичной машины.
Один байт превращается в памяти в десятки, а иногда и в сотни байт — современная компиляция скрывает реальное соответствие между объявленным типом данных и их представлением в памяти.
Оригиналы:«Я Сетунь 70». Эмулятор троичной ЭВМ на Rust · История IT
Почему ссылка сброса пароля не работает: тайна почтовых сканеров
Кибербезопасность · Habr · 9/10
Материал разбирает реальную проблему: пользователи получают письма со ссылками на сброс пароля, но видят ошибку «ссылка недействительна» даже при первом клике. Корень проблемы в том, что между письмом и клиентом стоят защитные шлюзы (secure email gateway), антивирусы, мессенджеры и почтовые сервисы, которые автоматически проверяют все ссылки, кликая по ним до того, как это сделает человек. Шлюзы полагаются на то, что GET-запросы безопасны и не меняют состояние сервера (RFC 9110), однако разработчики часто помечают токен использованным прямо в GET-обработчике, и сканер израсходует его раньше пользователя. Увеличение срока жизни токена не спасает в режиме, когда шлюз раскрывает письмо при доставке. Рабочее решение — разделить чтение и действие: GET отображает форму и только проверяет токен (оставляя его действительным), а POST меняет состояние (помечает токен использованным и устанавливает новый пароль). Код примера показывает правильную реализацию с проверкой пароля ДО отметки токена и использованием условного UPDATE вместо read-then-write. Дополнительно нужно инвалидировать все остальные токены сброса пользователя и его активные сессии после успешной смены пароля.
Выводы автора:
- Разделите чтение и действие: GET-запросы должны только проверять валидность токена без его использования, а меняющие состояние операции реализуйте через POST.
- Помечайте токен использованным условным UPDATE (WHERE used = false) в обработчике действия, а не в обработчике отображения формы, чтобы гарантировать его одноразовость при одновременных запросах.
- После успешной смены пароля инвалидируйте все остальные токены сброса пользователя и его активные сессии — иначе старые ссылки и логины остаются рабочими.
Для сервера этот запрос выглядит так же, как переход человека, открывшего письмо. Надёжного признака, по которому эти два случая можно различить, нет.
Оригиналы:«Ссылка недействительна» с первой попытки: её открыли до пользователя
Архитектура обработки платежей American Express: надёжность через cell-based design
Финтех и финансы · ByteByteGo · 9/10
Материал разбирает, как American Express обрабатывает миллиарды транзакций с гарантией низкой задержки, даже когда отдельные компоненты отказывают. В 2018 году компания перешла на облачную инфраструктуру и внедрила cell-based архитектуру — каждая ячейка представляет собой полностью независимую копию стека обработки платежей со своими микросервисами, базами данных и инфраструктурой. Ключевая идея: ячейка определяется границей отказа, а не функциональным разделением. Внутри одной ячейки находится минимум компонентов, необходимых для обработки транзакции в реальном времени. Ячейки не имеют синхронных зависимостей в критическом пути — это предотвращает каскадные сбои. Для обеспечения самостоятельности ячеек American Express использует три стратегии управления данными: неизменяемые данные (один раз и навсегда), полустатичные данные (обновляются раз в часы-года, например курсы валют) распределяются в каждую ячейку заранее, а динамичные данные требуют детерминированной маршрутизации — транзакция направляется в ячейку, которая уже содержит нужное состояние.
Глобальный маршрутизатор транзакций — единственный путь между ячейками и внешним миром. Его преднамеренно держат простым: он не содержит бизнес-логики, только извлекает значения для маршрутизации. Надёжность достигается за счёт минимальных зависимостей, отсутствия постоянного состояния, асинхронных операций (логирование, загрузка конфигурации) и параллельного развёртывания во множестве регионов.
Выводы автора:
- Cell-based архитектура изолирует отказы: проблемы внутри ячейки не распространяются на остальную систему, позволяя платежной сети функционировать даже при сбое отдельных компонентов.
- Детерминированная маршрутизация решает проблему консистентности данных, направляя транзакции в ячейку, которая уже содержит нужное состояние, без необходимости синхронных вызовов.
- Глобальный маршрутизатор специально упрощен и лишен бизнес-логики, чтобы избежать превращения в централизованную систему — инженерные ресурсы направлены на поддержание этой простоты.
Ячейка определяется границей отказа, а не функциональным разделением. Одна ячейка может содержать множество микросервисов, но граница имеет значение, потому что за её пределами мы входим в опасную зону.
Оригиналы:Built for Reliability: How American Express Processes Payments at Scale · Ben Cane на Substack · Cell-based Architecture for Resilient Payment Systems
Эволюция эквайринга для малого бизнеса: как ПСБ переводит платежи в мультиканальность
Финтех и финансы · Б.О: Банки · 8/10
Материал разбирает трансформацию эквайринга для МСБ от базового приема карт к мультиканальной платежной экосистеме. ПСБ демонстрирует эту эволюцию на практике: доля платежей со смартфонов выросла вдвое за год, время подключения терминала сократилось с 14 дней до 1 часа, введена выдача оборудования день в день. Банк интегрировал ИИ-помощника «Катюша» для настройки и поддержки в мессенджерах, позволяя предпринимателям проводить платежи, выставлять счета и контролировать остатки в одном интерфейсе. Ключевой инновацией стало использование данных эквайринга для кредитования: банк оценивает обороты бизнеса в реальном времени и предлагает лимиты на основе текущей динамики поступлений. ПСБ полностью внедрил технологию «Волна» (оплата смартфоном через Bluetooth), запустил сервис «Оплата с чаевыми» для кафе и ресторанов. Подготавливаются биометрические платежи через партнёрство с НСПК и разработка российских POS-терминалов. С 1 сентября 2026 года универсальный платежный код позволяет оплачивать цифровым рублем. Эквайринг эволюционирует в универсальную точку доступа к платежным сервисам, а для бизнеса сложность остаётся скрыта — меняются инструменты, но процесс остаётся простым.
Выводы автора:
- Эквайринг становится точкой входа в более широкий спектр банковских услуг, включая кредитование под обороты, а не конечной услугой
- Скорость запуска критична для МСБ: подключение эквайринга за час и выдача терминала день в день сокращают упущенные продажи при открытии точки
- Универсальная платежная инфраструктура, объединяющая карты, QR, мобильные платежи, биометрию и цифровой рубль, позволяет бизнесу не перестраивать кассовый процесс при появлении новых способов оплаты
Эквайринг будущего должен быть готов не к одному заранее выбранному сценарию платежа, а к быстрой смене пользовательских привычек
Оригиналы:Эволюция эквайринга для малого бизнеса: формула ПСБ
Как отдавать продукт бесплатно и зарабатывать на этом
Продукт и карьера · Elena's Growth Scoop · 8/10
Материал о парадоксальной стратегии: компании Lovable щедро раздают бесплатный доступ к своему ИИ-продукту, но при этом зарабатывают больше, чем если бы скупились на свои вычислительные ресурсы. Автор Елена Верна объясняет, что волна паники вокруг маржинальности ИИ-продуктов привела к опасной ошибке: компании стали прятать самое ценное за платёжными стенами, блокируя пользователям возможность понять реальную ценность решения. Вместо этого нужно рассматривать свободный продукт как маркетинговый бюджет с чётким ROI: если за три месяца окупаемость выше, чем при покупке трафика через Google или Meta, канал имеет смысл. Преобразование у Lovable составляет 5–10% из бесплатного слоя и до 40–60% из партнёрских раздач. Автор выделяет три тактики: партнёрские гивавеи (заимствование аудитории других компаний и создателей), события и хакатоны (идеальное окружение для первого опыта), и стартап-программы (встроить в инфраструктуру до того, как компания вырастет). Главное условие успеха — показать пользователям момент "вау" (для Lovable это первое автоматическое поколение кода), чтобы они осознали ценность до рассчета.
Выводы автора:
- Давайте пользователям ровно столько бесплатного продукта, чтобы они испытали главное волшебство и поняли ценность предложения, прежде чем просить оплату.
- Смотрите на свободный продукт как на канал приобретения с чётким порогом окупаемости (3 месяца — хорошая метрика), а не как на расходы, которые уничтожают маржу.
- Используйте партнёрские каналы, события и программы для стартапов, чтобы раздавать продукт эффективнее и с более высокой конверсией (40–60%), чем через прямую рекламу.
Я предпочитаю обогащать наших пользователей, чем Google. Если наш продукт может приобретать клиентов сам и продавать себя, мы, очевидно, предпочтём инвестировать туда и создать более конкурентноустойчивую машину роста.
Оригиналы:How to give away free product and make money doing it
Репутационный кризис Revyline: когда старое видео становится бизнес-проблемой
Продукт и карьера · Б.О: Банки · 8/10
Статья разбирает кейс репутационного кризиса компании Revyline, производителя средств гигиены полости рта, на примере высказывания основателя Максима Обушенкова о внешности женщин. Летом 2025 года он дал короткое интервью, где назвал девушек весом больше 55 кг «жирненькими», но видео оставалось незамеченным почти год. В июне 2026-го блогер Александр Ковен обратил на него внимание, и пост собрал более 210 тыс. лайков. Критическая ошибка Обушенкова была в первой реакции: вместо извинения он назвал возмущение аудитории маркетинговой победой. Через три недели после пика скандала доля негативных упоминаний выросла с 3 до 25%, интенсивность публикаций о продукции снизилась с 98 до 63 постов в день, контент-активность сократилась на 36%. Когда публичность руководителя используется как подтверждение надежности бизнеса, его личные высказывания неизбежно влияют на восприятие компании. Автор подчеркивает, что во время кризиса медийные показатели могут расти, пока бизнес-показатели падают, и аудитория ценит не безошибочность, а скорость признания ошибки и отсутствие высокомерия.
Выводы автора:
- Личный бренд руководителя передает компании и доверие, и все его ошибки; когда собственник продвигает бизнес собственной репутацией, разделить частное мнение и корпоративную позицию невозможно.
- Попытка представить критику аудитории как маркетинговую победу создает вторую волну кризиса и переводит проблему в плоскость ценностей: доверие ли для компании важнее количества комментариев.
- В отраслях, построенных на доверии (включая финансовый сектор), способность руководства быстро признать ошибку, говорить без высокомерия и предпринимать действия становится финансовым активом, а не только репутационным.
Если растут охваты, значит, коммуникация успешна. Но лайк не равен покупке, комментарий не тождествен лояльности, а вирусность — доверию.
Как Oura зарабатывает: от трекера сна к платформе здоровья
Продукт и карьера · App Economy Insights · 7/10
Материал разбирает бизнес-модель Oura перед её выходом на IPO на Nasdaq. Компания эволюционировала из нишевого трекера сна в мультифункциональную платформу здоровья, отслеживающую более 50 метрик. Выручка компании выросла на 74% год-к-году до $1,2 млрд в первые девять месяцев финансового года 2026, при этом компания прибыльна и привлекла 5 миллионов платных подписчиков. Основное конкурентное преимущество — форм-фактор кольца, который обеспечивает лучший сигнал фотоплетизмографии по сравнению с браслетом и побуждает постоянное ношение. Продано 3,6 млн колец за 12 месяцев, что составляет около 2% глобального рынка носимых устройств. Пользовательская база — преимущественно женщины (72%), молодого и среднего возраста (73% моложе 45 лет) с доходом выше $100 тыс. (63%), многие из которых имеют хронические заболевания. Ключевой вопрос для инвестора: удастся ли Oura расширить категорию смарт-колец вместо конкуренции с умными часами.
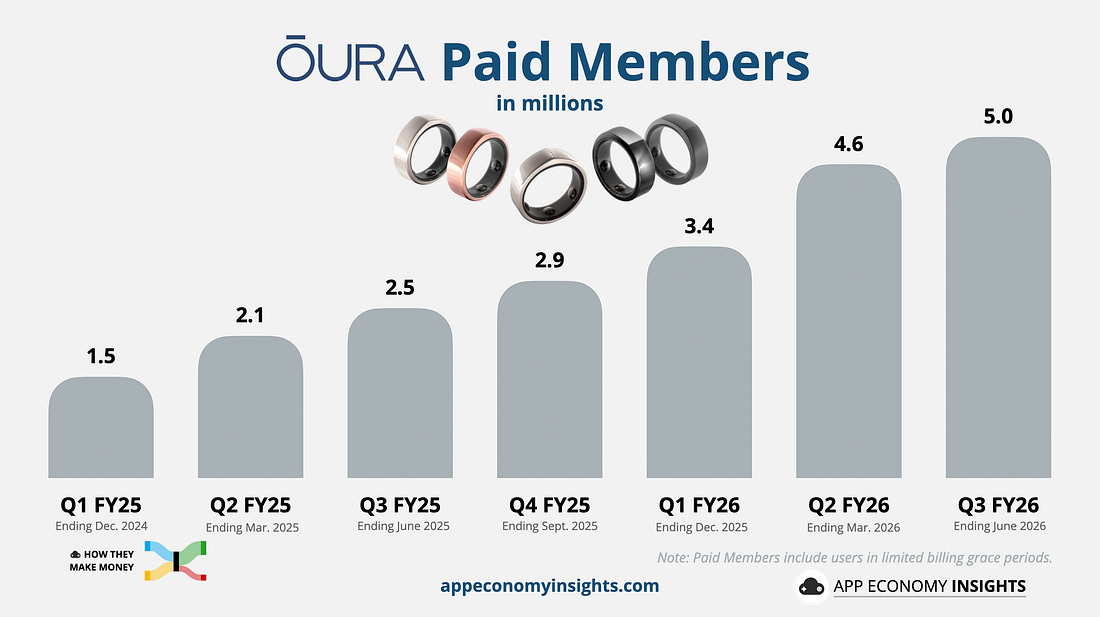
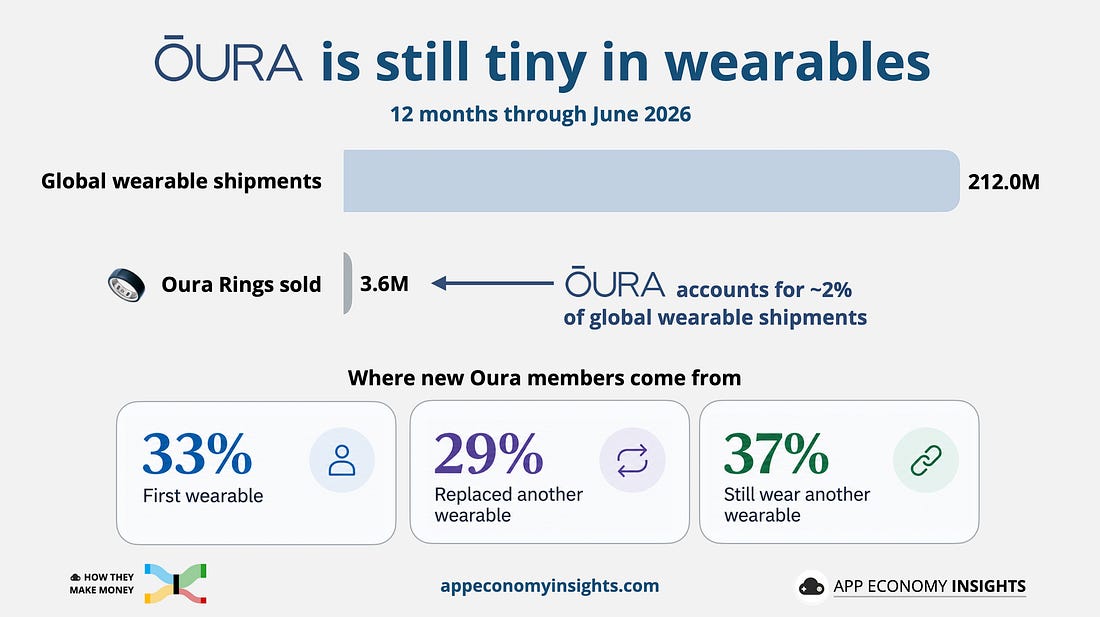
Выводы автора:
- Oura демонстрирует сильный финансовый рост (74% Y/Y) и прибыльность, но остаётся менее 2% глобального рынка носимых устройств, что указывает на огромный потенциал расширения категории
- Кольцо создаёт новую категорию носимых устройств, не вытесняя смарт-часы — пользователи либо не имели предыдущих трекеров, либо продолжают носить их параллельно
Палец — особенно хорошее место для измерения организма. По сравнению с запястьем, палец обеспечивает гораздо более сильный сигнал фотоплетизмографии.
Оригиналы:How Oura Makes Money
Коротко
ИИ и агенты
- Amvera Polide Agent — российский аналог Cursor и V0 с облачным хостингом – Облачная платформа Amvera запустила Polide Agent — ИИ-помощника для кодирования, позиционируемого как альтернатива V0, Replit, Bolt, Lovable и Cursor для российских пользователей.
- Сетевой сбой ChatGPT в РФ разрешился за 15 часов – 6 сентября 2026 года в России был зафиксирован сетевой сбой в доступе к ChatGPT, при котором соединение с chatgpt.com обрывалось ещё на этапе TLS Handshake, до обращения к серверам
Разработка и архитектура
- Почему CD и DVD деградируют: физика и условия разрушения оптических дисков – Статья разбирает, почему оптические диски (CD, DVD) не являются вечным носителем информации, вопреки первоначальным ожиданиям.
- Microsoft улучшает производительность Windows 11 на ПК с 8 ГБ ОЗУ – Microsoft объявила об оптимизации Windows 11 для лучшей работы на компьютерах с 8 ГБ оперативной памяти, что было анонсировано на выставке IFA 2026.
Финтех и финансы
- «Яндекс Go» запускает опцию дождаться такси со скидкой 30–50% – «Яндекс Go» внедрит новую опцию «Позже», которая позволяет пассажирам получить скидку 30–50% на поездку в обмен на ожидание такси в течение 30–40 минут.
Продукт и карьера
- Теренс Тао: от вундеркинда к величайшему математику современности – Биографический очерк о Теренсе Тао, одном из самых выдающихся математиков XXI века, который начал проявлять гениальные способности уже в семь лет.
Прочее
- Как за 23 года изменилось ночное освещение городов Земли: снимки с МКС – Астронавт НАСА Доналд Петтит в ходе четырёх космических миссий на протяжении 23 лет фотографировал крупные города Земли, документируя глобальный переход городского освещения с натр