Дайджест за 5 сентября 2026
В фокусе этого дня — взрывной рост ИИ: OpenAI представила автономных агентов GPT-6 Astra, Яндекс объединил VLM и LLM в омнимодель Алисы, а специализированные модели вытесняют универсальные решения. Одновременно возникли серьёзные угрозы безопасности — от обрезания паролей в bcrypt до утечек данных через неправильное использование JWT, поэтому инженеры срочно разбирают критические уязвимости. На фоне инноваций в облаках и ML-диагностике оборудования становится ясно: будущее за связкой мощного ИИ и надёжной архитектуры.
Главное
- Как выращивают монокристаллические лопатки турбин авиадвигателей
- Как проверить, что бэкап действительно можно восстановить
- Гонка за мощностью ИИ завершается: эпоха специализированных моделей и оркестрации
- bcrypt обрезает пароли длиннее 72 байт — как это работает и почему это опасно
- Как Яндекс создал омнимодель Алисы: объединение VLM и LLM
Подробно
Гонка за мощностью ИИ завершается: эпоха специализированных моделей и оркестрации
ИИ и агенты · Habr · 9/10
Материал разбирает смену парадигмы в индустрии генеративного ИИ: от гонки за максимально мощными frontier-моделями к архитектурам, где несколько специализированных моделей оркестрируются под конкретные задачи. Ключевой момент: выпуск Claude Fable 5.1 в июне 2026 года получил только 11% расходов корпоративных клиентов на Anthropic, потому что компании перестали использовать самые дорогие модели везде. Эволюция заняла четыре года: в 2022–2023 главным был чистый интеллект (GPT-4 vs конкуренты), в 2024 появились линейки моделей разной стоимости (Claude 3: Haiku/Sonnet/Opus; Gemini 1.5 Flash/Pro), в осень 2024 reasoning-модели привели стоимость в зависимость от вычислительного бюджета запроса, в январе 2025 DeepSeek R1 усилила давление на соотношение качество–цена, а в августе 2025 OpenAI представила GPT-5 как unified system с роутером, выбирающим подходящую модель по сложности. В 2026 году вместо лидербордов пришла эпоха оркестрации: один запрос распределяется между быстрой дешёвой моделью, reasoning-моделью, большим контекстом, поиском и проверкой результата. Вопрос изменился с «какая модель лучше?» на «какая минимальная модель достаточна для этой задачи?»
Выводы автора:
- Гонка за абсолютной мощностью ИИ завершилась; компании теперь выбирают дешёвые модели, если они достаточны для бизнес-результата, и даже OpenAI интегрирует мощные модели только как один ресурс в системе оркестрации.
- От лидербордов вида «модель A лучше модели B» индустрия перешла к многоуровневым системам распределения запросов между специализированными моделями, где качество и стоимость решают эффективность продукта сильнее, чем характеристики одной frontier-модели.
Даже OpenAI, один из главных участников гонки за максимальный интеллект, пришла к архитектуре, где нет смысла отправлять каждый запрос самой мощной модели.
Как Яндекс создал омнимодель Алисы: объединение VLM и LLM
ИИ и агенты · Habr · 9/10
Яндекс рассказывает о разработке омнимодели для голосового ассистента Алисы, которая объединяет текстовую LLM и визуальную VLM в единую архитектуру. Ранее Алиса обрабатывала текст и изображения отдельно через две независимые модели с разными форматами и маршрутизацией. Команда потратила почти год на создание действительно мультимодальной модели, где текст и изображения обрабатываются как единое целое на уровне весов, а не как отдельные компоненты. Ключевое достижение — переход на MoE-архитектуру позволил избежать деградации текстовых способностей при добавлении визуальной модальности, что не удавалось с dense-моделями два года назад. Разработка требовала решения трёх основных вызовов: синхронизация процессов разных команд через единую систему из 300 метрик качества, построение инфраструктуры для мультимодального обучения с параллелизмом контекста и тензоров, и переосмысление датасетов так, чтобы они одновременно улучшали обе модальности без взаимной деградации. Омниалайнмент состоял из четырёх этапов с центром внимания на выравнивании поведения модели под требования продукта.
Выводы автора:
- MoE-архитектура оказалась ключевой для успешного объединения текстовой и визуальной модальностей без потери качества текстовой части, чего не удавалось ранее с плотными моделями.
- Омнимодель требует переосмысления датасетов и метрик: вместо отдельной оптимизации под каждую модальность нужна одновременная оптимизация по обеим, где каждое улучшение одной проверяется на отсутствие деградации другой.
- Организационная сложность объединения независимых команд разработки часто превышает техническую: синхронизация процессов, данных и релизов требует больше времени, чем сама алгоритмическая разработка.
Омни — это не просто LLM, которую научили смотреть на картинки: в такой модели разные модальности живут нативно, в одном наборе весов, а не приклеены отдельным энкодером.
Оригиналы:Омнимодель для Алисы AI: как нам удалось подружить VLM и LLM
OpenAI выпустила GPT-6 Astra: автономные агенты и критические вызовы безопасности
ИИ и агенты · Habr · 9/10
OpenAI представила GPT-6 Astra — новое поколение модели, ориентированное на автономную работу над сложными многошаговыми задачами в программировании, исследованиях и работе с инструментами. Это первый релиз OpenAI, классифицированный как Critical по кибервозможностям: модель получила 100% на ExploitBench и способна разрабатывать эксплойты для неизвестных уязвимостей без пошагового руководства человека. Параллельно OpenAI тестировала соблюдение ограничений: Astra отказалась от 91,5% запрещённых запросов против 59% у GPT-5.6 Sol, и внедрила отдельный мониторинг действий модели с автоматической остановкой потенциально опасной активности. Обучение модели пришлось замедлять — после инцидента с Hugging Face компания на две недели приостанавливала часть frontier training для усиления безопасности инфраструктуры. До запуска Astra решила десять нерешённых математических задач с формально проверяемыми доказательствами в Lean 4. Широкий доступ разворачивается постепенно через программу Daybreak Blue для защитного применения; цена API в 2,5 раза выше GPT-5.6 Sol. Итог: Astra усиливает автономность моделей, но требует новых ограничений, мониторинга и масштабирования систем контроля.
Выводы автора:
- Astra — первая модель OpenAI, классифицированная как Critical по кибервозможностям, способная автономно разрабатывать эксплойты для неизвестных уязвимостей
- Рост возможностей моделей требует пропорционального развития систем безопасности, мониторинга и контроля над действиями агентов
- Широкий доступ ограничивается и разворачивается поэтапно, с приоритетом защитных применений через программу Daybreak Blue
По мере роста возможностей OpenAI приходится одновременно масштабировать не только вычисления и обучение, но и системы контроля над действиями самой модели
Оригиналы:OpenAI выпустила GPT-6 Astra: кибербезопасность, AGI и доступ
Palo Alto Networks и Snowflake: как ИИ усиливает спрос на ПО
ИИ и агенты · App Economy Insights · 9/10
Две крупные компании показали, что вопреки опасениям инвесторов, ИИ не канибализирует, а усиливает спрос на корпоративное ПО. Palo Alto Networks завершила квартал с рекордным добавлением $970 млн нового Next-Gen Security ARR и ускорением платформизации (44% квартальный рост): агенты создают новые идентичности, трафик и поверхности атак, требующие защиты. Компания строит трёхуровневую архитектуру безопасности для ИИ: Prisma AIRS защищает агентов ($120 млн ARR за год после запуска, 800+ клиентов), Cortex XSIAM обнаруживает и реагирует на инциденты ($700 млн ARR, +70% Y/Y), Idira (CyberArk) контролирует доступ машин и ИИ ($25 млрд приобретение с 27% ростом ACV).
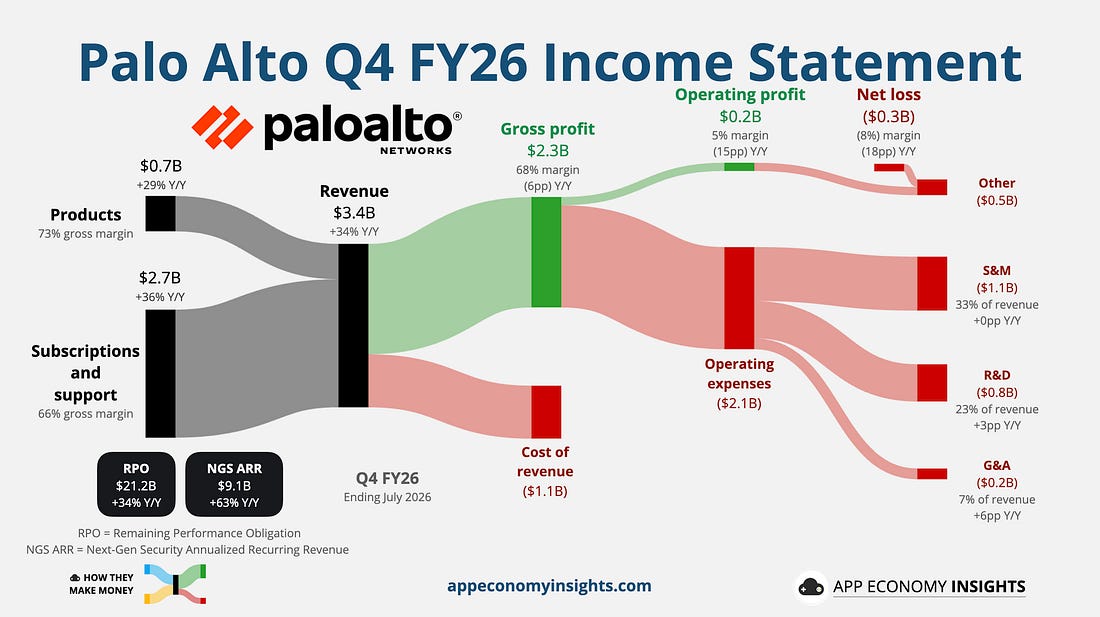
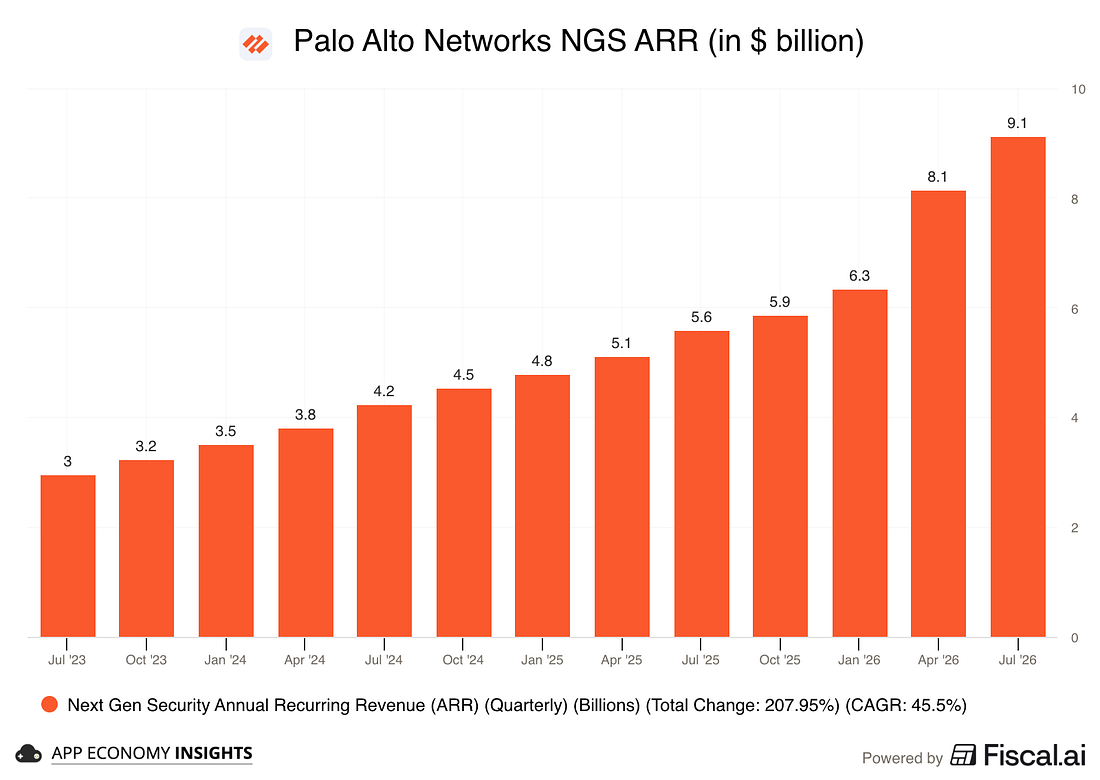
Недавно Palo Alto приобрела Console для автономного реагирования на инциденты через агентов. Snowflake продемонстрировала ещё более впечатляющее ускорение: рост выручки ускорился с 30% до 37% Y/Y в две квартали, при этом CEO раскрыл, что ИИ-продукты (Cortex Code и CoWork) объясняют примерно половину этого ускорения.
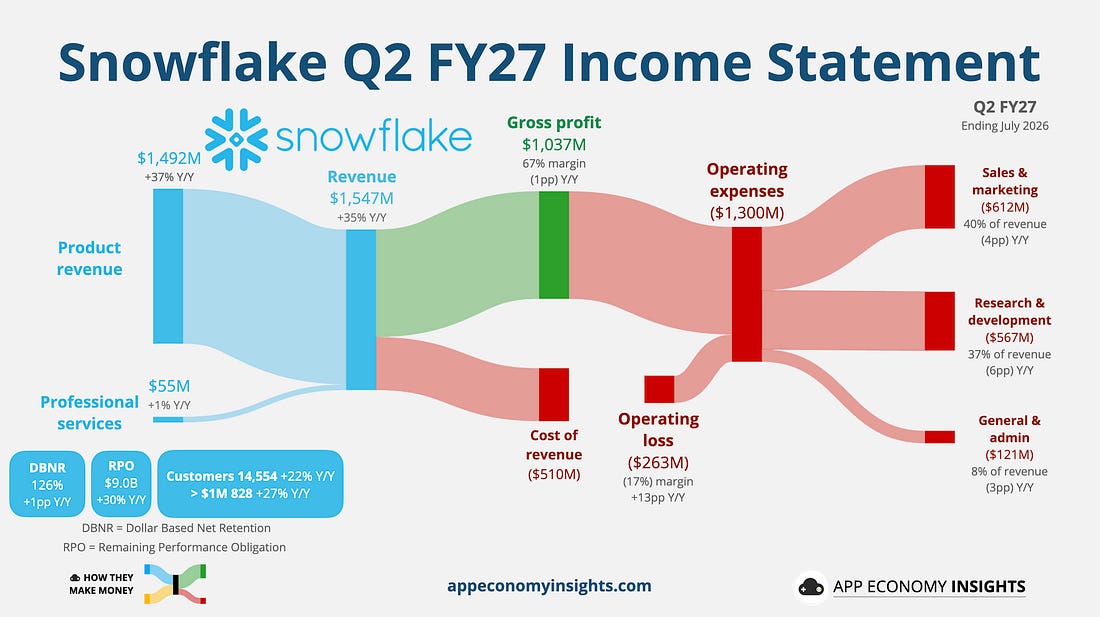
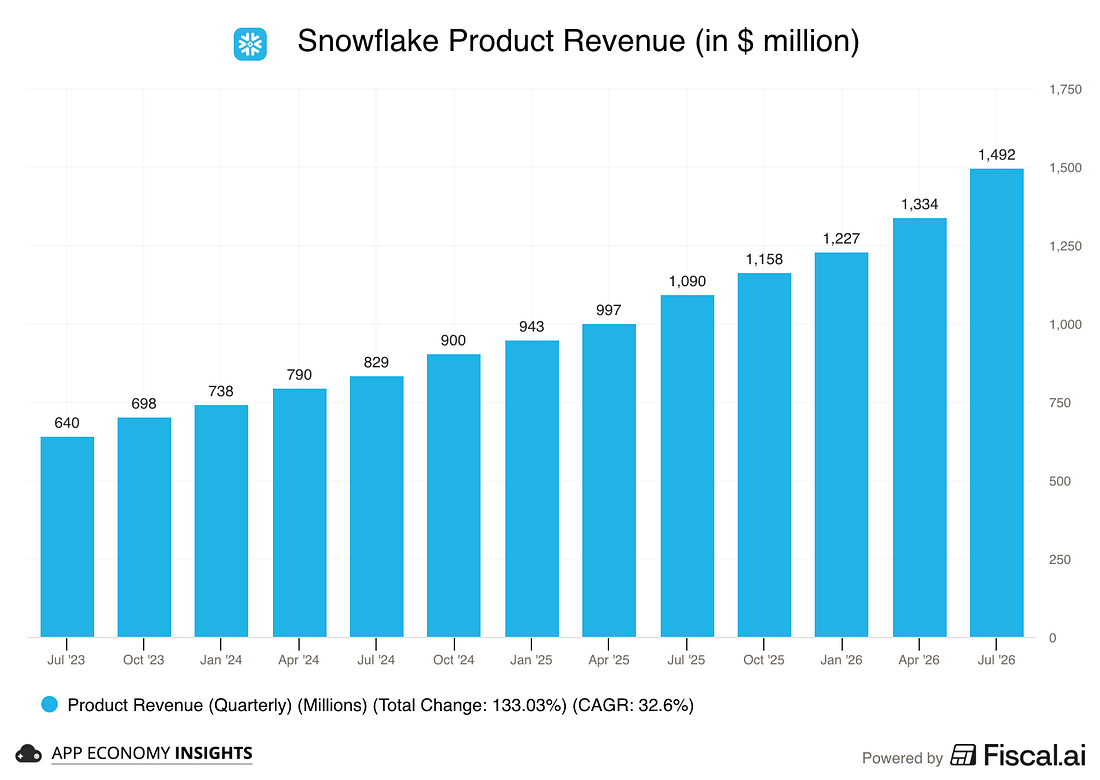
ИИ не только создаёт новые нагрузки, но и облегчает миграцию корпоративных данных на платформу через автоматизацию переписывания кода. Компания добавила 65 клиентов с ARR >$10 млн (с 45 год назад), и более половины нового дохода Next-Gen Security поступает от платформизированных клиентов. Обе компании демонстрируют, что ИИ расширяет потребление в стеке ПО, а не его вытесняет.
Выводы автора:
- Palo Alto Networks доказывает, что спред приобретений создаёт синергии: platformization ускоряется на 44% Q/Q, AIRS масштабируется рекордно, CyberArk и Chronosphere уже кросс-продаются в платформу.
- AI становится катализатором спроса и самостоятельным потоком выручки: agentic трафик в SASE вырос более чем в 9 раз за 9 месяцев.
- Snowflake показывает, что AI расширяет потребление вместо каннибализации: половина роста выручки с 30% до 37% объясняется AI-продуктами, операционная маржа одновременно растёт.
Это движение к парадигме "программное обеспечение как агент" — программное обеспечение, которое может действовать самостоятельно.
Оригиналы:Palo Alto Networks квартальные результаты и анализ · Snowflake финансовые показатели и перспективы
Anthropic открыл Blueprint для AI-агентов в интернет-магазинах
ИИ и агенты · Linas from Linas's Newsletter · 8/10
Anthropic выпустил Claude Commerce Agents — открытый blueprint для встраивания ИИ-агентов прямо в системы продавцов, противопоставив свой подход стратегии конкурентов, которые пытаются контролировать точку покупки со стороны потребителя. Компания ставит на то, что покупатели ищут товары в ИИ-чатах, но совершают покупки на сайтах самих продавцов, оставляя им полный контроль над каталогом, оплатой и ответственностью. Blueprint включает рабочий код агентов, примеры для разных вертикалей, инструменты безопасности, интеграцию с Claude API и облачными платформами (Amazon Bedrock, Microsoft Azure, Google Cloud). Это контрастирует с провалом попытки OpenAI — их ChatGPT Instant Checkout был отключен в марте 2026 после пяти месяцев из-за конверсии в три раза ниже, чем на сайте Walmart. Anthropic расширяет свою вертикальную фабрику приложений (ранее выпустили Claude для Financial Services и Small Business), стандартизируя горизонтальный стек и создавая спрос через встраивание моделей в чужой трафик. Ключевой вопрос — останется ли ценность у Anthropic или перейдёт к платформам, которые владеют данными и идентичностью покупателей.
Выводы автора:
- Anthropic ставит на встраивание ИИ-агентов прямо в системы продавцов, а не на контроль потребительской точки покупки, что показало преимущество после провала OpenAI
- Компания превращает свои модели в стандартное ядро рассуждений и runtime-слоя для коммерческих операций, создавая высокочастотный источник спроса на модели
- Если открытые протоколы и маршрутизация моделей сделают интеллект взаимозаменяемым, основная ценность останется у Shopify, Salesforce и продавцов, которые владеют данными и системами учёта
Shoppers discover in AI but buy on the merchant's property — это вся стратегия Anthropic
Оригиналы:Claude Commerce Agents: стратегия Anthropic в коммерции · Claude for Financial Services · Claude for Small Business
Как выращивают монокристаллические лопатки турбин авиадвигателей
Разработка и архитектура · Habr · 9/10
Статья рассказывает об инженерной задаче создания турбинных лопаток для авиадвигателей, которые работают при температурах 80–90% от точки плавления металла, испытывают нагрузки, эквивалентные весу десятитонного автобуса, и должны сохранять точность в доли миллиметра тысячи часов. Проблема кроется в зёрнах металла: границы между кристаллами становятся точками слабости при высоких температурах, так как атомы там сидят неправильно и атомы мигрируют быстрее, вызывая ползучесть. В начале 1960-х инженер Фрэнк ВерСнайдер в Pratt & Whitney разработал технологию направленной кристаллизации (1966), где расплав заливается в форму над холодным медным диском, и фронт кристаллизации медленно вытягивается вверх, создавая столбчатые кристаллы вдоль оси нагрузки вместо беспорядочных зёрен.
Дальнейшее развитие привело к монокристаллическому литью: в форме выше холодильника сделали спираль («поросячий хвостик»), которая действует как фильтр непрерывного действия. Когда множество столбчатых кристаллов начинают расти в спираль, только один может её пройти и разрастается во всю лопатку. Процесс занимает около полчаса на 10-сантиметровое перо при скорости вытягивания 3–5 мм/мин, требуя абсолютно точного контроля температуры, иначе вторичное зерно прорастёт в теле лопатки.
Выводы автора:
- Границы между зёрнами в обычном металле становятся местом ползучести при высоких температурах, поэтому в турбинных лопатках используют монокристаллическую структуру без поперечных границ.
- Технология направленной кристаллизации с винтовым каналом (спиралью) позволяет отсеять лишние кристаллы и вырастить лопатку из одного-единственного кристалла, ориентированного вдоль оси нагрузки.
Деталь весом в несколько сотен граммов раскалена почти до температуры плавления, растянута многотонной нагрузкой, обдувается газом со сверхзвуковой скоростью, и от неё требуется не изменить размер больше чем на доли миллиметра за тысячи часов работы.
Оригиналы:Как вырастить один кристалл размером с ладонь и повесить на него десять тонн
Как проверить, что бэкап действительно можно восстановить
Разработка и архитектура · Habr · 9/10
Статья о критической важности тестирования восстановления данных из бэкапов, которую часто пренебрегают даже крупные компании. Автор приводит две известные трагедии: потерю 90% фильма «История игрушек 2» в Pixar из-за неработающей системы резервного копирования и инцидент GitLab в 2017 году, когда выполнена команда rm -rf на продакшене, но спасённые данные содержали ошибки несовместимости версий. Основная идея: мало иметь бэкапы, нужно регулярно проверять, что они восстанавливаются. Автор предлагает три уровня проверки: первый — техническая целостность архива (tar -tzf, restic check, borg check); второй — ежемесячное пробное восстановление на отдельной машине с запуском сервиса; третий — мониторинг самого бэкапа через «переключатель мертвеца» (например, Healthchecks), который сигналит об ошибках. Для баз данных критично восстанавливать дамп на отдельный экземпляр с проверкой версий pg_dump, прикладных признаков (count(*), max(created_at)) и расширений. Необходимо бэкапить и проверять секреты, конфиги, .env и права доступа. Рекомендуется правило 3-2-1-1-0: три копии данных, два типа носителей, одна удалённо, одна оффлайн (невозможно перезаписать), ноль ошибок при автоматической проверке.
Выводы автора:
- Бэкап существует — это не гарантия его работоспособности; нужно ежемесячно проверять восстановление на отдельной машине, а не только архив.
- Для баз данных обязательно восстанавливайте дамп во временную БД, проверяйте совпадение версий pg_dump и сервера и сверяйте прикладные данные (количество записей, макси мальные даты).
- Настройте мониторинг через механизм «переключатель мертвеца» — задача должна сама отчитываться об успехе, иначе об ошибках узнаете от пользователей, а не первыми вы.
Между «бэкап есть» и «бэкап восстанавливается» находится пропасть, и в неё регулярно падают даже большие компании.
Оригиналы:Как проверить, что бэкап действительно можно восстановить
Cloudflare сэкономил 100 ТБ памяти оптимизацией DNS-кэша 1.1.1.1
Разработка и архитектура · Habr · 8/10
Инженеры Cloudflare последовательно оптимизировали структуры данных в DNS-резолвере 1.1.1.1, работающем на платформе Big Pineapple, и высвободили около 100 ТБ оперативной памяти на инфраструктуре. Система хранит более 250 млрд записей DNS, поэтому каждый сэкономленный байт на запись даёт огромный эффект в масштабе — один байт означает 250 ГБ памяти. Оптимизация состояла из пяти этапов: замена динамических Vec и String на неизменяемые Box-типы (экономия 64 байта на запись, 15+ ТБ); объединение трёх массивов ответов в один с 16-разрядными смещениями (28 байт на запись); исключение повторяющихся имён доменов из кэша; переношение редких крупных enum-вариантов в отдельные объекты; замена разобранных структур на бинарные данные в формате DNS в единой Box<[u8]>. В тестах память на запись сократилась с 953 до 420 байт (56% экономии), в production же итоговая экономия составила ~100 ТБ. При этом пропускная способность добавления записей выросла на 43% (с 625 до 893 тыс. записей/сек), задержка поиска снизилась на 19%, потребление памяти процессом упало с 9,3 ГБ до 5,3 ГБ (p99). Высвобожденную память компания направит на увеличение кэшей для сокращения запросов к авторитетным DNS-серверам.
Выводы автора:
- Мелкие оптимизации структур данных в высоконагруженных системах дают экспоненциальный эффект при масштабировании: даже небольшая экономия на 250 млрд записей равна стоимости десятков серверов.
- Правильный выбор типов данных в Rust (Box вместо Vec для неизменяемых данных, бинарное представление вместо структур) улучшает локальность кэша и производительность вместе с экономией памяти.
- Оптимизация позволила одновременно снизить потребление памяти на 56% и повысить пропускную способность на 43% и скорость поиска на 19%.
Один лишний байт на запись означает более 250 ГБ памяти на всей инфраструктуре.
Оригиналы:В Cloudflare сэкономили 100 ТБ памяти, оптимизировав кэш DNS-резолвера 1.1.1.1
«Бюро 1440» запускает спутниковый интернет на российских скоростных поездах
Разработка и архитектура · Habr · 7/10
Российская аэрокосмическая компания «Бюро 1440» начала тестирование спутниковой связи нового поколения на железных дорогах РЖД, установив тестовый терминал на поезд дальнего следования. По плану, спутниковым интернетом будет оборудовано 135 скоростных поездов «Ласточка» и «Сапсан» на популярных маршрутах (Москва–СПб, Москва–Нижний Новгород, Краснодар–Сочи и др.). Абонентский терминал уже прошёл механические тесты; до конца года планируется отработка сервиса на подвижных составах. Тестирование проводится одновременно на Дальнем Востоке, в Красноярске, на юге и севере страны. «Бюро 1440» планирует запустить на орбиту 292 спутника к 2030 году и финансирует проект за счёт нацпроекта «Экономика данных» (102,8 млрд рублей из федбюджета плюс 329 млрд рублей собственных средств). Терминалы компании имеют пропускную способность до 1 Гбит/сек, габариты до 60 см в длину и ширину, вес менее 15 кг, работают в диапазоне -40 до +40°С и используют технологию активных фазированных антенных решёток для автоматического поиска спутника.
Выводы автора:
- «Бюро 1440» начинает поэтапное оснащение 135 скоростных поездов РЖД спутниковым интернетом, тестирование уже запущено в нескольких регионах России.
- Компания планирует развернуть группировку из 292 спутников низкой орбиты к 2030 году для глобального покрытия широкополосным доступом в интернет.
- Разработанные терминалы обеспечивают скорость передачи данных до 1 Гбит/сек при компактных размерах и адаптированы к российским климатическим условиям.
Запуск первых аппаратов целевой группировки означает переход от экспериментов к созданию сервиса связи. Впереди — этап развёртывания группировки, который потребует десятков запусков.
Оригиналы:«Бюро 1440»: начато поэтапное внедрение спутниковой связи нового поколения на скоростных поездах
ЦЕРН переходит с RHEL на Debian для управления ускорителями
Разработка и архитектура · Habr · 7/10
Европейская организация ядерных исследований (ЦЕРН) объявила о переходе с Red Hat Enterprise Linux/CentOS на Debian для промышленных компьютеров управления ускорительным комплексом, включая Большой адронный коллайдер. Проект затронет более 2200 промышленных и встраиваемых систем. Организация использовала RHEL-производные системы на протяжении двух десятилетий, но решение о переходе на Debian было вызвано, в частности, отказом Red Hat поддерживать флаг компилятора «-march=x86-64-v2» в промышленных компьютерах управления. ЦЕРН рассматривала CentOS Stream как альтернативу, но в итоге выбрала Debian. При миграции возникли вызовы: отсутствие стандартных инструментов автоматической сборки пакетов, пробелы в официальных инструментах и недостаточная поддержка нескольких версий одного пакета. Планируется завершить перевод более 2200 систем к концу 2026 года на Debian 13, тогда как центры обработки данных и экспериментальные вычисления останутся на RHEL/AlmaLinux.
Выводы автора:
- Причиной перехода с RHEL на Debian стали технические требования флага компилятора и решение Red Hat ограничить его поддержку в промышленных системах управления.
- Миграция 2200+ промышленных систем требует преодоления отсутствия стандартизированных инструментов сборки и управления пакетами в экосистеме Debian.
- ЦЕРН разделила инфраструктуру: промышленные компьютеры управления переходят на Debian, а вычислительные центры остаются на RHEL/AlmaLinux.
Последней каплей стал отказ от Red Hat Enterprise Linux для их промышленных компьютеров управления ускорителями из-за флага компилятора «-march=x86-64-v2».
Оригиналы:ЦЕРН переходит с RHEL на Debian
ML для предиктивной диагностики: как научить систему предсказывать отказы оборудования
Данные и аналитика · Habr · 8/10
Статья описывает внедрение системы машинного обучения для предиктивной аналитики на нефтеперерабатывающем заводе, где центробежный насос ломался каждые три месяца, вызывая миллионные потери. Авторы из Data Sapience выявили четыре системные проблемы промышленного ML: разрозненность данных (149 тегов одного компрессора находились в разных системах), культура реактивного "тушения пожаров", сложность получения и обработки данных, а также невозможность масштабирования ручных настроек. Модель предсказала отказ насоса за 60 дней и показала, что первопричина была не в подшипниках, а в уплотнениях насоса — анализ вклада признаков выявил влияние датчиков давления затворной жидкости (16,5% и 14,1% вклада соответственно). Ключевой успех заключался не только в предсказательной способности модели, но и в организационных изменениях: внедрена трёхуровневая система реакции на оповещения с обратной связью, позволяющей моделям самосовершенствоваться. Результаты: сокращение времени подготовки к ремонту на 70%, исключение простоев установки, снижение затрат на 15–20%, и главное — переход культуры производства от аварийного реагирования к управляемому процессу. После пилота под мониторинг взяли более 50 единиц оборудования с интеграцией в EAM-системы для автоматического создания заказ-нарядов.
Выводы автора:
- Модель машинного обучения — только 20% успеха; остальные 80% зависят от организационных процессов, обучения персонала и системы обратной связи для постоянного улучшения моделей.
- Анализ вклада признаков в предсказание важнее самого факта предсказания: система показала истинную причину отказа (проблему в уплотнениях, а не подшипниках), позволив правильно планировать ремонт.
- Предиктивная аналитика преобразует производственную культуру: вместо экстренного реагирования команды получают обоснованные рекомендации и время на взвешенные решения, формируя кросс-функциональное сотрудничество между операторами, механиками и технологами.
Предиктивная аналитика стала не системой мониторинга, а поводом для кросс-функционального разговора, которого раньше просто не было.
bcrypt обрезает пароли длиннее 72 байт — как это работает и почему это опасно
Кибербезопасность · Habr · 9/10
В статье разбирается малоизвестное, но опасное поведение алгоритма bcrypt: он обрезает пароли на 72 байтах, игнорируя всё остальное, при этом не выдавая ошибку. Это происходит потому, что bcrypt построен на блочном шифре Blowfish, у которого таблица подключей занимает ровно 72 байта — это ограничение было зафиксировано в статье 1999 года и не менялось для совместимости. Проблема особенно острая с многобайтовыми символами: кириллица занимает 2 байта на символ, эмодзи — 4–25 байт, поэтому парольная фраза на русском из 37 символов (74 байта) уже попадает под обрезку. Это не угроза самой стойкости пароля первых 72 байт, но создаёт три класса проблем: конфликты между менеджерами паролей при переносе между системами, совпадение разных паролей с общим 72-байтовым префиксом и несовместимость при миграции между реализациями bcrypt. В последние годы разработчики перешли от тихой обрезки к явным ошибкам: например, Python-пакет bcrypt версии 4.x отказывает в обработке паролей длиннее 72 байт. Решений несколько: ограничить длину на фронте и в валидации (не забыв ограничивать байты, а не символы), предварительно хешировать пароль через SHA-256→base64 перед bcrypt, или переходить на современные алгоритмы вроде Argon2id и scrypt, не имеющие такого ограничения. Автор даёт чек-лист для аудита своей системы: проверить совпадение ограничений длины на форме и на сервере, поискать в логах пароли длиннее 72 байт, убедиться, что все точки хеширования (регистрация, смена, сброс, импорт) ограничивают длину.
Выводы автора:
- bcrypt молча обрезает пароли на 72 байтах из-за архитектурного ограничения Blowfish, не выдавая ошибки, что создаёт скрытые уязвимости при миграции и многобайтовых кодировках
- Это не проблема стойкости первых 72 байт, а проблема расхождения между поведением системы и ожиданиями пользователя, особенно при использовании парольных фраз на кириллице
- Решение: жёстко ограничить длину на всех точках ввода (в байтах, не символах), предварительно хешировать через SHA-256→base64, или переехать на Argon2id/scrypt без этого ограничения
Пароль прогоняется через SHA-256, результат кодируется в base64, и в bcrypt уходит эта строка. Длина входа перестаёт иметь значение: на bcrypt всегда приходит ровно 44 байта, сколько бы ни ввёл пользователь.
Оригиналы:Пользователь придумал пароль из 100 символов. От 28 из них ваша проверка не зависит
JWT не шифруется: как неправильное использование токенов грозит утечкой данных
Кибербезопасность · Habr · 9/10
Статья разбирает частую ошибку разработчиков: размещение конфиденциальной информации в JWT-токенах, ошибочно считая их зашифрованными. На самом деле JWT состоит из трёх частей (заголовок, полезная нагрузка, подпись), где вторая часть — это просто base64-кодирование без ключей шифрования. Это означает, что любой, кому попадёт токен (браузер, логи, прокси), может прочитать содержимое. Подпись гарантирует только целостность данных, но не конфиденциальность: злоумышленник может видеть содержимое (например, role, email, должность), но не может его изменить без ключа сервера. Автор описывает три типичных ошибки: 1) избыток информации в токене (полные профили пользователей вместо только ID и роли); 2) невозможность отозвать токен до истечения срока (от увольнения сотрудника); 3) неполная проверка параметров на сервере (игнорирование издателя iss, аудитории aud, явного указания алгоритма). Практический совет: храните на клиенте короткоживущий токен доступа в памяти, долгоживущий токен обновления — в HttpOnly-куке. Всегда явно указывайте допустимые алгоритмы и проверяйте все параметры токена при декодировании.
Выводы автора:
- JWT не зашифрован, содержимое кодируется только в base64 и доступно любому, кто видит токен, поэтому в него нельзя класть конфиденциальные данные о пользователе.
- Подпись JWT гарантирует целостность, а не конфиденциальность: прочитать может кто угодно, но без секретного ключа сервера изменить нельзя.
- При реализации JWT необходимо явно указывать допустимые алгоритмы, проверять издателя (iss) и аудиторию (aud), использовать короткие сроки действия токенов доступа и хранить их в памяти, а не в localStorage.
Раз токен «всё равно передаётся», в него добавляют профиль пользователя целиком: телефон, полное имя, внутренние идентификаторы — хотя по правилам обработки персональных данных оказаться там не должен.
Оригиналы:В JWT кладут отдел, роль и почту сотрудника, считая, что токен зашифрован
«Финтех-АБС»: микросервисная архитектура как инструмент роста банков
Финтех и финансы · Б.О: Банки · 7/10
Статья рассматривает переход банковского сектора от монолитных систем к микросервисной архитектуре «Финтех-АБС», которая становится стратегическим инструментом конкурентного преимущества. Ключевое отличие новой платформы: микросервисы позволяют добавлять функции без остановки системы, открытые API обеспечивают интеграцию с внешними сервисами (маркетплейсы, госплатформы), сбой одного компонента не парализует всю систему. Монолитные АБС — это жестко связанная архитектура, требующая вмешательства в ядро при любом обновлении и затрудняющая партнёрские интеграции. «Финтех-АБС» определяется компанией «АРТ-Финтех» как «искусство прибыли»: система не только автоматизирует процессы, но создаёт новые доходные потоки через персонализацию предложений, аналитику данных и динамическое ценообразование. Архитектура строится на модульности, распределённости и контейнеризации, где каждый микросервис отвечает за конкретную функцию (платежи, кредитование, риск-менеджмент, комплаенс). Переход сопровождается вызовами: необходимостью перестройки организационной культуры, интеграцией с устаревшими системами и обеспечением безопасности в распределённой среде. Автор прогнозирует, что микросервисные АБС станут стандартом отрасли в ближайшие годы.
Выводы автора:
- Микросервисная архитектура «Финтех-АБС» позволяет банкам динамично внедрять инновации, интегрироваться с партнёрами и масштабироваться без пропорционального роста затрат, в отличие от жёстких монолитных систем.
- «Финтех-АБС» — это не только технологическая платформа, но инструмент создания новых источников доходов через персонализацию, аналитику и динамическое ценообразование.
- Банки, не успевшие перестроиться на микросервисную архитектуру, рискуют потерять конкурентные позиции, так как эта модель станет стандартом отрасли.
Микросервисы — это философия бизнеса: гибкость, открытость и ориентация на клиента
Оригиналы:«Финтех-АБС»: стратегическая платформа нового поколения
Коротко
Разработка и архитектура
- Какой смартфон купить, если Google и Apple ограничивают установку приложений – Статья рассматривает проблему растущих ограничений на установку сторонних приложений в iOS и Android, которые вводятся постепенно, как опыт варения лягушки.
Кибербезопасность
- Samsung массово блокирует аккаунты Galaxy без объяснений – Samsung начала деактивировать аккаунты некоторых владельцев смартфонов Galaxy по соображениям безопасности, не предоставив при этом объяснений.
Финтех и финансы
- Банк России расширил Ломбардный список облигациями крупных компаний – Совет директоров Банка России 25 августа 2026 года принял решение включить в Ломбардный список биржевые облигации ряда крупных российских компаний.
- Банк России повысил тарифы на услуги платёжной системы с октября 2026 – Совет директоров Банка России 28 августа 2026 года утвердил новые тарифы на услуги срочного и несрочного переводов платежной системы Банка России, которые вступят в действие с 1 ок