Дайджест за 2 сентября 2026 (пересборка)
Токены для ИИ дорожают как хлеб в войну, а видеокарты задыхаются от нехватки памяти — разбираемся, во что это обойдётся разработчикам. Параллельно тестируем Devin, нейросеть, которая притворяется программистом, и смотрим, может ли она на самом деле писать код без присмотра. А ещё у России появляется цифровой рубль, европейские банки воюют ИИ-ассистентами за клиентов, и в истории учимся, почему консервативные компании вымирают вроде Digital Equipment.
Главное
- Константа сломалась: токены дорожают, память съедает 90% кремния GPU
- Как спроектировать домашнюю проводную сеть перед ремонтом
- PereStruct: открытый парсер для восстановления структуры исторических газет
- Как правильно убивать игроков в играх: нейросеть против игроков
- Аудит биометрических замков: от скрепки к микросхемам
Подробно
Константа сломалась: токены дорожают, память съедает 90% кремния GPU
ИИ и агенты · Habr · 9/10
ML-дайджест о крутом повороте в экономике ИИ-инфраструктуры: два года предполагалось, что цены будут падать каждый квартал, но в августе константа сломалась сразу по трём фронтам. DeepSeek повысила API-цены на 355–371% в пиковые часы и внедрила тарификацию по времени суток. Micron показала, что в двухкристальных GPU-сборках память займёт около 90% площади кремния и стоит впятеро дороже DDR5 за бит; HBM4 продаётся по 31–36$ за гигабайт. Тепловая нагрузка между поколениями HBM выросла в 2,2 раза, потолок толщины стека поднялся до 775 микрон. На конференции Hot Chips 2026 вендоры показали новые архитектуры: NVIDIA представила Vera Rubin NVL72 с жидкостным охлаждением при 45°C без чиллеров, AMD выпустила MI455X с 432 ГБ HBM4, Google разделила обучение и инференс по разным TPU (v8t и v8i).
Одновременно китайские лаборатории выложили открытые веса на 1,7–2,4 триллиона параметров: Qwen3.8-Max (2,4 трлн, условная лицензия), DeepSeek V4-Pro (1,7 трлн, MIT), GLM-5.3-Flash (320 млрд, нативно мультимодальная, MIT). Память теперь — основная статья расходов для локального инференса, оптимизация KV-кэша из дополнения стала критической необходимостью.
Выводы автора:
- Экономический слом: цены на токены и память растут, а не падают; HBM4 стоит впятеро дороже DDR5 за бит, занимает 90% кремния GPU и продана до конца 2026 года.
- Memory Wall превратился в системное ограничение: разрыв между скоростью процессоров и пропускной способностью памяти расширяется каждое поколение, требуя фокуса на оптимизацию KV-кэша.
- Новые архитектуры (Vera Rubin, MI455X, TPU v8) решают проблему пропускной способности памяти и интерконнектов, а не арифметики; все инженерные решения касаются перемещения данных.
Память занимает около 90% площади кремния в двухкристальных GPU-сборках и стоит впятеро дороже DDR5 за бит.
PereStruct: открытый парсер для восстановления структуры исторических газет
ИИ и агенты · Habr · 8/10
Яндекс разработал PereStruct — модульный пайплайн для автоматического разбора советских газет, который восстанавливает логическую структуру страниц и объединяет разрозненные текстовые блоки в цельные статьи. Задача сложна тем, что один только OCR недостаточен: исторические газеты имеют нестандартную вёрстку, выцветшие страницы, просвечивающий текст и иные физические дефекты, поэтому нужна цепочка связанных этапов — детекция блоков, распознавание текста, коррекция ошибок и семантическая сборка. Пайплайн состоит из четырёх этапов. Первый использует доменно-адаптированный YOLOv10 для выделения элементов вёрстки (заголовки, текст, изображения, подписи), достигнув mAP50 0,981 на тесте. Второй отправляет вырезанные области в Yandex Vision OCR, сохраняя связь текста с координатами. Третий применяет LLM-коррекцию с жёстким промптом, чтобы исправить только явные ошибки распознавания, не переписывая архивный материал современным языком. Четвёртый решает бинарную классификацию пар блоков (относятся ли они к одной статье) через XGBoost на мультимодальных признаках: текстовые n-граммы (TF-IDF), геометрия и визуальный эмбеддинг из YOLO. Для обучения команда разметила 1426 страниц советских газет 1934–1969 годов из библиотеки имени Некрасова; 599 страниц опубликованы открыто на Zenodo под CC BY 4.0. Авторы показали предварительное сравнение: модульный пайплайн превосходит попытку использовать большие VLM напрямую на этой задаче. Проект возник из сотрудничества Яндекса, студкемпа Яндекс Образования и Института химии РАН и демонстрирует, как ценность создаётся не из одного алгоритма, а на стыке разных компетенций и облачных сервисов.
Выводы автора:
- Модульный пайплайн с разделением задачи на отдельные этапы (детекция, OCR, коррекция, классификация пар) оказывается эффективнее, чем применение единой большой VLM для восстановления структуры исторических документов.
- Ключевой инновацией является свёртывание задачи сборки статей к бинарной классификации пар блоков вместо предсказания полного порядка, что снижает сложность и улучшает результаты.
- При работе с архивными источниками LLM должна выполнять узкую сервисную функцию (исправление явных OCR-ошибок), а не редактирование текста, чтобы сохранить историческую аутентичность.
Даже если все слова распознаны правильно, ещё нужно определить, какие фрагменты относятся к одной статье и в каком порядке их читать.
Оригиналы:Где VLM не читали старых газет: разбираем PereStruct, открытый датасет и модульный парсер · Open source
Как правильно убивать игроков в играх: нейросеть против игроков
ИИ и агенты · Habr · 8/10
Статья описывает многолетний проект разработчика, который создал нейронную сеть для управления противником в военной тактической игре Arma 3. Автор начал с простых ботов на конечных автоматах, но столкнулся с ограничениями стандартных подходов и решил применить машинное обучение. Red Queen (Красная Королева) — нейросеть, которая работает командиром стороны противника и управляет группами ботов, получая рапорты и отправляя приказы с ограничениями по пропускной способности, как реальный КС. За 2014–2018 годы проект эволюционировал от простой RNN (v1) к двухголовой BI-LSTM архитектуре (v4), обучаясь на данных реальных боёв. На пути пришлось решать проблемы: катастрофическую забывчивость сети при неправильных данных («атака тупостью»), необходимость вводить механики допусков для техники, противодействие найденным сетью тактикам (минирование трупов, химическое оружие). Процесс строился по принципу «боль и унижения» — когда игроки начинали побеждать, сеть усложнялась.
Проект был закрытым, с верификацией игроков, так как публичные паблик-игроки выдавали плохие обучающие данные. Автор подробно рассказывает о технических ограничениях языка SQF движка, архитектуре сети и эволюции игровых сценариев.
Выводы автора:
- Для эффективного обучения нейросети в игре критически важно использовать качественные обучающие данные от опытных игроков, а не случайных участников
- Простые эвристики и деревья решений имеют явный потолок возможностей в сложных многоагентных сценариях, требуя перехода к глубокому обучению
- Система должна иметь встроенные ограничения (на скорость решений, пропускную способность, ресурсы), чтобы быть реалистичной и сбалансированной для противостояния с игроками
Сеть, получив новую порцию обучающих данных, поняла, что можно больше не стараться, и забыла все свои навыки, кроме удара во фланг.
Оригиналы:Как правильно убивать игроков в играх
Тест Devin: автономный ИИ-инженер на реальном проекте Telegram-бота
ИИ и агенты · Habr · 8/10
Обзор бесплатной версии Devin — позиционируемого Cognition AI как полноценного автономного ИИ-инженера, который способен самостоятельно планировать, писать, отлаживать и деплоить код. Разработчик Zavur из Selectel провел практический тест: поручил Devin создать сервис «Cheap Flights Alert» с Telegram-ботом для уведомлений о дешевых авиабилетах, веб-панелью настроек маршрутов и ценовых порогов. Devin Desktop — это переименованная среда Windsurf, которую Cognition приобрела в 2025 году за ~250 млн долларов; интерфейс четко разделен на режимы Editor (как VS Code с ИИ-чатом) и Agent (канбан-доска параллельных фоновых задач).
Агент автоматически составил 10-пунктовый план, провел поиск доступных бесплатных API (Aviasales, Skyscanner, Kiwi, Travelpayouts), выбрал стек: FastAPI + PostgreSQL для бэкенда, React для фронтенда, APScheduler для планировщика проверок (раз в 4 часа).
Проект упакован в Docker с готовым docker-compose и README. Агент ввел упрощения: авторизацию через Telegram ID вместо OAuth, фиксированный диапазон дат вместо гибкого ±3 дня. На бесплатном тарифе доступна только модель SWE-1.6 Slow; платные подписки открывают более быстрые версии.
Процесс решения занял ~20 минут на подготовку и планирование, что напоминает контроль работы junior-разработчика: агент аргументирует решения, ищет информацию, корректирует план на ходу.
Выводы автора:
- Devin действительно функционирует как автономный агент: самостоятельно планирует архитектуру, ищет информацию, выбирает стек и пишет готовый к развертыванию код без постоянного участия пользователя.
- Разделение интерфейса на режимы Agent (фоновые задачи) и Editor (традиционная IDE) отражает принципиально иную философию: не помощник рядом, а личный разработчик, работу которого контролируешь удаленно.
- Агент склонен к рациональным упрощениям архитектуры (простая авторизация, фиксированные диапазоны дат вместо гибких), что снижает сложность и потенциальные точки отказа, но может не соответствовать идеальному дизайну.
В Devin процесс больше напоминает контроль за работой джуна: он аргументирует свои решения, ищет информацию, на ходу правит план, а вы просто наблюдаете за логом сессии.
Оригиналы:На что способен бесплатный Devin: тест на реальном проекте
Почему RAG-система зависит от качества модели embedding
ИИ и агенты · ByteByteGo · 8/10
Материал разбирает критическую роль модели embedding (модели преобразования текста в векторы) в RAG-системах (Retrieval-Augmented Generation). Embedding-модель отвечает за поиск релевантных документов и работает независимо от языковой модели, которая генерирует ответ. Даже если языковая модель отличного качества, плохой embedding приведёт к неправильным ответам – система может уверенно ответить «да» на вопрос о возврате подписки через 45 дней, если политика разрешает возврат только в течение 30 дней.
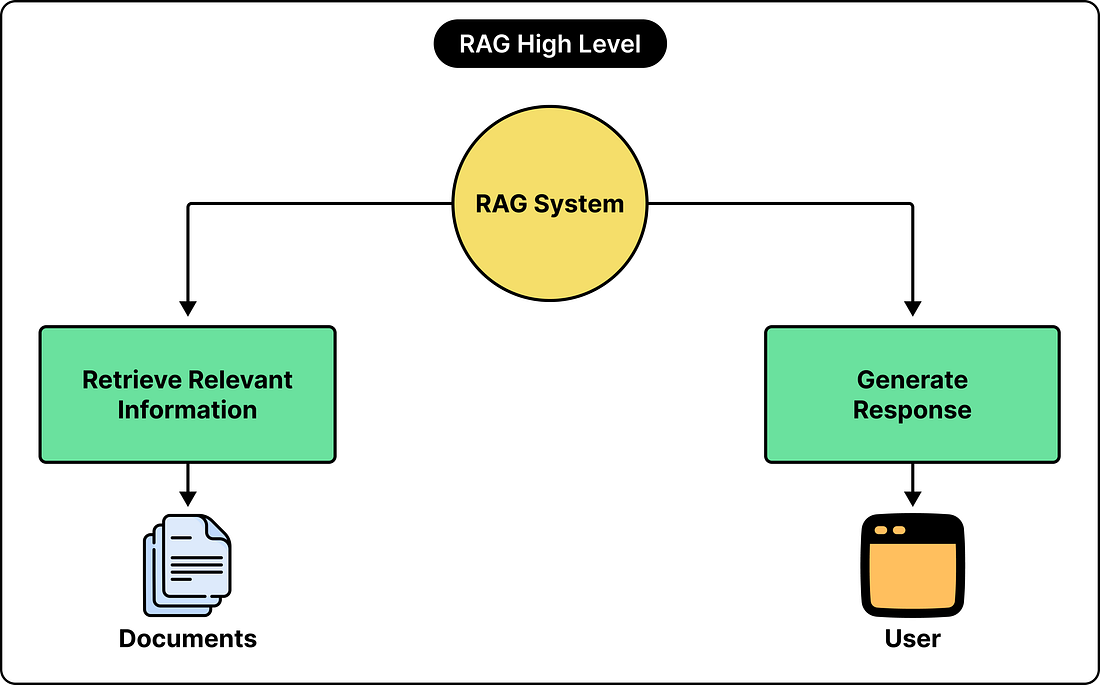
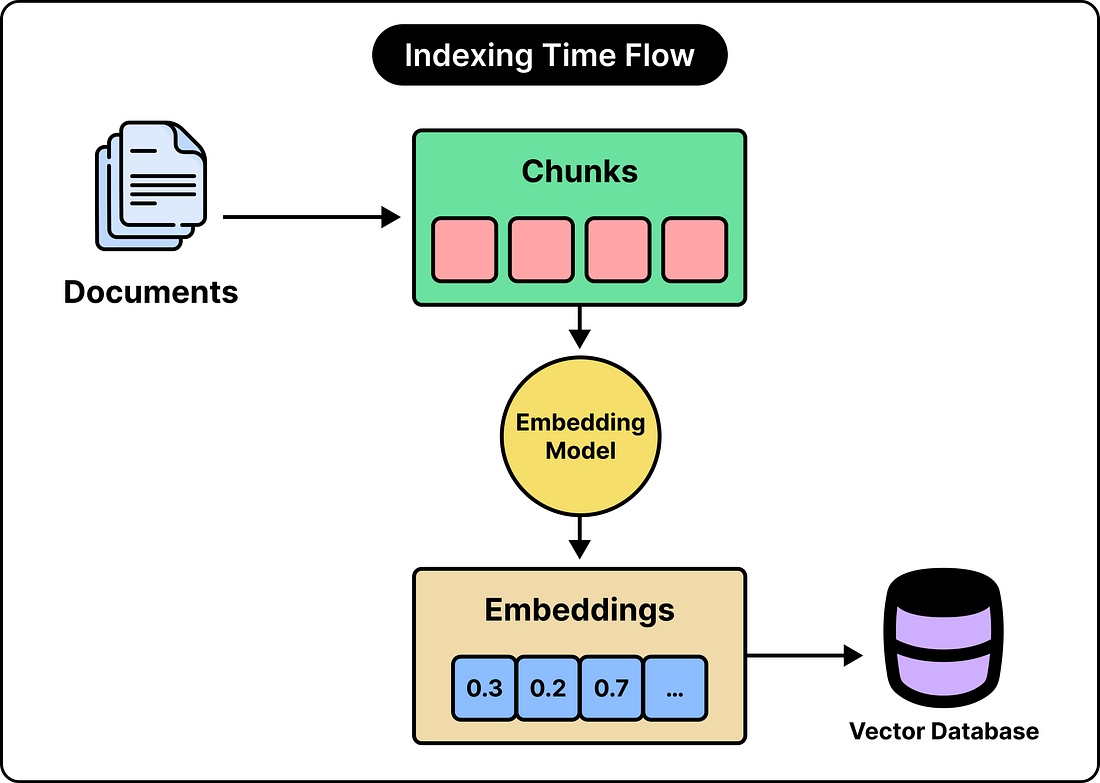
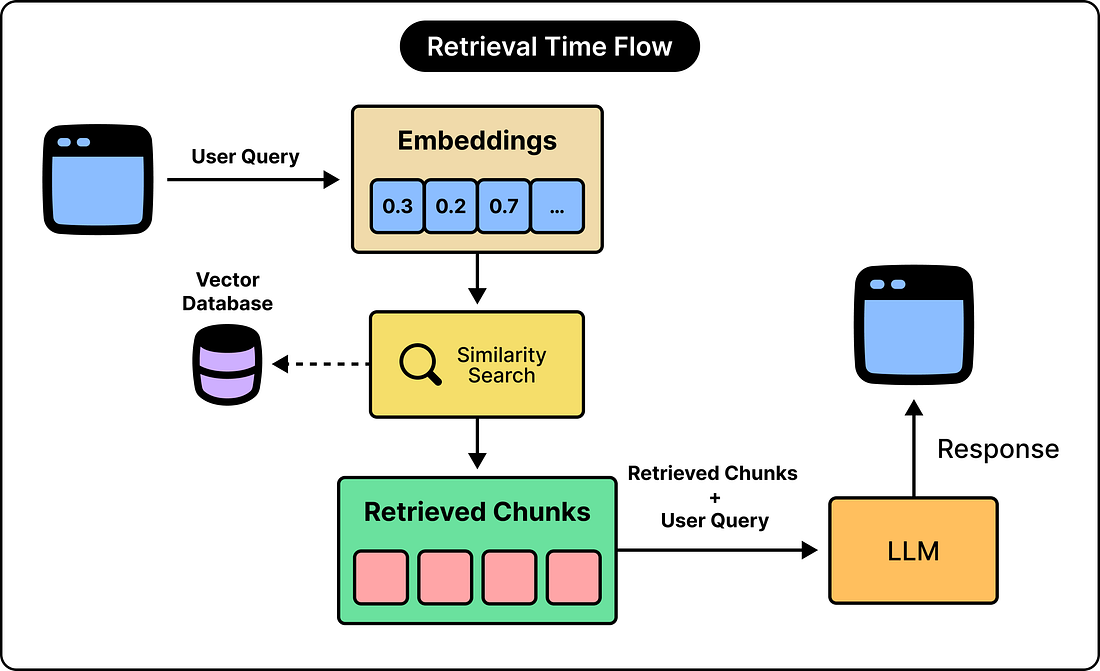
RAG работает в две фазы: индексирование (разбиение документов на чанки и преобразование их в векторы) и поиск (преобразование вопроса в вектор и поиск ближайших чанков).
Embedding-модель должна находить не просто семантически похожую информацию, а документы, которые действительно отвечают на вопрос. Частые проблемы: похожий предмет, но разный аспект; одинаковые слова, но разные сущности; отрицания; устаревшие версии документов; различия в одном числе; специфичная терминология.
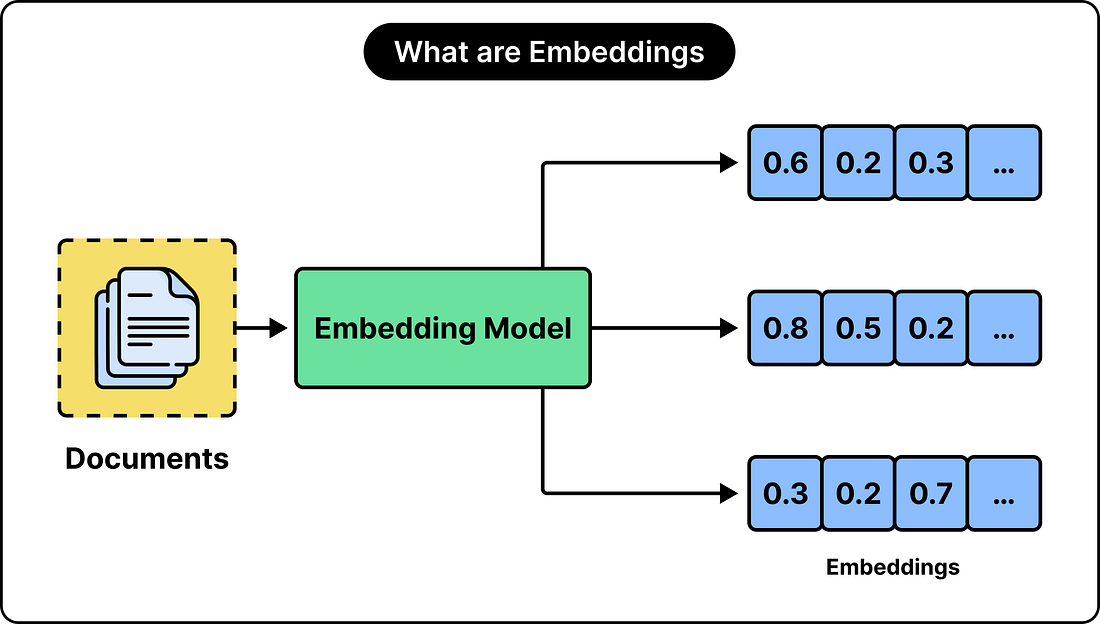
Лучшая языковая модель не может компенсировать плохой поиск – если нужный документ не найден, модель либо ответит из общих знаний, либо придумает ответ. Выбирать embedding нужно по производительности поиска, с учётом домена, мультиязычности, размера векторов, скорости работы. Критично: менять embedding-модель после запуска дорого, так как каждая модель создаёт собственное векторное пространство, несовместимое с другими.
Выводы автора:
- Embedding-модель – критический компонент RAG, она определяет качество поиска информации и напрямую влияет на корректность ответов системы
- Плохой поиск невозможно исправить улучшением языковой модели или промпта – нужно решать проблему на этапе разработки через тестирование и отладку retrieval
- Выбор embedding-модели нужно делать на основе производительности поиска в вашем домене, а не на основе бенчмарков, и менять модель после запуска становится очень дорого
RAG не помещает всю коллекцию документов в промпт модели. Фаза поиска превращает тысячи отрывков в небольшой набор для языковой модели.
Оригиналы:Why Your RAG System Is Only as Good as Its Translator Model · ByteByteGo
Как спроектировать домашнюю проводную сеть перед ремонтом
Разработка и архитектура · Habr · 8/10
Статья — практический гайд по планированию и монтажу локальной сети в квартире перед ремонтом, написанный сетевым инженером на основе собственного опыта. Автор решил подключить три телевизора, два компьютера и игровую приставку проводным кабелем, оставив Wi-Fi для мобильных устройств, чтобы избежать проблем с перегрузкой сети (как произошло в предыдущей квартире). В материале разъясняются основные компоненты домашней сети: роутер, коммутатор, патч-панель, витая пара и сетевые розетки. Автор подробно описывает свой подход: подсчёт стационарных потребителей, выбор места для телекоммуникационного шкафа в гардеробной, планирование кабельных трасс в Microsoft Visio, выбор правильного кабеля (Cat 5e против дорогостоящих вариантов) и схему подключения всех устройств. В статье приводятся поучительные истории коллег: один сэкономил на дополнительной линии до телевизора, что привело к необходимости замены Wi-Fi модуля через несколько лет; другой переплатил за избыточно дорогой кабель без расчёта фактических потребностей. Материал ориентирован на людей без глубоких знаний сетевых технологий, готовящихся к ремонту и желающих правильно спроектировать сетевую инфраструктуру.
Выводы автора:
- Каждое стационарное устройство должно иметь отдельную кабельную линию с розеткой, чтобы при выходе Wi-Fi модуля можно было переключиться на проводное соединение.
- Выбор кабеля (например, Cat 5e) должен основываться на расчёте длины линий и реальных потребностях, а не на запасе под будущие технологии.
- Телекоммуникационный шкаф с патч-панелью и коммутатором позволяет организовать постоянные кабельные линии в одном месте, а не раскидывать подключения по квартире.
Никто не посчитал длину линий, требуемую скорость и характеристики остального оборудования. На коротких квартирных трассах длиной до 30 метров по кабелю Cat 5e может работать даже 10-гигабитное соединение.
Оригиналы:Как я подключил три телевизора, два компьютера и приставку к одному кабелю интернет-провайдера
h3llo.cloud: год разработки облака, AI Ops и провалы на рынке
Разработка и архитектура · Habr · 8/10
Российский облачный провайдер h3llo.cloud делится подробным разбором своего первого года в production после выхода из беты. Компания из 20 человек рассказывает о критических инцидентах в феврале: проблемы с миграцией Managed БД при внедрении Kube-OVN и перегрузка IPAM при массовом развёртывании машин для AI-кодинга курса. Ключевой успех — внедрение AI Ops в марте: автоматизация тикетов через LLM-агенты с строгими фильтрами и собственным MCP-сервером, что обеспечило 26% экономии рабочего времени и решение 80–90% рутинных задач. Попытка B2B-продаж корпоратам провалилась: формальный скоринг отвергал стартап из-за убытков при огромных инвестициях в оборудование. Компания переориентировалась на партнёрскую модель через DevOps-студии и системных интеграторов, параллельно разрабатывая автоматизацию миграции из вендор-локов конкурентов. В планах — Serverless-платформа (сентябрь), AI-платформа с OpenAI/Anthropic совместимостью (октябрь), AI Ops для Kubernetes и SDLC-платформа к концу года.
Выводы автора:
- Правило 32x: неудачное решение AI-агентом обходится в 32 раза дороже, чем ошибка человека, поэтому LLM в production требует строгой фильтрации и контекста, а не безконтрольного развёртывания.
- Стартап с легализованным AI-кодингом обгоняет крупную корпорацию из 600 разработчиков (скрывающих ИИ от руководства) на полтора года в roadmap.
- Корпоративные продажи провалились из-за формальных критериев (уставный капитал, убытки), а успех лежит в партнёрской модели через доверенных DevOps-студий, так как клиент доверяет рекомендации системного интегратора больше, чем прямому стартапу.
Пускать LLM в прод бесконтрольно — самоубийство. Правило 32x: неуспешно решённый агентом тикет обходится в 32 раза дороже, чем если бы туда изначально полез человек.
Оригиналы:Что там с последним коммерческим облаком в России (и как мы лажали этот год)
Крах Digital Equipment: как консервативность погубила конкурента IBM PC
Разработка и архитектура · Habr · 8/10
Статья рассказывает о провале Digital Equipment Corp (DEC) в борьбе за рынок персональных компьютеров в начале 1980-х годов, несмотря на её предшествующий успех и авторитет среди компьютерных энтузиастов. Кен Олсен, основатель и глава DEC, долгие годы отвергал идею персональных компьютеров, веря только в системы разделения времени; это решение стоило компании бесценного времени на рынке. Когда Олсен в 1980 году неожиданно передумал, DEC запустила одновременно три конкурирующих проекта (Professional, DECMate II и Rainbow) с неясной стратегией, требовавшие собственного производства всех компонентов и полностью разработанные только к маю 1982 года, на девять месяцев позже IBM PC. Внутренняя конкуренция между проектами парализовала разработку необходимого программного обеспечения, а запутанная линейка продуктов отпугивала потребителей и разработчиков.
Rainbow стал самым успешным из трёх с 23 тысячами проданных единиц в год, но лишь половинной совместимостью с IBM PC программным обеспечением, что оказалось недостаточно. Вложив около 900 миллионов долларов в три программы персональных компьютеров, DEC практически ничего не получила взамен. В отличие от Олсена, руководство IBM было готово отказаться от традиционной корпоративной культуры и адаптироваться к новому рынку.
Выводы автора:
- Стратегическая ошибка лидера (Олсена) в непризнании рынка персональных компьютеров на протяжении всех 1970-х годов стоила Digital Equipment Corp доминирующей позиции на зарождающемся рынке.
- Одновременный запуск трёх конкурирующих проектов без единой стратегии и настойчивое требование собственного производства всех компонентов привели к невозможности уложиться в сроки и создать конкурентоспособный продукт.
- IBM добилась успеха благодаря готовности руководства отказаться от традиционной корпоративной культуры и адаптироваться к новому рынку, в то время как DEC оставалась скована внутренними конфликтами и неправильными приоритетами.
Кен был единственным управляющим, по факту королём всех проектов ПК. Катастрофу с персональными компьютерами я целиком возлагаю на него.
Оригиналы:Прибытие IBM PC, часть 2: Цунами
Аудит биометрических замков: от скрепки к микросхемам
Кибербезопасность · Habr · 8/10
Статья разбирает методологию базового аудита аппаратной безопасности на примере трёх биометрических замков стоимостью от 1000 до 2500 рублей. Автор Денис Астафиев, ведущий специалист по аппаратным исследованиям компании Бастион, демонстрирует, как безопасность устройства определяется не самой навороченной функцией, а самым слабым звеном. Исследование следует принципу «от простого к сложному»: сначала проверяются документация, логические уязвимости и стандартные сценарии, только потом — сложные атаки на биометрию. В логическом векторе выявлены критические проблемы: безымянный замок имеет заводской аварийный код 33, указанный в инструкции, PS-Link хранит неизменяемый код 67, открываемый перебором за несколько часов. ABUS Touch реализован аккуратнее, требуя двойной авторизации для сброса. В механическом векторе безымянный замок открывается обычной канцелярской скрепкой через shimming-атаку (использование тонкого предмета в зазор между дужкой и корпусом). PS-Link уязвим после откручивания одного винта — доступны провода моторчика. Только ABUS Touch показал стойкость к быстрым атакам из подручных средств. Вывод: даже если начинка устройства умная, реальная стойкость замка определяется его самым слабым звеном — в данном случае часто механикой или логикой, а не биометрией.
Выводы автора:
- Безопасность устройства определяется не самыми сложными компонентами, а самым слабым звеном: дешёвые замки открываются скрепкой или перебором кода вместо взлома биометрии
- Функции удобства (аварийные коды, восстановление доступа) часто становятся критическими уязвимостями, если реализованы без должной защиты
- Audit аппаратной безопасности должен начинаться с логических и механических векторов атаки, прежде чем переходить к сложным методам вроде анализа микросхем
Начинка замка может быть сколь угодно умной, но если он открывается скрепкой, его реальная стойкость определяется именно этой скрепкой, а не качеством сканера биометрии.
Оригиналы:Биометрия против скрепки: разбираем замки с отпечатком пальца и проводим базовый аудит их защиты · Информационная безопасность
Цифровой рубль становится доступен гражданам России с 1 сентября 2026
Финтех и финансы · Habr · 8/10
С 1 сентября 2026 года в России начинает работать цифровой рубль — третья форма национальной валюты наряду с наличными и безналичными средствами, эмитируемая Банком России. Кошельки открываются через приложения 12 системно значимых банков (Сбербанк, ВТБ, Альфа-банк и др.), при условии согласия через «Госуслуги». На Android доступна функция открытия кошелька, для iOS решение ещё ищется. Кошельки привязаны к платформе Банка России, что позволяет получать доступ через любой подключённый банк. Лимит пополнения на начальном этапе составляет 300 тыс. рублей в месяц; кредиты и проценты на остаток не предусмотрены. Платежи совершаются через QR-коды, переводы возможны по номеру телефона. Крупные ретейлеры (Вкусвилл, Магнит, Лента, М.видео) и маркетплейсы (Wildberries, Ozon) готовы принимать платежи. Комиссия эквайринга составит 0,3% (макс. 1,5 тыс. рублей) с 1 января 2027 года. Использование полностью добровольно; система защищена криптографией и антифрод-механизмами, как у обычных операций.
Выводы автора:
- Цифровой рубль независим от конкретного банка и размещается на платформе Банка России, что снижает риск потери доступа при закрытии банка
- Основное преимущество для бизнеса — снижение затрат на эквайринг по сравнению с СБП (0,3% против 0,4%)
- Перспектива развития лежит не в замене карт и СБП, а в появлении умных платежей и коммерческих смарт-контрактов
Цифровой рубль должен стать ещё одним инструментом для платежей и переводов, позволяющим меньше зависеть от ограничений, устанавливаемых банками.
Revolut AIR против bunq Finn: битва ИИ-ассистентов в европейском банкинге
Финтех и финансы · Linas from Linas's Newsletter · 8/10
Revolut запустила свой ИИ-ассистент AIR по всей Европе, начиная с Германии и Австрии, вступив в прямую конкуренцию с более зрелым решением bunq Finn, которое с 2023 года обрабатывает 97% объема поддержки на 38 языках. Хотя по операционным метрикам bunq выглядит впереди, реальное конкурентное преимущество Revolut заключается в архитектуре, построенной под AIR, и кроссселл-потенциале благодаря 80 миллионам пользователей и 11 линиям бизнеса с доходом выше £100 млн, которые bunq структурно не может реплицировать. Запуск Revolut Research на прошлой неделе напрямую связан с расширением в ЕС и демонстрирует интегрированный подход к AI-первому банкингу. Параллельно Grok Bot запустил агентные покупки через интеграцию со Stripe Link, который генерирует одноразовые карты, невидимые для самого ИИ-агента, что отражает стратегию управления рисками, а не упущение функциональности. Различия в подходах Google и SpaceXAI к агентному ИИ указывают на растущую роль платёжных интеграций в экосистеме ИИ-агентов.
Выводы автора:
- Revolut AIR конкурирует не с Starling, а с bunq Finn, но структурные преимущества Revolut (масштаб пользователей и диверсификация доходов) компенсируют отставание в зрелости ассистента
- Stripe Link становится ключевым инструментом для ИИ-агентов, предоставляя одноразовые карты и управляя рисками через требование подтверждения человеком для каждого платежа
- Интеграция Research и AIR показывает, что успех в агентном AI зависит от системного подхода, а не от отдельных компонентов
Finn обрабатывает 97% объема поддержки на 38 языках и является, возможно, самым зрелым ИИ-ассистентом в европейском банкинге, но реальное преимущество Revolut лежит в архитектуре, которую bunq просто не может реплицировать.
Оригиналы:Revolut AIR запускается по Европе · Достаточно ли мы оптимистичны в отношении Revolut? · ИИ-ассистент Revolut
Коротко
Разработка и архитектура
- OpenKylin 3.0: китайская Linux-ОС с ИИ-агентами и поддержкой ARM/RISC-V – Вышла версия 3.0 китайской настольной операционной системы OpenKylin с открытым исходным кодом на базе Linux, разработанная Китайской электронной корпорацией при участии сотен орга
- ПАК помогает бизнесу экономить до 40% на IT-инфраструктуре – Материал анализирует восприятие российских программно-аппаратных комплексов (ПАК) в финансовом секторе, опровергая миф об их чрезмерной дороговизне.
- Быстрая передача файлов между ПК через прямое подключение Ethernet – Материал описывает практический способ подключения двух компьютеров напрямую через патч-кабель Ethernet для высокоскоростной передачи файлов без промежуточного оборудования.
Финтех и финансы
- Малые банки должны срочно модернизироваться под новые требования – Материал анализирует вызовы, стоящие перед малыми и средними банками (МСБ) в условиях ожидаемого роста кредитования.
- Банк России утвердил новые критерии статуса квалифицированного инвестора – Банк России издал Указание № 7402-У, устанавливающее требования к признанию физических и юридических лиц квалифицированными инвесторами на рынке ценных бумаг.
- Банк России отсрочит штрафы операторам платежей до внедрения универсального кода – Банк России издал информационное письмо о временном отказе от применения мер ответственности к операторам по переводу денежных средств.
Продукт и карьера
- VibePM – прототип открытой системы управления проектами на Python – Представлен прототип открытой системы управления проектами VibePM под лицензией AGPLv3, разработанной с помощью DeepSeek.
Прочее
- «Юному технику» — 70 лет истории советского научно-технического журнала – Материал посвящен 70-летию легендарного советского журнала «Юный техник», основанного в сентябре 1956 года и ставшего важной частью технического воспитания советского поколения.
- Как собрать домашний NAS из старого корпуса и деталей с Авито – Инженер из компании «Флант» описывает процесс сборки компактного домашнего NAS путём модификации старого компьютерного корпуса.
- Энтузиасты припаяли кабели питания RTX 5090 напрямую к плате – Бразильская команда TecLab провела эксперимент по решению проблемы перегрева и оплавления разъёмов питания на флагманских видеокартах Nvidia GeForce RTX 5090.